Inteligență artificială23 apr. 2026
Google lansează AI Hypercomputer, combinând TPU-uri de generația a 8-a, NVIDIA Rubin și procesoare Axion pentru a sprijini era AI agentic - Inovațiile tehnologice promit îmbunătățiri semnificative în performanță și eficiență
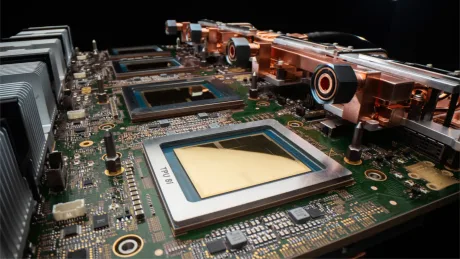
Google își extinde oferta de infrastructură AI către un model „hibrid” (TPU propriu + GPU NVIDIA), prin AI Hypercomputer , o arhitectură de centru de date care combină TPU-uri de generația a 8-a, procesoare Axion și viitoarele acceleratoare NVIDIA Rubin, potrivit Wccftech . Miza operațională este flexibilitatea: clienții pot rula antrenare și inferență (execuția modelului în producție) pe hardware diferit, în același „pachet” de infrastructură, ceea ce poate reduce costul total de operare și timpul de implementare pentru proiecte AI la scară mare. Ce este AI Hypercomputer și de ce contează pentru clienți AI Hypercomputer este prezentat ca un ansamblu integrat de hardware (calcul, stocare, rețea) și software deschis (framework-uri și motoare de inferență), construit pentru „AI agentic” – sisteme care pot executa sarcini în lanț, cu un grad mai mare de autonomie, și care cer atât capacitate mare de antrenare, cât și latență redusă în producție. Din perspectiva utilizatorilor de cloud, elementul practic este că Google încearcă să ofere o infrastructură „cap-coadă” pentru AI, în care: TPU-urile proprii acoperă antrenarea și inferența pe platforma Google; GPU-urile NVIDIA rămân o opțiune majoră pentru clienții care preferă ecosistemul NVIDIA; rețeaua și stocarea sunt optimizate pentru a susține clustere foarte mari. TPU 8t și TPU 8i: două cipuri, două sarcini Google își împarte TPU-urile de generația a 8-a în două variante: TPU 8t (antrenare) : este descris ca un cip orientat spre antrenarea modelelor mari, cu o capacitate totală de calcul FP4 de 121 exaflopși per „pod” , menționată ca fiind de 2,84 ori peste Ironwood. Un „superpod” TPU 8t poate scala la 9.600 de cipuri și 2 PB (petabytes) de memorie partajată cu lățime mare de bandă. TPU 8i (inferință) : orientat spre rularea modelelor în producție, cu 288 GB HBM (memorie cu lățime mare de bandă) și 384 MB SRAM pe cip , adică o creștere de 3 ori față de generația anterioară. Pentru calcul, este indicată o capacitate FP8 de 331,8 exaflopși per pod , menționată ca fiind de 6,74 ori peste Ironwood. Publicația notează și îmbunătățiri „performanță per dolar” față de Ironwood („TPUv7”): 2,7 ori pentru TPU 8t în antrenare la scară mare și +80% pentru TPU 8i în inferență cu latență redusă (ținte MoE – „Mixture of Experts”, o arhitectură de model). Ambele ar livra și de două ori mai bună „performanță per watt”, relevantă pentru costul total de operare (TCO). Rețea, stocare și răcire: infrastructura din jurul cipurilor Pentru scalare, Google introduce Virgo Network , o rețea optimizată pentru AI, menită să conecteze atât sisteme NVIDIA Vera Rubin NVL72, cât și superpoduri TPU 8t în clustere foarte mari. Pe partea de stocare, sunt menționate: Managed Lustre cu 10 TB/s către A5X sau TPU 8t prin RDMA; Rapid Storage, cu un salt de la 6 TB/s la 15 TB/s . La nivel fizic, TPU-urile sunt proiectate să funcționeze cu răcire cu lichid de generația a 4-a , pentru densități de calcul care nu ar fi sustenabile cu răcire pe aer. Unde intră NVIDIA Rubin și Axion în ecuație Google afirmă că va fi „printre primii” furnizori care oferă NVIDIA Vera Rubin NVL72 , alături de instanțe bazate pe Blackwell și Hopper deja disponibile. În paralel, compania își împinge propriile procesoare Axion (Arm), inclusiv instanțele N4A, despre care sursa spune că ar livra 100% mai bun raport preț–performanță decât alternative x86 comparabile. Cine ar urma să folosească platforma Wccftech enumeră câțiva clienți pentru AI Hypercomputer, între care US DOE (Departamentul Energiei al SUA) , Boston Dynamics , Citadel Securities , Thinking Machine Labs și Axia Energy . Materialul nu oferă detalii despre dimensiunea contractelor sau calendarul implementărilor. [...]