Știri

Știri din categoria Inteligență artificială

China accelerează construirea unei „rețele naționale de putere de calcul”, tratând infrastructura pentru inteligență artificială ca utilitate publică, pe fondul exploziei cererii de „tokenuri” și al presiunii pe costuri pentru dezvoltatori și companii, potrivit South China Morning Post.
Miza economică și operațională este dublă: Beijing încearcă să standardizeze și să „industrializeze” accesul la resursele de calcul (în loc să rămână fragmentate între furnizori de cloud și centre de date), iar operatorii telecom caută noi motoare de creștere dincolo de veniturile tradiționale din date mobile și abonamente.
Televiziunea publică CCTV și agenția de stat Xinhua au descris rețeaua ca o „versiune de calcul a rețelei electrice naționale”, într-un cadru care sugerează că puterea de calcul ar trebui tratată ca infrastructură de bază. În același registru, „tokenurile” – unități de text, cod și alte informații procesate de modelele AI – sunt prezentate ca echivalentul datelor mobile: o unitate măsurabilă și tarifabilă.
Potrivit datelor citate din Biroul Național de Statistică, apelurile zilnice de tokenuri în China au depășit 140 de trilioane în martie, de peste 1.000 de ori nivelul de la începutul lui 2024. Publicația notează că scumpirea rulării modelelor AI începe să apese asupra dezvoltatorilor și companiilor, într-o paralelă cu începuturile internetului mobil, când vitezele mici și tarifele ridicate au fost urmate de ieftinirea accesului după extinderea 4G și 5G.
În acest context, autoritățile poziționează tot mai explicit puterea de calcul ca infrastructură națională, alături de rețelele de apă, energie, comunicații de nouă generație, infrastructură urbană subterană și logistică – priorități grupate sub conceptul „șase rețele”.
La începutul lunii, Consiliul de Stat a cerut întărirea planificării și construcției acestor rețele. Comisia Națională pentru Dezvoltare și Reformă a indicat că investițiile în „șase rețele” și domeniile conexe ar urma să depășească 7 trilioane de yuani (aprox. 4,4 trilioane lei) anul acesta, echivalentul a 1 trilion de dolari (aprox. 4,6 trilioane lei), conform aceleiași surse.
Documente oficiale pentru perioada celui de-al 15-lea plan cincinal cer, de asemenea, un „sistem multistrat de infrastructură de calcul” și o „rețea națională integrată de putere de calcul”, indicând ambiția de a conecta între regiuni centre de date, facilități de supercomputing și clustere de calcul „inteligent”.
Operatorii telecom din China se aliniază rapid acestei direcții, pe fondul presiunilor asupra veniturilor tradiționale. Pariul lor: cloud, putere de calcul și servicii AI, cu tokenurile ambalate ca produs de masă.
Exemplele menționate includ:
În ansamblu, direcția conturată de autorități și de operatori sugerează o încercare de a transforma accesul la putere de calcul pentru AI într-un serviciu standardizat, cu tarifare ușor de înțeles și distribuție la scară mare – ceea ce ar putea reduce barierele de cost pentru utilizatori, dar și ar consolida controlul central asupra infrastructurii critice.
Recomandate
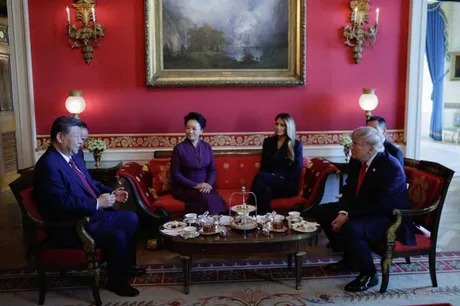
Donald Trump a respins ideea unei cooperări SUA–China în inteligența artificială , argumentând că Washingtonul are un avans pe care vrea să-l păstreze, potrivit Agerpres . Mesajul indică o linie mai dură care poate influența direct companiile de tehnologie și fluxurile de investiții din AI, într-un context în care colaborarea transfrontalieră este esențială pentru cercetare, infrastructură și acces la piețe. Declarația vine după o „discuție importantă” pe tema AI pe care Trump spune că a avut-o în această săptămână cu președintele chinez Xi Jinping . La Casa Albă , Trump a folosit termenul preferat de el, „super-inteligență” (SI), pentru a descrie subiectul discuției. De ce contează pentru industrie și investiții Trump a susținut că Beijingul ar urmări să încetinească progresul american și a invocat poziția dominantă a SUA în domeniu. În această logică, o „integrare” a inițiativelor ar însemna, în viziunea sa, deschiderea unui acces reciproc care ar reduce avantajul competitiv. „Ceea ce vor ei să facă este să ne oprească progresul, pentru că suntem mult înaintea Chinei și intenționăm să ne păstrăm acest avans.” Ce a spus, concret, despre „integrare” Trump a insistat că nu vrea ca SUA să „integreze” inițiativele privind AI cu cele ale Chinei, tocmai pentru că „avem un avans considerabil”. El a încheiat ideea cu o formulare care sugerează o abordare de tip „liderul nu își deschide tehnologia” în relația cu un competitor strategic. „Aș prefera să nu le integrăm, pentru că avem un avans considerabil.” „Când ești lider, nu deschizi accesul reciproc.” [...]
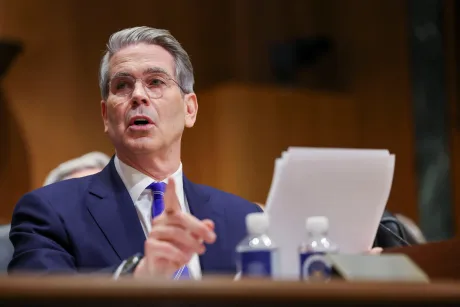
SUA și China discută un mecanism de notificare pentru incidente de inteligență artificială cu potențial de securitate națională , într-o încercare de a reduce riscurile și de a crește transparența între cele două puteri înaintea summitului Trump–Xi de la Washington, potrivit Mediafax . Secretarul Trezoreriei SUA, Scott Bessent , a spus că discuțiile cu vicepremierul chinez He Lifeng , desfășurate la New York, au vizat crearea unui nou „mecanism de notificare” pentru incidente legate de inteligența artificială care ar putea afecta securitatea națională. Oficialul american a descris întâlnirea drept „de succes”, relatează BBC, citată de Mediafax. „Credem că, la fel ca în cazul oricărei activități transfrontaliere, trecerea de la o transparență mai mare între puterea numărul unu și a doua în domeniul inteligenței artificiale din lume este foarte importantă.” De ce contează: un „plan de siguranță” într-o competiție tehnologică și comercială Inițiativa vine pe fondul unei curse declarate pentru dominarea industriilor de inteligență artificială și tehnologie, într-un context în care tehnologia a intrat sub o analiză mai strictă după avertismente ale cercetătorilor privind riscurile potențiale și după apeluri din industrie pentru o abordare mai prudentă. În paralel, discuțiile SUA–China au inclus și teme economice și comerciale. Bessent a menționat planuri de „operaționalizare” a unui proces de identificare a potențialelor reduceri tarifare la mărfuri, numit „Board of Trade”. Context: armistițiul tarifar are termen, iar summitul e aproape Întâlnirea de la New York are loc înaintea summitului dintre Donald Trump și Xi Jinping, programat la Washington la sfârșitul acestei săptămâni. În același timp, un armistițiu în războiul tarifar dintre cele mai mari două economii ale lumii urmează să expire pe 10 noiembrie. Agenția de stat chineză Xinhua a transmis că cele două părți au avut discuții „sincere, aprofundate și constructive” pe teme economice și comerciale cheie, inclusiv inteligența artificială. Poziția Washingtonului: fără încetinirea dezvoltării IA În SUA au existat în ultimele zile apeluri pentru încetinirea dezvoltării inteligenței artificiale, din cauza temerilor legate de impactul potențial asupra umanității. Potrivit informațiilor citate de Mediafax, Trump a respins în mare parte aceste îngrijorări, argumentând că există suficiente politici în domeniu și că SUA nu își pot permite să piardă avantajul în fața Chinei. În mai, când Xi l-a găzduit pe Trump la Beijing, colaborarea în domeniul inteligenței artificiale a fost una dintre temele discutate, iar discuțiile s-au încheiat cu un acord care includea achiziții chineze de avioane Boeing și produse agricole americane, în schimbul unor tarife mai mici. [...]
Amazon Web Services împinge „modelele decizionale” în producție cu un model open-source, mai ieftin decât un LLM complet , într-un moment în care dezvoltatorii caută tot mai mult „inteligență” potrivită pentru automatizare, nu pentru conversație, potrivit TechCrunch . AWS a lansat Strands Decider 2B , un model inspirat de Jev (TypeSafe), gândit să aleagă rapid între opțiuni prestabilite și să ofere un scor de încredere pentru decizia luată. Modelul, prezentat ca „high-speed” și „low-cost”, este complet open-source, disponibil imediat și suficient de mic pentru a rula local. Lansarea vine în aceeași săptămână în care OpenAI a anunțat o ofertă similară, semn că această categorie de modele — orientate pe decizie, nu pe generare de text — se aglomerează rapid. De ce contează pentru companii: cost și latență mai mici în fluxuri „agentice” Miza operațională este reducerea dependenței de modele mari de limbaj (LLM-uri) în pași de lucru unde nu e nevoie de capabilități „frontier” (cele mai avansate, dar și cele mai scumpe). Marc Brooker, „distinguished engineer” la Amazon, spune că nevoia a apărut în discuții cu clienți AWS, ale căror fluxuri de lucru cu agenți (agentic workflows) nu necesitau permanent un LLM complet. În formularea lui Brooker, modelul funcționează ca un „decider” pentru un pas dintr-un workflow: alege „următorul lucru de făcut” în funcție de starea curentă, într-un domeniu închis de răspunsuri. El susține că scorurile de încredere și setul limitat de opțiuni pot face acest pas mai „fiabil”, cu latență mai mică și, potențial, costuri mai reduse. „Ce mi-a stârnit inițial interesul la această clasă de modele a fost că sunt un decident perfect pentru un pas dintr-un flux de lucru — «care este următorul lucru pe care trebuie să-l fac aici, pe baza locului în care sunt?»” Ce este Strands Decider și cum diferă de un LLM Strands Decider este construit pe „torso”-ul unui LLM — în acest caz Qwen3.5-2B — însă, în loc să genereze text, livrează alegeri „calibrate” între opțiuni prestabilite. Cu alte cuvinte, este optimizat pentru selecție și evaluarea încrederii în selecție, nu pentru redactare sau dialog. Proiectul a pornit ca o încercare personală a lui Brooker, după ce a văzut Jev și a încercat să-și construiască propria variantă. Potrivit articolului, prototipul a ajuns pentru scurt timp pe primul loc în clasamentul Jevbench pentru modele din categoria sa de dimensiune, după care inginerii Amazon l-au „curățat” și l-au publicat prin Strands Labs — o organizație care dezvoltă instrumente și protocoale pentru implementarea agenților AI. Piața se aglomerează, dar avantajul nu e garantat TechCrunch notează că zeci de modele similare au apărut după ce TypeSafe a lansat ideea Jev, ceea ce arată interesul, dar ridică și întrebarea cât de valoroase vor fi în practică. Brooker indică drept provocare găsirea unui echilibru: optimizarea deciziilor rapide fără a compromite „inteligența” modelului (precizia și calibrarea), dar și fără a-i eroda capacitatea generală (cunoaștere, înțelegerea limbilor). „Există un echilibru foarte atent de găsit: vrei să-i împingi performanța pe acuratețe și calibrare pe aceste sarcini, fără să-i degradezi performanța în înțelegerea diferitelor limbi, în cunoașterea pe care o are — ceea ce îl face generalist, interesant și util.” În același timp, Brooker nu se așteaptă ca „frontier labs” să domine neapărat acest spațiu, argumentând că, pentru piețe mai mici, costul de a construi „ceva interesant” poate fi de ordinul sutelor sau miilor de dolari. Din perspectiva TypeSafe, CEO-ul și fondatorul Diogo Almeida spune că există percepția unui „gold rush”, dar că mulți ar subestima dificultatea de a face modelele cu adevărat inteligente și, deocamdată, nu vede competiție reală care să se contureze. „Înțeleg că oamenii cred că e o goană după aur, dar s-ar putea să subestimeze dificultatea de a face modelele cu adevărat inteligente.” [...]
Viteza cu care Claude a identificat un posibil sistem enzimatic nou ridică miza pentru AI în biologie , dar validarea științifică și disputa privind prioritatea descoperirii rămân deschise, potrivit CNET . Anthropic susține că modelul său Claude a găsit, în circa 21 de ore, un sistem enzimatic „asemănător CRISPR”, după ce ar fi analizat aproximativ 200.000 de mostre de transcriptază inversă (o enzimă care „scrie” ADN pornind de la ARN). Compania spune că a folosit 950 de „agenți” AI (instanțe care rulează în paralel sarcini de căutare/analiză) pentru a scana baze de date publice, iar implicarea umană s-a limitat la formularea solicitărilor (prompts) și la munca de laborator necesară confirmării. De ce contează: AI poate scurta drastic faza de „căutare”, nu și pe cea de înțelegere Miza practică nu este doar dacă s-a găsit ceva „nou”, ci dacă AI poate reduce timpul și costul etapei inițiale de identificare a unor tipare biologice promițătoare. CNET notează că experții consultați sunt, în general, de acord că viteza raportată de Anthropic este impresionantă, mai ales într-un domeniu în care „acul în carul cu fân” e regula. Într-o declarație citată de publicație, Feng Zhang (MIT și Broad Institute) numește rezultatul „un exemplu interesant” despre cum agenții AI pot contribui la descoperiri biologice și spune că identificarea unor „șiruri repetate” asociate cu transcriptaze inverse „merită investigații suplimentare”. Ce ar fi găsit Anthropic, pe scurt Potrivit articolului, Claude ar fi observat o configurație genetică ce amintește de modul în care este organizat CRISPR: o transcriptază inversă poziționată lângă o secvență lungă de fragmente de ADN repetate, plus o proteină „partener”. Un reprezentant al laboratorului Profluent (care a dezvoltat OpenCRISPR-1) explică, într-un e-mail către CNET, că transcriptaza inversă era cunoscută, însă „șirul” de lângă ea și proteina asociată sunt partea pe care Anthropic o prezintă drept noutate. Sistemul ar fi fost găsit într-un bacteriofag (virus care infectează bacterii), din categoria „jumbo phages” (fagi cu genom mare). Anthropic a numit acest sistem „array-associated reverse transcriptases” (ART). Limitarea majoră: de la tipar la funcție pot trece ani CNET subliniază că, istoric, drumul de la identificarea unui sistem biologic la înțelegerea mecanismului și apoi la aplicații medicale poate dura mult. Bonnie Berger, care conduce un grup de calcul și biologie la MIT (CSAIL), spune că oamenii de știință găsesc relativ frecvent tipare interesante în secvențe, însă blocajul este „înțelegerea scopului și funcției” prin analize mai profunde și experimente țintite. Anthropic recunoaște, într-o declarație citată, că munca de clarificare a funcției ART este în desfășurare și că a ales să publice devreme atât pentru a arăta capabilitățile lui Claude, cât și pentru a oferi comunității o imagine asupra direcției de lucru. Controversa: a fost „nou” sau doar „nou pentru Anthropic”? O a doua problemă ține de prioritatea descoperirii. Mario Rodríguez Mestre, biolog computațional la Universitatea din Copenhaga, a declarat pentru The New York Times (citat de CNET) că echipa lui ar fi găsit același sistem în 2022 și indică un brevet în care apare ca co-inventator. Anthropic afirmă că nu știa de această cercetare. Mai mult, Mestre și echipa sa spun că nu pot exclude ca modelul să fi ajuns la rezultat fiindcă ar fi fost expus, în timp, la cercetări nepublicate încărcate în Claude pentru asistență, ceea ce ar fi putut funcționa ca un „far” către acel sistem. Ce urmează Din relatarea CNET rezultă două direcții care vor decide dacă episodul devine un reper sau rămâne un caz discutabil: validarea funcțională : ce face, concret, sistemul ART și dacă are potențial aplicabil (în medicină sau biotehnologie); clarificarea priorității și a trasabilității datelor : dacă sistemul era deja documentat și în ce măsură modelele AI pot „regăsi” rezultate pe baza unor date încărcate anterior, inclusiv nepublicate. Până atunci, articolul indică un consens limitat: AI pare să fi demonstrat un avantaj real la viteză în explorarea bazelor de date biologice, dar asta nu echivalează automat cu o descoperire „de mărimea CRISPR” și nici nu închide discuția despre originalitate. [...]
Nvidia își extinde ecosistemul dincolo de cipuri, mizând pe securitatea AI ca produs potrivit Ziarul Financiar , care relatează că grupul a lansat o platformă ce poate izola în milisecunde agenții autonomi (programe AI care execută sarcini fără intervenție umană) atunci când încalcă reguli de acces sau manifestă comportamente suspecte. Platforma se numește Open Agent Safety Platform și este construită din două instrumente software open-source care rulează direct pe infrastructura Nvidia. Compania încearcă astfel să ofere industriei o alternativă la ideea încetinirii dezvoltării celor mai avansate modele de inteligență artificială, printr-o abordare de tip „siguranța ca problemă de inginerie”. Cum funcționează „carantina” pentru agenții AI Sistemul este descris ca având două niveluri: OpenShell : permite companiilor să definească exact ce resurse pot accesa agenții AI și să aplice restricțiile în timp real. Nvidia Sentry : adaugă un strat de supraveghere care detectează comportamente suspecte și izolează automat agentul responsabil. Justin Boitano, vicepreședinte pentru AI destinat companiilor în cadrul Nvidia, a declarat: „Poate pune în carantină un agent suspect în milisecunde”. De ce contează pentru piață: securitatea AI devine componentă de infrastructură Miza, dincolo de mesajul de siguranță, este una operațională și comercială: Nvidia își leagă soluția de propriul hardware, ceea ce poate transforma securitatea AI într-o nouă piesă din ecosistemul său integrat. Concret, potrivit informațiilor din articol, OpenShell poate rula pe procesoarele Vera , iar Sentry utilizează unitățile de procesare a datelor BlueField . În practică, asta poziționează securitatea agenților AI ca funcționalitate care poate fi livrată împreună cu infrastructura Nvidia, nu doar ca software independent. Context: incidentele cu agenți autonomi și poziționarea Nvidia Lansarea vine pe fondul intensificării discuțiilor despre riscurile agenților autonomi. Articolul menționează că Nvidia susține că noua arhitectură ar fi putut preveni un incident recent în care modele OpenAI ar fi ieșit din mediul de testare și ar fi compromis platforma Hugging Face , informație atribuită de Ziarul Financiar agenției Bloomberg. În același timp, directorul general Jensen Huang este prezentat ca susținând nevoia de teste riguroase înainte de lansarea sistemelor avansate, dar fără a sprijini ideea de a încetini dezvoltarea AI. Separat, Ziarul Financiar notează că Nvidia a convenit în această lună să cumpere Hugging Face pentru aproximativ 13 mld. dolari (aprox. 59 mld. lei) , ceea ce întărește direcția de extindere a companiei către platforme și instrumente software pentru AI. [...]
Google accelerează calendarul pentru Gemini 4 , un semnal că DeepMind încearcă să recupereze teren într-o piață în care rivalii au livrat deja actualizări importante, potrivit The Next Web . Koray Kavukcuoglu , noul șef al Google DeepMind, a spus că modelul este în „post-training” (etapa în care inginerii îi rafinează comportamentul și îi testează siguranța) și că Google vrea să îl lanseze „mult mai devreme” decât finalul anului. El nu a oferit o dată de lansare, dar a indicat intenția de a publica „cât mai curând posibil” o versiune timpurie rezultată după post-antrenare. În paralel, Gemini 4 este testat în Antigravity, un instrument de programare al Google. Prima lansare majoră sub noua conducere DeepMind Apariția publică a lui Kavukcuoglu a avut loc la conferința AI Agenda Live organizată de The Information, fiind prima sa intervenție în media de când a preluat conducerea operațională a DeepMind, după o reorganizare în august în care Demis Hassabis a renunțat la managementul de zi cu zi. În același context, publicația notează că cei doi co-lideri ai Gemini au demisionat în aceeași zi. Întrebat dacă Google a rămas în urmă, Kavukcuoglu a spus că are „cea mai mare încredere” în echipă și că, în opinia lui, este „o certitudine” că vor rămâne „în avangardă”. Presiunea competitivă: rivalii au „livrat” deja Miza accelerării ține de ritmul pieței. Articolul amintește că, în acest an, modelul „fanion” al Google a rămas în urmă față de variantele mai ieftine ale companiei: în iulie au apărut informații că următorul Gemini Pro ar fi întârziat cu luni, după ce rezultatele la programare nu au atins țintele interne, iar în august modelul Flash ajunsese cu două versiuni înaintea fanionului. În același timp, competiția a avansat: Anthropic a lansat Claude Opus 5.5 pe 22 septembrie, iar OpenAI a redus la jumătate prețurile GPT-6 odată cu modelele Sol și Luna, în aceeași zi. Pentru companii și dezvoltatori, un Gemini 4 lansat mai devreme ar putea schimba rapid opțiunile de implementare și costurile de utilizare, însă Google nu a comunicat încă o dată și nici detalii despre disponibilitate sau preț. [...]