Știri

Știri din categoria Inteligență artificială
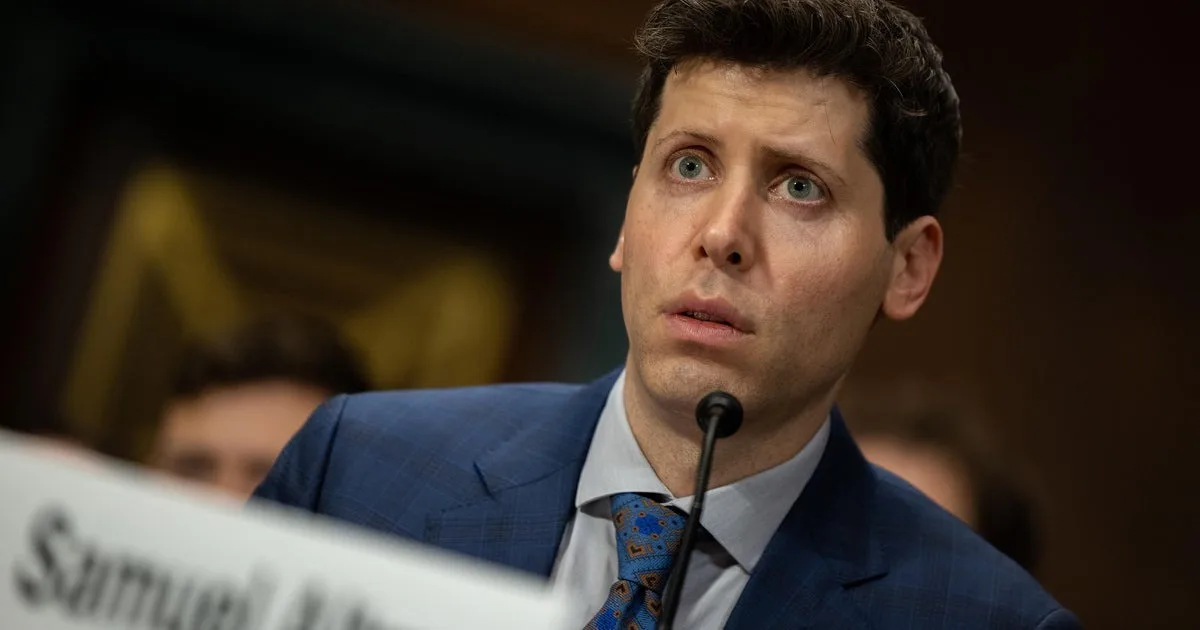
OpenAI modifică acordul cu Pentagonul după reacții globale privind supravegherea prin inteligență artificială, compania condusă de Sam Altman a anunțat că va ajusta contractul recent semnat cu Departamentul Apărării al Statelor Unite, după un val de critici publice, proteste și dezinstalări ale aplicației ChatGPT. Decizia vine în urma temerilor că tehnologia ar putea fi folosită pentru supraveghere în masă sau pentru dezvoltarea unor sisteme militare autonome.
Acordul, încheiat la începutul lunii martie 2026, prevede integrarea modelelor de inteligență artificială dezvoltate de OpenAI în rețele militare clasificate ale Pentagonului. Anunțul a stârnit însă reacții puternice în rândul activiștilor, al utilizatorilor și chiar al unor angajați din industria tehnologică, care au avertizat asupra riscurilor legate de utilizarea AI în scopuri militare sau de monitorizare a populației.
Într-un mesaj publicat pe platforma X, Sam Altman a precizat că firma lucrează cu Pentagonul pentru a adăuga clarificări în contract. Potrivit acestuia, sistemele OpenAI nu vor fi utilizate intenționat pentru supravegherea internă a cetățenilor americani și nici de către agenții de informații precum NSA, decât dacă ar exista modificări contractuale ulterioare.
Altman a recunoscut totodată că modul în care a fost gestionată comunicarea privind acordul a fost greșit. El a admis că s-a grăbit să finalizeze tranzacția și că lipsa explicațiilor clare a alimentat suspiciunile publice. „Problemele sunt extrem de complexe și necesită o comunicare clară”, a scris acesta, sugerând că intenția inițială a fost evitarea unor consecințe considerate mai grave.
Controversa apare într-un moment tensionat pentru industria inteligenței artificiale, în care companiile sunt presate să stabilească limite etice privind utilizarea tehnologiei. Rivala Anthropic, de exemplu, ar fi refuzat un acord similar cu armata americană, insistând asupra unor interdicții explicite legate de supravegherea în masă și de dezvoltarea armelor autonome letale.
Nemulțumirea a depășit rapid mediul online. Proteste au avut loc în fața birourilor OpenAI din San Francisco și Londra, iar un grup de activiști a lansat campania „QuitGPT”, care promovează boicotarea serviciilor companiei. În paralel, aproape 500 de angajați din OpenAI și Google au semnat o scrisoare deschisă în sprijinul unor limite stricte privind utilizarea militară a inteligenței artificiale.
Situația reflectă tensiunea tot mai mare dintre dezvoltarea rapidă a tehnologiilor de inteligență artificială și presiunea publică pentru stabilirea unor reguli clare privind utilizarea lor în domenii sensibile precum securitatea, apărarea și supravegherea.
Recomandate
OpenAI își extinde integrarea în ecosistemul Oracle, cu obiectivul de a aduce aplicațiile și datele Oracle direct în ChatGPT , într-o mișcare care țintește utilizarea AI în operațiuni de bază (finanțe, achiziții, planificare) și simplificarea administrării și a controlului accesului în companii, potrivit OpenAI . Parteneriatul se bazează pe relația comercială existentă dintre cele două companii, care acoperă OpenAI API, ChatGPT Work și Codex. OpenAI notează că Oracle a raportat 130.000 de utilizatori activi ChatGPT și peste 95.000 de utilizatori activi Codex. În același context, echipa de recrutare a Oracle folosește ChatGPT Work pentru cercetare de piață: o activitate care dura anterior între două și patru zile ar ajunge acum să fie pregătită în 15–20 de minute. Integrarea aplicațiilor Oracle în ChatGPT: „agent-ready enterprise” Direcția declarată este un „agent-ready enterprise”, adică un mediu în care angajații și agenții AI (software care poate executa sarcini) lucrează în aplicațiile de business într-un spațiu conectat. Obiectivul este ca software-ul Oracle să fie mai ușor de descoperit, folosit și administrat, cu: administrare simplificată, autentificare unificată, acces guvernat de permisiunile și aprobările fiecărei organizații. Miza operațională, în logica anunțului, este scalarea utilizării AI în activități esențiale și creșterea valorii obținute din aplicațiile deja folosite în companie. Oracle AI Workspace : fluxuri de lucru aprobate, într-un singur loc Oracle dezvoltă Oracle AI Workspace pentru a aduce integrarea în ChatGPT, conectând aplicațiile și datele Oracle. Scopul este ca utilizatorii să poată descrie ce au de făcut, să găsească informația relevantă și să finalizeze fluxuri de lucru de business aprobate, dintr-un singur loc. Ca exemplu, OpenAI descrie un scenariu în care un nou membru al echipei financiare ar putea folosi ChatGPT pentru a investiga costuri, a înțelege decizii de achiziție și a identifica ce mai lipsește înainte de închiderea de lună, cu informații agregate din aplicații de finanțe, achiziții și planificare, în limitele permisiunilor interne. Produse Oracle noi și actualizări construite cu modele OpenAI În paralel cu Oracle AI Workspace, Oracle anunță actualizări și oferte noi construite cu modele și instrumente OpenAI: Oracle AI Security Mesh , gândit pentru identificarea și remedierea vulnerabilităților din aplicații și infrastructură folosind modele de securitate cibernetică ale OpenAI; Oracle ar gestiona infrastructura de testare. Oracle AI SMB Bundle , care combină ChatGPT Business și Codex cu aplicații Oracle și credite recurente pentru Oracle Cloud Infrastructure, pentru a ajuta firmele mici să construiască produse și să-și gestioneze operațiunile. Oracle App Composer , destinat construirii de aplicații cu Codex și alte instrumente AI, conectate la date și fluxuri de lucru Oracle aprobate, cu distribuire internă; implementarea ar fi gestionată pe Oracle Cloud Infrastructure, cu controale de acces incluse. Achiziție prin Oracle Marketplace , pentru clienții din SUA OpenAI precizează că clienții Oracle din SUA pot cumpăra acces la OpenAI API, Codex și ChatGPT Work prin Oracle Marketplace, folosind procesele existente de achiziție și credite eligibile Oracle Universal Credits. [...]
OpenAI taie la jumătate prețul API pentru GPT-6.1 Terra , poziționând modelul ca opțiune de automatizare „la volum” pentru sarcini de birou care combină înțelegere vizuală, utilizare de aplicații și redactare, potrivit OpenAI . GPT-6.1 Terra este prezentat ca un model „rapid și eficient”, cu raționament vizual detaliat și „computer use” (capacitatea de a opera aplicații și fluxuri pe calculator), plus scriere mai naturală. Miza practică, în descrierea companiei, este reducerea costului total pentru automatizarea muncii repetitive: de la citirea facturilor primite și introducerea datelor în software de contabilitate, până la completarea de formulare sau editare video. Ce se schimbă pentru costuri: prețuri API și consum în produse OpenAI afirmă că prețurile standard din API pentru GPT-6.1 Terra sunt cu 50% mai mici decât cele ale GPT-5.6 Terra și GPT-6.1 Sol, ceea ce ar face modelul mai potrivit pentru procese cu volum mare. În paralel, în ChatGPT Work și Codex, compania spune că „același plafon de utilizare” acoperă mai multe sarcini decât în GPT‑5.6 Terra și „substanțial mai multe” decât în GPT‑6.1 Sol sau GPT‑6 Astra. Prețurile standard în API, comunicate de OpenAI, sunt: 1 dolar (aprox. 4,6 lei) per milion de tokeni de intrare; 0,05 dolari (aprox. 0,23 lei) per milion de tokeni de intrare din cache (tokeni reutilizați dintr-o intrare anterioară, pentru cost mai mic); 5 dolari (aprox. 23 lei) per milion de tokeni de ieșire. Performanță operațională: viteză și eficiență pe sarcini „de agent” Pe benchmark-ul Agents’ Last Exam (sarcini profesionale, inclusiv transformarea unor planșe arhitecturale într-un model 3D și analiză cadru cu cadru pentru log cu marcaje de timp), OpenAI susține că: la efort mediu de raționament, GPT-6.1 Terra obține un scor cu 15 puncte procentuale peste GPT-5.6 Terra, la circa o treime din cost; rulează „la nivel” cu GPT-6 Astra la o zecime din prețul per token; la efort maxim, este de peste trei ori mai eficient la tokeni decât Claude Opus 5.5 și costă un sfert per token, ceea ce ar duce la un cost per sarcină de aproximativ 9 ori mai mic; finalizează sarcini de peste trei ori mai repede decât GPT-6 Astra și GPT-6.1 Sol. OpenAI mai indică rezultate mai bune față de GPT-5.6 Terra pe MMMU-Pro (raționament vizual) și pe OSWorld 2.1 (utilizarea aplicațiilor desktop pentru sarcini în mai mulți pași), cu accent pe raportul performanță/cost. Calitate: mai puține erori factuale și salt pe sarcini de programare Compania spune că a investit în reducerea „halucinațiilor” (răspunsuri inventate sau eronate). Pe un benchmark intern de prompturi care induc erori, rata de eroare: a scăzut de la 53,6% (GPT-5.6 Terra) la 16,7% (GPT-6.1 Terra) la efort redus de raționament; a coborât la 4,3% la efort maxim, cu o reducere de 18 puncte procentuale, „aproape” de nivelurile GPT-6 Astra și GPT-6.1 Sol. Pe Terminal-Bench 4.0 (sarcini de inginerie software din linia de comandă), la efort maxim, GPT‑6.1 Terra rezolvă 50,3% dintre sarcini, față de 21,5% pentru GPT‑5.6 Terra (scor publicat). Pentru cele mai complexe sarcini de programare, OpenAI precizează că GPT-6.1 Sol și GPT-6 Astra rămân opțiuni mai bune. Siguranță și disponibilitate OpenAI afirmă că GPT‑6.1 Terra atinge pragul „Critical” în securitate cibernetică în cadrul Preparedness Framework și păstrează protecțiile dezvoltate pentru GPT‑6 Astra. Compania mai susține că modelul este mai predispus să rămână „în scop” (să nu devieze de la cererea utilizatorului), să își recunoască limitările și să reziste la prompt-injection (instrucțiuni malițioase care încearcă să deturneze sarcina). Mai multe detalii sunt disponibile în „system card”-ul dedicat: https://deploymentsafety.openai.com/gpt-6-1-terra (link menționat în sursă). Începând „de astăzi”, GPT-6.1 Terra este disponibil pentru utilizatorii Plus, Pro, Enterprise și Edu în ChatGPT Work și Codex, iar pentru dezvoltatori prin API, sub identificatorul gpt-6.1-terra . [...]
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
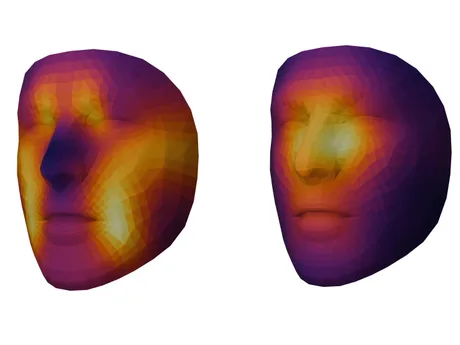
Un model de inteligență artificială poate estima vârsta biologică și riscul de deces la pacienți oncologici dintr-o fotografie facială , însă utilitatea sa clinică reală și limitele de aplicare rămân încă neclare, potrivit Notebookcheck . Tehnologia, prezentată într-un studiu din „ The Lancet Digital Health ”, ridică atât perspectiva unor evaluări medicale cu bariere de intrare foarte mici, cât și întrebări despre validare, interpretabilitate și potențiale utilizări abuzive. Ce face modelul și pe ce date a fost antrenat Cercetătorii au dezvoltat un model numit FAHR-Face (Foundation Artificial Intelligence for Health Recognition), antrenat pe peste 40 de milioane de imagini faciale și adaptat ulterior pentru două sarcini distincte: estimarea „vârstei biologice” din trăsături faciale (care poate diferi de vârsta cronologică și ar putea indica starea generală de sănătate și reziliența fizică); estimarea riscului de supraviețuire la pacienți cu cancer pe baza unei fotografii, cu zone considerate relevante în special sub ochi și de-a lungul punții nasului. Rezultatele raportate pe pacienți cu cancer Evaluarea a inclus aproximativ 43.000 de pacienți oncologici, iar un test separat a fost realizat pe 3.820 de pacienți. În acest test: 122 de pacienți au fost încadrați de model în grupa cu risc maxim; dintre aceștia, 52% au murit în 90 de zile; 975 de pacienți au fost încadrați în grupa cu risc minim; dintre aceștia, 2% au murit în același interval. Autorii notează că asocierea dintre informația extrasă din fotografie și riscul de deces a rămas valabilă chiar și după luarea în calcul a factorilor clinici de prognostic. De ce contează: costuri mici, dar validare incompletă și risc de abuz Miza operațională a unei astfel de abordări este bariera scăzută de utilizare: o fotografie facială poate fi făcută în câteva secunde, cu costuri tehnice și financiare reduse, ceea ce ar putea accelera adoptarea în instrumente de triere sau monitorizare. În același timp, materialul subliniază limite importante: nu este stabilită o relație cauzală; modelul identifică tipare statistice, fără să explice automat procesele biologice din spatele lor; nu este clar dacă rezultatele se aplică și altor afecțiuni medicale; rămâne de văzut câtă valoare predictivă suplimentară aduce fotografia față de metodele clinice consacrate; există îngrijorări privind posibile utilizări precum urmărirea și supravegherea video. Test public: cum poate fi încercat modelul Cei care vor să își estimeze vârsta biologică se pot înscrie pe site-ul proiectului, unde pot încărca între 3 și 10 fotografii ale feței, o singură dată sau zilnic. Sistemul oferă un scor pentru fiecare imagine și un scor agregat. Conform descrierii, fotografiile nu sunt partajate și sunt șterse după o anumită perioadă, iar alte informații sunt anonimizate și puse la dispoziția altor cercetători. [...]
Mii de agenți AI pot comprima luni de analiză biologică în zeci de minute , arată un experiment descris de OpenAI , cu implicații directe pentru productivitatea cercetării și pentru felul în care sunt prioritizate experimentele în neuroștiințe și boli neurodegenerative. Într-o demonstrație realizată împreună cu PerturbAI și Scripps Research , echipa a folosit mii de agenți AI bazați pe GPT‑Rosalind pentru a interpreta date existente din milioane de celule din creierul de șoarece în 32 de minute. Miza operațională este reducerea blocajului dintre „datele produse” și „datele înțelese”: experimentele moderne pot modifica mii de gene și măsura efectele în milioane de celule, însă conectarea rezultatelor cu literatura științifică acumulată în decenii rămâne lentă și fragmentată. Abordarea propusă încearcă să scaleze tocmai această muncă de interpretare, nu doar procesarea brută. Cum funcționează „raționamentul biologic distribuit” Metoda împarte sarcina între mii de agenți AI, fiecare responsabil de o perturbare genetică. Agenții: investighează efectele unei perturbări asupra răspunsurilor celulare; caută și corelează rezultate relevante din literatura științifică; propun explicații și mecanisme biologice posibile. Rezultatele sunt agregate într-un „atlas de raționament” care leagă gene, efecte celulare, publicații relevante și ipoteze de mecanism. Analiza a folosit un „atlas CRISPR” la nivelul întregului creier (un set de date despre efectele perturbărilor genetice în diferite tipuri de celule din creierul de șoarece). De ce contează: randament mai mare la aceeași resursă și acoperire mai bună a literaturii Echipa estimează că o analiză umană comparabilă, făcută „câte o perturbare pe rând”, ar dura de la luni până la un an. În plus, testele interne au comparat un singur agent care primește întregul volum de lucru cu varianta distribuită, păstrând modelul și resursele fixe: pe măsură ce sarcina a crescut, agentul unic a acoperit tot mai puțin din literatură, ajungând să citeze 11 referințe la cel mai mare volum, în timp ce agenții distribuiți au citat peste 700 de referințe. În evaluări „în orb” (fără ca evaluatorii să știe ce variantă analizează), experții umani au preferat rapoartele generate de agenții distribuiți în 75% din cazuri. Potrivit descrierii, agenții au reprodus concluzii din analize umane și au identificat și piste suplimentare, iar evaluările lor privind noutatea și valoarea științifică au fost aliniate cu judecăți ale experților umani. Exemple de piste biologice identificate Materialul oferă câteva exemple de conexiuni pe care agenții le-au scos în evidență și care ar putea ghida experimente ulterioare: diferențe neașteptate între Tsc1 și Tsc2 (gene care controlează mTOR) în cerebel: perturbarea Tsc2 a modificat activitatea a zeci de gene implicate în comunicarea neuronală, în timp ce perturbarea Tsc1 a produs schimbări minime în aceeași zonă; o ipoteză legată de DCTN1 (genă asociată cu sindromul Perry, boală neurodegenerativă cu simptome asemănătoare Parkinson): perturbarea Dctn1 a crescut expresia genelor implicate în sinteza colesterolului, iar agenții au conectat observația cu cercetări care sugerează că problemele de transport al colesterolului pot determina celulele să producă mai mult colesterol. Ipoteza de testat: dacă perturbarea DCTN1 schimbă distribuția colesterolului în neuroni și dacă asta contribuie la neurodegenerare. Ce urmează: acces la rezultate și limitări implicite OpenAI notează că „atlasul de raționament” este disponibil public, astfel încât cercetătorii pot compara gene înrudite, investiga răspunsuri neașteptate și selecta piste promițătoare pentru experimente. În același timp, concluziile prezentate sunt formulate ca direcții de cercetare și ipoteze care necesită validare în laborator, nu ca rezultate clinice. [...]