Știri

Știri din categoria Inteligență artificială

Microsoft a anunțat oficial lansarea cipului Maia 200, o unitate de procesare AI de ultimă generație proiectată pentru sarcini masive de inferență, relatează Windows Central. Cipul este dezvoltat pe tehnologia de 3 nm de la TSMC și este destinat în special pentru a reduce costurile operaționale ale modelelor de limbaj de mari dimensiuni (LLM), precum GPT-5.2, prin scăderea semnificativă a costului per-token.
Microsoft susține că Maia 200 este cel mai performant cip dezvoltat vreodată intern de un hyperscaler și depășește performanțele competitorilor direcți: are de trei ori mai multă performanță FP4 decât Trainium 3 de la Amazon și performanțe FP8 superioare TPU-urilor de generația a șaptea de la Google. Compania afirmă că noul cip oferă un randament cu 30% mai mare per dolar față de hardware-ul de ultimă generație utilizat anterior în infrastructura proprie.
Această lansare vine pe fondul speculațiilor privind o distanțare tot mai clară a Microsoft față de OpenAI, în direcția dezvoltării propriei autonomii tehnologice. De altfel, CEO-ul Microsoft AI, Mustafa Suleyman, a sugerat anterior că viitorul AI va aparține doar marilor jucători care își pot permite dezvoltarea hardware-ului și modelelor proprii, pe fondul costurilor operaționale uriașe.

În același timp, lansarea Maia 200 ar putea ajuta direct OpenAI, care se estimează că va înregistra pierderi de până la 14 miliarde de dolari în 2026. Modelul de cost actual al funcționării ChatGPT și al altor aplicații LLM se bazează pe un consum energetic ridicat și resurse de calcul costisitoare – în special în faza de inferență, atunci când AI generează răspunsuri în timp real. Maia 200 este construit tocmai pentru a eficientiza această parte, iar Microsoft susține că cipul va fi integrat în Microsoft Foundry și Copilot, dar și în fluxurile operaționale ale OpenAI.
Pentru companii precum OpenAI, care oferă acces masiv la servicii de tip chatbot și generatoare de conținut, inferența devine o cheltuială permanentă majoră. Microsoft afirmă că Maia 200 a fost optimizat special pentru acest proces și poate aduce economii semnificative prin reducerea costului per-token. Cu alte cuvinte, AI-ul nu doar că va funcționa mai rapid, dar și mai ieftin.
„Maia 200 face parte din infrastructura noastră AI eterogenă și va deservi mai multe modele, inclusiv GPT-5.2, oferind un avantaj clar de cost pentru Foundry și Microsoft 365 Copilot”, a transmis Microsoft, conform Windows Central.
Lansarea Maia 200 vine într-un moment critic pentru industrie. Pe măsură ce modelele devin tot mai complexe și mai costisitoare de operat, presiunea pe rentabilitate este uriașă. OpenAI, de exemplu, se află în centrul unui „foc financiar” care ar putea atinge 14 miliarde de dolari în pierderi doar în acest an, potrivit sursei citate.
Este de așteptat ca și alți jucători din industrie să urmeze exemplul Microsoft, accelerând dezvoltarea de cipuri personalizate, pentru a reduce dependența de furnizori precum Nvidia și pentru a controla mai bine costurile și performanța.
Dacă promisiunile privind Maia 200 se confirmă, Microsoft nu doar că va consolida poziția sa în infrastructura AI globală, ci ar putea redefini complet calculul economic din spatele modelelor AI – ceea ce ar putea însemna diferența între profit și pierdere pentru companii ca OpenAI.
Recomandate
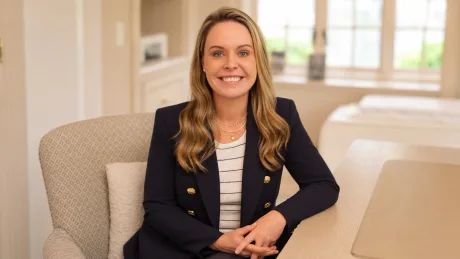
OpenAI își întărește funcția de afaceri corporative prin numirea lui Jill Hazelbaker , o mutare care indică o miză mai mare pe comunicare, poziționare publică și relația cu instituțiile pe măsură ce inteligența artificială intră tot mai mult în zona de reglementare și dezbatere publică, potrivit OpenAI . Hazelbaker va ocupa rolul de Chief Corporate Affairs Officer și va conduce comunicarea globală și poziționarea corporativă a companiei. În această funcție, ea va lucra cu liderii OpenAI pentru „a aprofunda înțelegerea publică” a inteligenței artificiale și pentru a consolida încrederea în misiunea organizației, conform anunțului. De ce contează: comunicarea și încrederea devin o funcție de business Numirea vine într-un moment în care companiile de inteligență artificială sunt evaluate nu doar prin prisma performanței tehnologice, ci și a modului în care gestionează percepția publică, riscurile și dialogul cu autoritățile. OpenAI leagă explicit această decizie de intenția de a investi în leadership și capabilități pentru a se implica „mai profund” cu oamenii și instituțiile care influențează viitorul AI. Profil: experiență în companii cu presiune de reglementare și reputație Cel mai recent, Jill Hazelbaker a fost President și Chief Corporate Affairs Officer la Uber, unde OpenAI spune că a contribuit la transformarea companiei dintr-un startup ambițios într-una dintre cele mai mari platforme globale de tehnologie. În cei aproximativ zece ani la Uber, ea a coordonat, între altele, comunicarea globală, marketingul, politicile publice, siguranța și echipele de resurse umane și a avut un rol central în gestionarea provocărilor de reglementare și reputație. Anterior, Hazelbaker a condus comunicarea și politicile publice la Snap și a avut roluri de conducere la Google, inclusiv pe comunicare corporativă globală, comunicare pentru Europa, Orientul Mijlociu și Africa, precum și relații guvernamentale în Europa. Înainte de cariera din tehnologie, a lucrat în politica din SUA, inclusiv ca director național de comunicare și purtător de cuvânt pentru campania prezidențială a senatorului John McCain din 2008 și ca secretar de presă pentru primarul New York-ului, Michael Bloomberg. Ce urmează OpenAI nu a comunicat un calendar detaliat pentru prioritățile noului director, dar mandatul descris în anunț indică o concentrare pe comunicarea globală, poziționarea companiei și consolidarea încrederii publice, pe fondul intensificării discuțiilor despre impactul și guvernanța inteligenței artificiale. [...]
Sam Altman admite că OpenAI nu explică suficient de bine de ce „merită” riscurile AI , într-o discuție care scoate în evidență o problemă de guvernanță și responsabilitate publică pentru companiile din domeniu, potrivit Gizmodo . CEO-ul OpenAI a vorbit despre ritmul accelerat al dezvoltării inteligenței artificiale într-o apariție pe podcastul „Cheeky Pint”, găzduit de John Collison (cofondator Stripe). În contextul discuției, Altman a descris atât entuziasmul, cât și disconfortul pe care i l-a provocat capacitatea unor modele interne de a rezolva probleme tehnice dificile, cu efecte directe asupra carierelor unor specialiști. „Hold My Beer”, un indiciu despre cultura internă și miza tehnologică Altman a spus că unul dintre modelele folosite intern de OpenAI pentru a ataca probleme „deosebit de dificile” era cunoscut între angajați drept „Model Name-Hold My Beer”. El a relatat că modelul „dobora” pe rând unele dintre cele mai grele probleme de cercetare la care oameni lucraseră ani întregi. „Am avut această experiență colectivă: cele mai grele probleme de cercetare din cariera academică a oamenilor; modelul le doborâa una după alta.” (Sam Altman) Altman a adăugat că printre aceste probleme s-ar fi aflat și „multe dintre cele pe care le-am publicat”, referire care ar putea viza rezultatele făcute publice de OpenAI în zona matematicii. Publicația notează că OpenAI nu a răspuns imediat unei solicitări de clarificare. Context: tensiuni în matematică după publicarea unor rezultate asistate de AI Gizmodo plasează declarațiile în contextul reacțiilor din comunitatea matematică, după ce OpenAI a publicat „controversat” o soluție asistată de AI pentru problema Navier–Stokes, iar unii matematicieni au acuzat compania de plagiat. Ulterior, OpenAI ar fi publicat rezultate pentru „aproape 400” de probleme matematice vechi. În articol se avansează ideea că, pentru generațiile viitoare, seria de demonstrații din 2026 ar putea deveni un moment de cotitură pentru domeniu, comparabil cu impactul pe care l-a avut victoria lui Deep Blue asupra lui Garry Kasparov în șah. „Nu am făcut o treabă grozavă” în a justifica public costurile Dincolo de detaliul anecdotic al numelui intern, miza principală a discuției este recunoașterea explicită a unei dificultăți de comunicare și asumare a efectelor: Altman spune că OpenAI nu a explicat suficient de bine de ce consideră că dezavantajele potențiale ale tehnologiei sunt „worth it” (merită). „Nu cred că noi [OpenAI] am făcut o treabă grozavă în a le explica oamenilor de ce credem că toate dezavantajele potențiale ale acestei tehnologii merită.” (Sam Altman) În același registru, el a descris o stare amestecată — „excitat și fericit”, dar și cu „tristețe și melancolie” și senzația „că se termină ceva” — după ce a urmărit performanțele modelului intern. Ce rămâne neclar Articolul nu oferă detalii tehnice despre modelul „Hold My Beer” (ce arhitectură are, ce capabilități exacte, ce nivel de autonomie) și nici nu confirmă explicit care rezultate publicate au fost obținute cu ajutorul lui. În lipsa unui răspuns de la OpenAI, legătura dintre modelul intern și setul de rezultate publicate rămâne, deocamdată, la nivel de sugestie din declarațiile lui Altman. [...]
Sam Altman susține că memoria RAM din PC-urile utilizatorilor este o risipă globală , argumentând că o resursă „oricum limitată” ar trebui concentrată în centre de date, unde poate fi folosită mai intens, potrivit WinFuture . Într-o discuție cu canalul de YouTube Cheeky Pint, CEO-ul OpenAI a spus că, din perspectiva distribuirii la nivel mondial a DRAM (memorie RAM), este „destul de îngrozitor” ca fiecare utilizator să țină o parte din această capacitate în propriul computer, în condițiile în care ar fi utilizată „poate cinci la sută din timp”. În opinia sa, aceeași memorie ar avea randament mai bun dacă ar fi „maximal utilizată” în cloud (infrastructură de calcul la distanță, în centre de date). De ce contează: presiune pe piața de memorie și un argument pro-cloud Poziția lui Altman se leagă de contextul mai larg al competiției pentru resurse hardware folosite de inteligența artificială, într-un moment în care memoria este descrisă drept „rară”. Mesajul său susține, practic, o alocare a memoriei către centrele de date, nu către dispozitivele utilizatorilor, ceea ce favorizează modelul de consum al serviciilor AI din cloud. Altman a criticat și ideea că problema ar fi rezolvată prin modele open-source rulate local, menționând că există utilizatori care vor să ruleze modele AI pe propriile sisteme și ajung să creadă că „nu avem nevoie de toate lucrurile astea în centrele de date”. Limitările și contextul omise de această abordare WinFuture notează că perspectiva este una „foarte unilaterală”, mai ales venind de la șeful unuia dintre cei mai mari furnizori de AI. Articolul punctează și un aspect practic: chiar și cele mai ieftine sisteme client (laptopuri, thin clients, smartphone-uri și tablete) nu pot funcționa fără memorie RAM, indiferent dacă utilizatorul rulează sau nu modele AI local. În esență, declarațiile lui Altman mută discuția din zona tehnică în cea de alocare a resurselor: cine „merită” memoria limitată — utilizatorii finali, cu dispozitive personale, sau operatorii de centre de date, care pot crește gradul de utilizare prin consolidare în cloud. [...]
Declarațiile lui Sam Altman sugerează o miză economică directă: mutarea cât mai multor sarcini de inteligență artificială din PC-uri către centre de date, unde resursele pot fi folosite mai intens. Într-un interviu „la bere” acordat canalului de YouTube Cheeky Pint, citat de Tom's Hardware , CEO-ul OpenAI a spus că „inferința locală” (rularea modelelor AI direct pe dispozitivul utilizatorului) și, prin extensie, faptul că oamenii au memorie DRAM/RAM în calculatoarele de acasă este „destul de rău”. De ce contează: „utilizarea” memoriei devine argument pentru centralizare Altman își bazează poziția pe ideea de alocare globală a unei resurse limitate: memoria DRAM. Potrivit relatării, el a susținut că este ineficient ca „toată lumea” să aibă „o grămadă” din oferta limitată de DRAM în propriul computer, folosită doar o mică parte din timp. În această logică, centrele de date ar oferi o „utilizare mai bună” a resurselor, deoarece pot agrega cererea și pot menține hardware-ul ocupat mai mult timp decât un PC obișnuit. Contextul declarației și reacțiile Interviul a fost publicat de canalul de YouTube Cheeky Pint (link în materialul sursă), iar articolul notează contrastul dintre faptul că OpenAI operează centre de date „pline de memorie” și critica la adresa celor 32 GB RAM dintr-un desktop. Materialul include și reacții critice din zona de comentarii, însă acestea sunt opinii ale utilizatorilor, nu informații verificate despre piață sau despre gradul de utilizare al centrelor de date. Ce rămâne neclar Articolul nu oferă date cantitative sau dovezi independente care să susțină procentele de utilizare invocate în discuție și nici nu detaliază un plan concret al OpenAI privind limitarea inferenței locale. În forma prezentată, mesajul rămâne în primul rând o poziționare publică pro-centralizare, cu implicații evidente pentru modelul de business al furnizorilor de AI în cloud (servicii rulate în centre de date, accesate prin internet). [...]
OpenAI își extinde integrarea în ecosistemul Oracle, cu obiectivul de a aduce aplicațiile și datele Oracle direct în ChatGPT , într-o mișcare care țintește utilizarea AI în operațiuni de bază (finanțe, achiziții, planificare) și simplificarea administrării și a controlului accesului în companii, potrivit OpenAI . Parteneriatul se bazează pe relația comercială existentă dintre cele două companii, care acoperă OpenAI API, ChatGPT Work și Codex. OpenAI notează că Oracle a raportat 130.000 de utilizatori activi ChatGPT și peste 95.000 de utilizatori activi Codex. În același context, echipa de recrutare a Oracle folosește ChatGPT Work pentru cercetare de piață: o activitate care dura anterior între două și patru zile ar ajunge acum să fie pregătită în 15–20 de minute. Integrarea aplicațiilor Oracle în ChatGPT: „agent-ready enterprise” Direcția declarată este un „agent-ready enterprise”, adică un mediu în care angajații și agenții AI (software care poate executa sarcini) lucrează în aplicațiile de business într-un spațiu conectat. Obiectivul este ca software-ul Oracle să fie mai ușor de descoperit, folosit și administrat, cu: administrare simplificată, autentificare unificată, acces guvernat de permisiunile și aprobările fiecărei organizații. Miza operațională, în logica anunțului, este scalarea utilizării AI în activități esențiale și creșterea valorii obținute din aplicațiile deja folosite în companie. Oracle AI Workspace : fluxuri de lucru aprobate, într-un singur loc Oracle dezvoltă Oracle AI Workspace pentru a aduce integrarea în ChatGPT, conectând aplicațiile și datele Oracle. Scopul este ca utilizatorii să poată descrie ce au de făcut, să găsească informația relevantă și să finalizeze fluxuri de lucru de business aprobate, dintr-un singur loc. Ca exemplu, OpenAI descrie un scenariu în care un nou membru al echipei financiare ar putea folosi ChatGPT pentru a investiga costuri, a înțelege decizii de achiziție și a identifica ce mai lipsește înainte de închiderea de lună, cu informații agregate din aplicații de finanțe, achiziții și planificare, în limitele permisiunilor interne. Produse Oracle noi și actualizări construite cu modele OpenAI În paralel cu Oracle AI Workspace, Oracle anunță actualizări și oferte noi construite cu modele și instrumente OpenAI: Oracle AI Security Mesh , gândit pentru identificarea și remedierea vulnerabilităților din aplicații și infrastructură folosind modele de securitate cibernetică ale OpenAI; Oracle ar gestiona infrastructura de testare. Oracle AI SMB Bundle , care combină ChatGPT Business și Codex cu aplicații Oracle și credite recurente pentru Oracle Cloud Infrastructure, pentru a ajuta firmele mici să construiască produse și să-și gestioneze operațiunile. Oracle App Composer , destinat construirii de aplicații cu Codex și alte instrumente AI, conectate la date și fluxuri de lucru Oracle aprobate, cu distribuire internă; implementarea ar fi gestionată pe Oracle Cloud Infrastructure, cu controale de acces incluse. Achiziție prin Oracle Marketplace , pentru clienții din SUA OpenAI precizează că clienții Oracle din SUA pot cumpăra acces la OpenAI API, Codex și ChatGPT Work prin Oracle Marketplace, folosind procesele existente de achiziție și credite eligibile Oracle Universal Credits. [...]
OpenAI taie la jumătate prețul API pentru GPT-6.1 Terra , poziționând modelul ca opțiune de automatizare „la volum” pentru sarcini de birou care combină înțelegere vizuală, utilizare de aplicații și redactare, potrivit OpenAI . GPT-6.1 Terra este prezentat ca un model „rapid și eficient”, cu raționament vizual detaliat și „computer use” (capacitatea de a opera aplicații și fluxuri pe calculator), plus scriere mai naturală. Miza practică, în descrierea companiei, este reducerea costului total pentru automatizarea muncii repetitive: de la citirea facturilor primite și introducerea datelor în software de contabilitate, până la completarea de formulare sau editare video. Ce se schimbă pentru costuri: prețuri API și consum în produse OpenAI afirmă că prețurile standard din API pentru GPT-6.1 Terra sunt cu 50% mai mici decât cele ale GPT-5.6 Terra și GPT-6.1 Sol, ceea ce ar face modelul mai potrivit pentru procese cu volum mare. În paralel, în ChatGPT Work și Codex, compania spune că „același plafon de utilizare” acoperă mai multe sarcini decât în GPT‑5.6 Terra și „substanțial mai multe” decât în GPT‑6.1 Sol sau GPT‑6 Astra. Prețurile standard în API, comunicate de OpenAI, sunt: 1 dolar (aprox. 4,6 lei) per milion de tokeni de intrare; 0,05 dolari (aprox. 0,23 lei) per milion de tokeni de intrare din cache (tokeni reutilizați dintr-o intrare anterioară, pentru cost mai mic); 5 dolari (aprox. 23 lei) per milion de tokeni de ieșire. Performanță operațională: viteză și eficiență pe sarcini „de agent” Pe benchmark-ul Agents’ Last Exam (sarcini profesionale, inclusiv transformarea unor planșe arhitecturale într-un model 3D și analiză cadru cu cadru pentru log cu marcaje de timp), OpenAI susține că: la efort mediu de raționament, GPT-6.1 Terra obține un scor cu 15 puncte procentuale peste GPT-5.6 Terra, la circa o treime din cost; rulează „la nivel” cu GPT-6 Astra la o zecime din prețul per token; la efort maxim, este de peste trei ori mai eficient la tokeni decât Claude Opus 5.5 și costă un sfert per token, ceea ce ar duce la un cost per sarcină de aproximativ 9 ori mai mic; finalizează sarcini de peste trei ori mai repede decât GPT-6 Astra și GPT-6.1 Sol. OpenAI mai indică rezultate mai bune față de GPT-5.6 Terra pe MMMU-Pro (raționament vizual) și pe OSWorld 2.1 (utilizarea aplicațiilor desktop pentru sarcini în mai mulți pași), cu accent pe raportul performanță/cost. Calitate: mai puține erori factuale și salt pe sarcini de programare Compania spune că a investit în reducerea „halucinațiilor” (răspunsuri inventate sau eronate). Pe un benchmark intern de prompturi care induc erori, rata de eroare: a scăzut de la 53,6% (GPT-5.6 Terra) la 16,7% (GPT-6.1 Terra) la efort redus de raționament; a coborât la 4,3% la efort maxim, cu o reducere de 18 puncte procentuale, „aproape” de nivelurile GPT-6 Astra și GPT-6.1 Sol. Pe Terminal-Bench 4.0 (sarcini de inginerie software din linia de comandă), la efort maxim, GPT‑6.1 Terra rezolvă 50,3% dintre sarcini, față de 21,5% pentru GPT‑5.6 Terra (scor publicat). Pentru cele mai complexe sarcini de programare, OpenAI precizează că GPT-6.1 Sol și GPT-6 Astra rămân opțiuni mai bune. Siguranță și disponibilitate OpenAI afirmă că GPT‑6.1 Terra atinge pragul „Critical” în securitate cibernetică în cadrul Preparedness Framework și păstrează protecțiile dezvoltate pentru GPT‑6 Astra. Compania mai susține că modelul este mai predispus să rămână „în scop” (să nu devieze de la cererea utilizatorului), să își recunoască limitările și să reziste la prompt-injection (instrucțiuni malițioase care încearcă să deturneze sarcina). Mai multe detalii sunt disponibile în „system card”-ul dedicat: https://deploymentsafety.openai.com/gpt-6-1-terra (link menționat în sursă). Începând „de astăzi”, GPT-6.1 Terra este disponibil pentru utilizatorii Plus, Pro, Enterprise și Edu în ChatGPT Work și Codex, iar pentru dezvoltatori prin API, sub identificatorul gpt-6.1-terra . [...]