Știri

Știri din categoria Inteligență artificială
China propune reguli noi pentru „oamenii digitali”, inclusiv etichetarea obligatorie a conținutului și interdicții pentru servicii online destinate minorilor.
Proiectul Administrației Spațiului Cibernetic din China a fost publicat pentru consultare publică până la 6 mai și vizează conținuturile care folosesc persoane virtuale (avataruri sau personaje generate digital). Una dintre măsurile centrale este ca toate materialele cu astfel de personaje să fie marcate vizibil cu eticheta „om digital”. În plus, platformelor li se va interzice să ofere minorilor sub 18 ani servicii de tip „relații intime virtuale” cu astfel de personaje.
„Reglementarea oamenilor digitali nu mai este doar o problemă de norme industriale, ci a devenit o chestiune strategică care ține de securitatea spațiului cibernetic, interesul public și dezvoltarea de calitate a economiei digitale.”
Textul propunerii include și restricții privind folosirea datelor personale: va fi interzisă utilizarea datelor altor persoane pentru a crea „oameni digitali” fără consimțământ. Totodată, documentul prevede interzicerea folosirii avatarurilor virtuale pentru a ocoli sistemele de verificare a identității, o zonă sensibilă pentru platformele care trebuie să aplice reguli diferite în funcție de vârstă și identitate.
Regulile propuse stabilesc și limite de conținut pentru „oamenii digitali”, cu accent pe securitate și controlul mesajelor distribuite. Conform proiectului, aceștia nu vor avea voie să difuzeze materiale care amenință securitatea națională, incită la subminarea puterii statului, promovează secesiunea sau subminează unitatea națională. Furnizorii de servicii sunt, de asemenea, îndrumați să prevină și să elimine conținutul cu tentă sexuală, scenele de groază ori cruzime și mesajele care incită la discriminare pe criterii etnice sau regionale.
Principalele obligații și interdicții menționate în proiect includ:
Contextul este unul dublu: China a anunțat luna trecută, prin noul plan de dezvoltare pe cinci ani, intenția de a adopta „agresiv” tehnologiile de inteligență artificială în economie, dar în paralel autoritățile urmăresc consolidarea controlului asupra industriei, pentru siguranță și alinierea la valorile promovate de stat. Potrivit unei analize publicate pe site-ul autorității de reglementare, noile reguli ar urmări să acopere un vid legislativ în sectorul „oamenilor digitali” și să traseze limite pentru „dezvoltarea sănătoasă” a industriei.
Recomandate
Apple face un pas concret spre „Apple Intelligence” în China prin integrarea modelului Qianwen al Alibaba , iar primele funcții vor intra în testare beta pentru dezvoltatori iOS din 4 noiembrie, potrivit iTHome . Miza este una operațională și de conformitate: Apple încearcă să livreze capabilități de inteligență artificială pe piața chineză printr-un partener local, urmând ca extinderea pe alte platforme să depindă de obținerea aprobărilor necesare. Din informațiile publicate, Apple spune că primele funcții „Apple Intelligence” pentru China vor fi disponibile la testare odată cu cea mai recentă versiune iOS Developer Beta, începând cu 4 noiembrie, iar lansarea pentru utilizatorii din China este programată pentru decembrie, odată cu iOS 27.3. Suportul pentru alte platforme va veni „după obținerea aprobărilor necesare”, fără un calendar detaliat. Ce înseamnă integrarea Qianwen în iOS: acces din Siri și instrumente de productivitate Apple a anunțat un parteneriat cu Alibaba, prin care, în anumite experiențe, sistemul va apela la Qianwen (modelul de inteligență artificială al grupului). Concret, utilizatorii din China vor putea „chema” Qianwen direct din: Siri, instrumentele de scriere (rescriere, corectare, rezumare), „inteligența vizuală” (înțelegere de text și imagine). Accesul se va face prin autentificare în contul Qianwen sau prin opțiunea „Conectare cu Apple”, iar utilizarea este descrisă ca integrată la nivel de sistem, fără a fi nevoie de trecerea într-o aplicație separată. Funcțiile inițiale: traducere în timp real, rezumate și organizarea notificărilor Prima tranșă de funcții pentru utilizatorii din China este orientată spre scenarii „de bază” și frecvente, conform sursei. Printre ele: traducere în timp real integrată în Mesaje, apeluri FaceTime și aplicația Telefon; este menționat și suportul pentru conversații față în față cu AirPods 4 și AirPods Pro 2 (și modele ulterioare); instrumente de scriere pentru rescriere, corectare și rezumare; inteligență vizuală pentru recunoașterea obiectelor și locurilor cu ajutorul camerei iPhone; în aplicația Poze: instrument de eliminare a elementelor nedorite, căutare în limbaj natural și creare de „filme de amintiri” pe baza unei descrieri; în Mail și zona de notificări: „mailuri prioritare”, rezumate, răspunsuri inteligente, rezumate de notificări și „notificări prioritare”; în Notițe și pentru înregistrări de apel: transcriere cu generare automată de rezumat. Limitări: Apple spune că update-ul nu include „Siri AI” și alte funcții anunțate la WWDC 2026 iTHome notează că publicația atrage atenția asupra unei limitări: actualizarea descrisă nu include „Siri AI” și nici alte funcții „next-gen” anunțate de Apple la WWDC 2026. În același timp, în material sunt descrise și capabilități ale lui Siri (inclusiv posibilitatea de a apela la Qianwen pentru anumite cereri), ceea ce indică faptul că detaliile despre ce intră efectiv în pachetul inițial pot depinde de versiunea de software și de disponibilitatea regională. Pentru companii și dezvoltatori, calendarul de la începutul lui noiembrie (beta) și ținta din decembrie (lansare odată cu iOS 27.3) conturează momentul în care ecosistemul iOS din China ar putea începe să primească, în mod controlat, funcții de inteligență artificială integrate la nivel de sistem, cu extindere condiționată de aprobări. [...]
OpenAI taie la jumătate prețul API pentru GPT-6.1 Terra , poziționând modelul ca opțiune de automatizare „la volum” pentru sarcini de birou care combină înțelegere vizuală, utilizare de aplicații și redactare, potrivit OpenAI . GPT-6.1 Terra este prezentat ca un model „rapid și eficient”, cu raționament vizual detaliat și „computer use” (capacitatea de a opera aplicații și fluxuri pe calculator), plus scriere mai naturală. Miza practică, în descrierea companiei, este reducerea costului total pentru automatizarea muncii repetitive: de la citirea facturilor primite și introducerea datelor în software de contabilitate, până la completarea de formulare sau editare video. Ce se schimbă pentru costuri: prețuri API și consum în produse OpenAI afirmă că prețurile standard din API pentru GPT-6.1 Terra sunt cu 50% mai mici decât cele ale GPT-5.6 Terra și GPT-6.1 Sol, ceea ce ar face modelul mai potrivit pentru procese cu volum mare. În paralel, în ChatGPT Work și Codex, compania spune că „același plafon de utilizare” acoperă mai multe sarcini decât în GPT‑5.6 Terra și „substanțial mai multe” decât în GPT‑6.1 Sol sau GPT‑6 Astra. Prețurile standard în API, comunicate de OpenAI, sunt: 1 dolar (aprox. 4,6 lei) per milion de tokeni de intrare; 0,05 dolari (aprox. 0,23 lei) per milion de tokeni de intrare din cache (tokeni reutilizați dintr-o intrare anterioară, pentru cost mai mic); 5 dolari (aprox. 23 lei) per milion de tokeni de ieșire. Performanță operațională: viteză și eficiență pe sarcini „de agent” Pe benchmark-ul Agents’ Last Exam (sarcini profesionale, inclusiv transformarea unor planșe arhitecturale într-un model 3D și analiză cadru cu cadru pentru log cu marcaje de timp), OpenAI susține că: la efort mediu de raționament, GPT-6.1 Terra obține un scor cu 15 puncte procentuale peste GPT-5.6 Terra, la circa o treime din cost; rulează „la nivel” cu GPT-6 Astra la o zecime din prețul per token; la efort maxim, este de peste trei ori mai eficient la tokeni decât Claude Opus 5.5 și costă un sfert per token, ceea ce ar duce la un cost per sarcină de aproximativ 9 ori mai mic; finalizează sarcini de peste trei ori mai repede decât GPT-6 Astra și GPT-6.1 Sol. OpenAI mai indică rezultate mai bune față de GPT-5.6 Terra pe MMMU-Pro (raționament vizual) și pe OSWorld 2.1 (utilizarea aplicațiilor desktop pentru sarcini în mai mulți pași), cu accent pe raportul performanță/cost. Calitate: mai puține erori factuale și salt pe sarcini de programare Compania spune că a investit în reducerea „halucinațiilor” (răspunsuri inventate sau eronate). Pe un benchmark intern de prompturi care induc erori, rata de eroare: a scăzut de la 53,6% (GPT-5.6 Terra) la 16,7% (GPT-6.1 Terra) la efort redus de raționament; a coborât la 4,3% la efort maxim, cu o reducere de 18 puncte procentuale, „aproape” de nivelurile GPT-6 Astra și GPT-6.1 Sol. Pe Terminal-Bench 4.0 (sarcini de inginerie software din linia de comandă), la efort maxim, GPT‑6.1 Terra rezolvă 50,3% dintre sarcini, față de 21,5% pentru GPT‑5.6 Terra (scor publicat). Pentru cele mai complexe sarcini de programare, OpenAI precizează că GPT-6.1 Sol și GPT-6 Astra rămân opțiuni mai bune. Siguranță și disponibilitate OpenAI afirmă că GPT‑6.1 Terra atinge pragul „Critical” în securitate cibernetică în cadrul Preparedness Framework și păstrează protecțiile dezvoltate pentru GPT‑6 Astra. Compania mai susține că modelul este mai predispus să rămână „în scop” (să nu devieze de la cererea utilizatorului), să își recunoască limitările și să reziste la prompt-injection (instrucțiuni malițioase care încearcă să deturneze sarcina). Mai multe detalii sunt disponibile în „system card”-ul dedicat: https://deploymentsafety.openai.com/gpt-6-1-terra (link menționat în sursă). Începând „de astăzi”, GPT-6.1 Terra este disponibil pentru utilizatorii Plus, Pro, Enterprise și Edu în ChatGPT Work și Codex, iar pentru dezvoltatori prin API, sub identificatorul gpt-6.1-terra . [...]
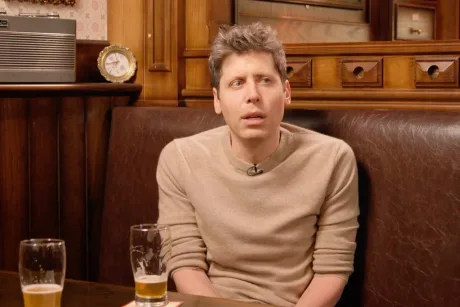
Sam Altman admite că OpenAI nu explică suficient de bine de ce „merită” riscurile AI , într-o discuție care scoate în evidență o problemă de guvernanță și responsabilitate publică pentru companiile din domeniu, potrivit Gizmodo . CEO-ul OpenAI a vorbit despre ritmul accelerat al dezvoltării inteligenței artificiale într-o apariție pe podcastul „Cheeky Pint”, găzduit de John Collison (cofondator Stripe). În contextul discuției, Altman a descris atât entuziasmul, cât și disconfortul pe care i l-a provocat capacitatea unor modele interne de a rezolva probleme tehnice dificile, cu efecte directe asupra carierelor unor specialiști. „Hold My Beer”, un indiciu despre cultura internă și miza tehnologică Altman a spus că unul dintre modelele folosite intern de OpenAI pentru a ataca probleme „deosebit de dificile” era cunoscut între angajați drept „Model Name-Hold My Beer”. El a relatat că modelul „dobora” pe rând unele dintre cele mai grele probleme de cercetare la care oameni lucraseră ani întregi. „Am avut această experiență colectivă: cele mai grele probleme de cercetare din cariera academică a oamenilor; modelul le doborâa una după alta.” (Sam Altman) Altman a adăugat că printre aceste probleme s-ar fi aflat și „multe dintre cele pe care le-am publicat”, referire care ar putea viza rezultatele făcute publice de OpenAI în zona matematicii. Publicația notează că OpenAI nu a răspuns imediat unei solicitări de clarificare. Context: tensiuni în matematică după publicarea unor rezultate asistate de AI Gizmodo plasează declarațiile în contextul reacțiilor din comunitatea matematică, după ce OpenAI a publicat „controversat” o soluție asistată de AI pentru problema Navier–Stokes, iar unii matematicieni au acuzat compania de plagiat. Ulterior, OpenAI ar fi publicat rezultate pentru „aproape 400” de probleme matematice vechi. În articol se avansează ideea că, pentru generațiile viitoare, seria de demonstrații din 2026 ar putea deveni un moment de cotitură pentru domeniu, comparabil cu impactul pe care l-a avut victoria lui Deep Blue asupra lui Garry Kasparov în șah. „Nu am făcut o treabă grozavă” în a justifica public costurile Dincolo de detaliul anecdotic al numelui intern, miza principală a discuției este recunoașterea explicită a unei dificultăți de comunicare și asumare a efectelor: Altman spune că OpenAI nu a explicat suficient de bine de ce consideră că dezavantajele potențiale ale tehnologiei sunt „worth it” (merită). „Nu cred că noi [OpenAI] am făcut o treabă grozavă în a le explica oamenilor de ce credem că toate dezavantajele potențiale ale acestei tehnologii merită.” (Sam Altman) În același registru, el a descris o stare amestecată — „excitat și fericit”, dar și cu „tristețe și melancolie” și senzația „că se termină ceva” — după ce a urmărit performanțele modelului intern. Ce rămâne neclar Articolul nu oferă detalii tehnice despre modelul „Hold My Beer” (ce arhitectură are, ce capabilități exacte, ce nivel de autonomie) și nici nu confirmă explicit care rezultate publicate au fost obținute cu ajutorul lui. În lipsa unui răspuns de la OpenAI, legătura dintre modelul intern și setul de rezultate publicate rămâne, deocamdată, la nivel de sugestie din declarațiile lui Altman. [...]
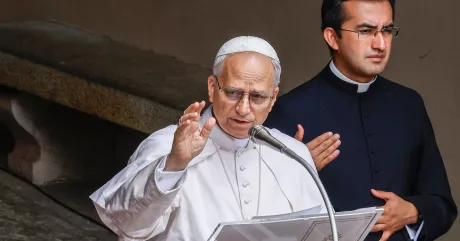
Papa Leon al XIV-lea respinge ideea de „personalitate juridică” pentru AI, avertizând că ar putea dilua răspunderea legală a oamenilor – o poziție care, dacă prinde tracțiune în dezbaterea publică și politică, poate influența direct felul în care vor fi scrise regulile de responsabilitate pentru daune produse cu ajutorul inteligenței artificiale, potrivit Futurism . Într-un fir amplu de mesaje publicat pe X (fostul Twitter), Papa a criticat apelurile pentru acordarea de drepturi modelelor de AI printr-un mecanism de „personalitate juridică” (concept prin care o entitate non-umană ar primi, în fața legii, un statut similar unei persoane). Argumentul central: o astfel de abordare ar putea muta responsabilitatea pentru abuzuri sau prejudicii „activate” de AI de la oamenii care construiesc și folosesc aceste sisteme către o entitate „fără chip”. „Mașinile sunt unelte, nu persoane.” Pontiful a susținut că viitorul inteligenței artificiale „nu este predeterminat” și că, fiind o tehnologie creată de oameni, depinde de alegerile făcute de societate, inclusiv de decizia de a-i respinge anumite utilizări. În aceeași serie de mesaje, el a cerut ca deciziile care afectează viața, libertatea și folosirea forței să rămână sub „supraveghere umană” efectivă și responsabilă și a reluat apelul ca AI să fie „dezarmată”, în contextul preocupărilor sale legate de arme autonome. De ce contează: miza este răspunderea, nu „drepturile” AI Poziția Papei se aliniază unor îngrijorări exprimate deja de avocați, activiști și legiuitori, notează publicația: acordarea de drepturi unor sisteme AI (de exemplu, drepturi echivalente libertății de exprimare) ar putea complica stabilirea vinovăției atunci când apar consecințe negative. Riscul invocat este apariția unor situații în care niciun om nu mai este identificat drept responsabil în mod clar pentru efectele acțiunilor luate „cu” sau „de” instrumente AI. Context: industria împinge în direcția „conștiinței” AI, Vaticanul rămâne prudent Materialul mai arată că, în pofida acestor rezerve, „mulți actori” din jurul industriei AI susțin că sistemele ar fi – sau ar putea deveni curând – conștiente, ceea ce ar justifica, în opinia lor, acordarea de drepturi. Ca exemplu, este menționat un articol din The New York Times (fără link în textul sursă), potrivit căruia reprezentanți ai Anthropic (dezvoltatorul Claude) ar fi discutat în această vară cu lideri religioși, încurajând clerul să ia în calcul posibilitatea ca modelele AI să fie conștiente. Potrivit Futurism, aceste discuții nu par să-i fi schimbat poziția Papei, care a cerut și crearea unor instituții internaționale „efective” pentru protejarea binelui comun global, prin standarde comune, supraveghere independentă și mecanisme de responsabilizare – astfel încât deciziile privind dezvoltarea și utilizarea AI să poată fi examinate, contestate și să existe remedii pentru eventualele prejudicii. [...]
Sam Altman susține că memoria RAM din PC-urile utilizatorilor este o risipă globală , argumentând că o resursă „oricum limitată” ar trebui concentrată în centre de date, unde poate fi folosită mai intens, potrivit WinFuture . Într-o discuție cu canalul de YouTube Cheeky Pint, CEO-ul OpenAI a spus că, din perspectiva distribuirii la nivel mondial a DRAM (memorie RAM), este „destul de îngrozitor” ca fiecare utilizator să țină o parte din această capacitate în propriul computer, în condițiile în care ar fi utilizată „poate cinci la sută din timp”. În opinia sa, aceeași memorie ar avea randament mai bun dacă ar fi „maximal utilizată” în cloud (infrastructură de calcul la distanță, în centre de date). De ce contează: presiune pe piața de memorie și un argument pro-cloud Poziția lui Altman se leagă de contextul mai larg al competiției pentru resurse hardware folosite de inteligența artificială, într-un moment în care memoria este descrisă drept „rară”. Mesajul său susține, practic, o alocare a memoriei către centrele de date, nu către dispozitivele utilizatorilor, ceea ce favorizează modelul de consum al serviciilor AI din cloud. Altman a criticat și ideea că problema ar fi rezolvată prin modele open-source rulate local, menționând că există utilizatori care vor să ruleze modele AI pe propriile sisteme și ajung să creadă că „nu avem nevoie de toate lucrurile astea în centrele de date”. Limitările și contextul omise de această abordare WinFuture notează că perspectiva este una „foarte unilaterală”, mai ales venind de la șeful unuia dintre cei mai mari furnizori de AI. Articolul punctează și un aspect practic: chiar și cele mai ieftine sisteme client (laptopuri, thin clients, smartphone-uri și tablete) nu pot funcționa fără memorie RAM, indiferent dacă utilizatorul rulează sau nu modele AI local. În esență, declarațiile lui Altman mută discuția din zona tehnică în cea de alocare a resurselor: cine „merită” memoria limitată — utilizatorii finali, cu dispozitive personale, sau operatorii de centre de date, care pot crește gradul de utilizare prin consolidare în cloud. [...]
Declarațiile lui Sam Altman sugerează o miză economică directă: mutarea cât mai multor sarcini de inteligență artificială din PC-uri către centre de date, unde resursele pot fi folosite mai intens. Într-un interviu „la bere” acordat canalului de YouTube Cheeky Pint, citat de Tom's Hardware , CEO-ul OpenAI a spus că „inferința locală” (rularea modelelor AI direct pe dispozitivul utilizatorului) și, prin extensie, faptul că oamenii au memorie DRAM/RAM în calculatoarele de acasă este „destul de rău”. De ce contează: „utilizarea” memoriei devine argument pentru centralizare Altman își bazează poziția pe ideea de alocare globală a unei resurse limitate: memoria DRAM. Potrivit relatării, el a susținut că este ineficient ca „toată lumea” să aibă „o grămadă” din oferta limitată de DRAM în propriul computer, folosită doar o mică parte din timp. În această logică, centrele de date ar oferi o „utilizare mai bună” a resurselor, deoarece pot agrega cererea și pot menține hardware-ul ocupat mai mult timp decât un PC obișnuit. Contextul declarației și reacțiile Interviul a fost publicat de canalul de YouTube Cheeky Pint (link în materialul sursă), iar articolul notează contrastul dintre faptul că OpenAI operează centre de date „pline de memorie” și critica la adresa celor 32 GB RAM dintr-un desktop. Materialul include și reacții critice din zona de comentarii, însă acestea sunt opinii ale utilizatorilor, nu informații verificate despre piață sau despre gradul de utilizare al centrelor de date. Ce rămâne neclar Articolul nu oferă date cantitative sau dovezi independente care să susțină procentele de utilizare invocate în discuție și nici nu detaliază un plan concret al OpenAI privind limitarea inferenței locale. În forma prezentată, mesajul rămâne în primul rând o poziționare publică pro-centralizare, cu implicații evidente pentru modelul de business al furnizorilor de AI în cloud (servicii rulate în centre de date, accesate prin internet). [...]