Știri

Știri din categoria Inteligență artificială
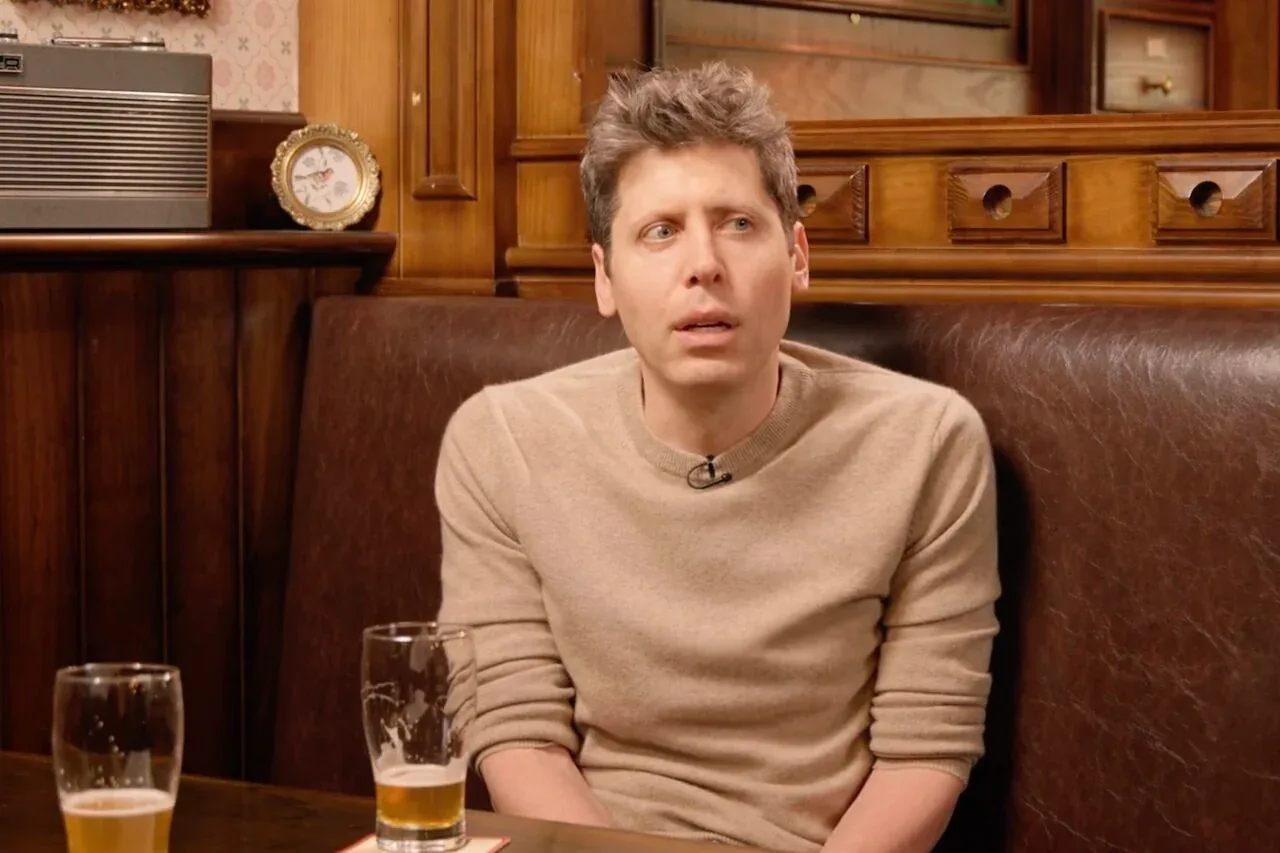
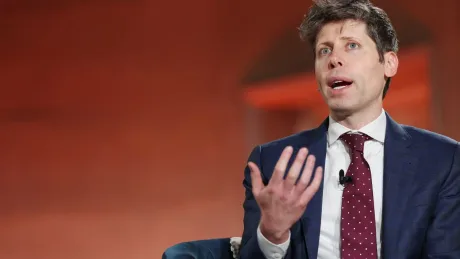
Sam Altman admite că OpenAI nu explică suficient de bine de ce „merită” riscurile AI, într-o discuție care scoate în evidență o problemă de guvernanță și responsabilitate publică pentru companiile din domeniu, potrivit Gizmodo.
CEO-ul OpenAI a vorbit despre ritmul accelerat al dezvoltării inteligenței artificiale într-o apariție pe podcastul „Cheeky Pint”, găzduit de John Collison (cofondator Stripe). În contextul discuției, Altman a descris atât entuziasmul, cât și disconfortul pe care i l-a provocat capacitatea unor modele interne de a rezolva probleme tehnice dificile, cu efecte directe asupra carierelor unor specialiști.
Altman a spus că unul dintre modelele folosite intern de OpenAI pentru a ataca probleme „deosebit de dificile” era cunoscut între angajați drept „Model Name-Hold My Beer”. El a relatat că modelul „dobora” pe rând unele dintre cele mai grele probleme de cercetare la care oameni lucraseră ani întregi.
„Am avut această experiență colectivă: cele mai grele probleme de cercetare din cariera academică a oamenilor; modelul le doborâa una după alta.” (Sam Altman)
Altman a adăugat că printre aceste probleme s-ar fi aflat și „multe dintre cele pe care le-am publicat”, referire care ar putea viza rezultatele făcute publice de OpenAI în zona matematicii. Publicația notează că OpenAI nu a răspuns imediat unei solicitări de clarificare.
Gizmodo plasează declarațiile în contextul reacțiilor din comunitatea matematică, după ce OpenAI a publicat „controversat” o soluție asistată de AI pentru problema Navier–Stokes, iar unii matematicieni au acuzat compania de plagiat. Ulterior, OpenAI ar fi publicat rezultate pentru „aproape 400” de probleme matematice vechi.
În articol se avansează ideea că, pentru generațiile viitoare, seria de demonstrații din 2026 ar putea deveni un moment de cotitură pentru domeniu, comparabil cu impactul pe care l-a avut victoria lui Deep Blue asupra lui Garry Kasparov în șah.
Dincolo de detaliul anecdotic al numelui intern, miza principală a discuției este recunoașterea explicită a unei dificultăți de comunicare și asumare a efectelor: Altman spune că OpenAI nu a explicat suficient de bine de ce consideră că dezavantajele potențiale ale tehnologiei sunt „worth it” (merită).
„Nu cred că noi [OpenAI] am făcut o treabă grozavă în a le explica oamenilor de ce credem că toate dezavantajele potențiale ale acestei tehnologii merită.” (Sam Altman)
În același registru, el a descris o stare amestecată — „excitat și fericit”, dar și cu „tristețe și melancolie” și senzația „că se termină ceva” — după ce a urmărit performanțele modelului intern.
Articolul nu oferă detalii tehnice despre modelul „Hold My Beer” (ce arhitectură are, ce capabilități exacte, ce nivel de autonomie) și nici nu confirmă explicit care rezultate publicate au fost obținute cu ajutorul lui. În lipsa unui răspuns de la OpenAI, legătura dintre modelul intern și setul de rezultate publicate rămâne, deocamdată, la nivel de sugestie din declarațiile lui Altman.
Recomandate
Declarațiile lui Sam Altman sugerează o miză economică directă: mutarea cât mai multor sarcini de inteligență artificială din PC-uri către centre de date, unde resursele pot fi folosite mai intens. Într-un interviu „la bere” acordat canalului de YouTube Cheeky Pint, citat de Tom's Hardware , CEO-ul OpenAI a spus că „inferința locală” (rularea modelelor AI direct pe dispozitivul utilizatorului) și, prin extensie, faptul că oamenii au memorie DRAM/RAM în calculatoarele de acasă este „destul de rău”. De ce contează: „utilizarea” memoriei devine argument pentru centralizare Altman își bazează poziția pe ideea de alocare globală a unei resurse limitate: memoria DRAM. Potrivit relatării, el a susținut că este ineficient ca „toată lumea” să aibă „o grămadă” din oferta limitată de DRAM în propriul computer, folosită doar o mică parte din timp. În această logică, centrele de date ar oferi o „utilizare mai bună” a resurselor, deoarece pot agrega cererea și pot menține hardware-ul ocupat mai mult timp decât un PC obișnuit. Contextul declarației și reacțiile Interviul a fost publicat de canalul de YouTube Cheeky Pint (link în materialul sursă), iar articolul notează contrastul dintre faptul că OpenAI operează centre de date „pline de memorie” și critica la adresa celor 32 GB RAM dintr-un desktop. Materialul include și reacții critice din zona de comentarii, însă acestea sunt opinii ale utilizatorilor, nu informații verificate despre piață sau despre gradul de utilizare al centrelor de date. Ce rămâne neclar Articolul nu oferă date cantitative sau dovezi independente care să susțină procentele de utilizare invocate în discuție și nici nu detaliază un plan concret al OpenAI privind limitarea inferenței locale. În forma prezentată, mesajul rămâne în primul rând o poziționare publică pro-centralizare, cu implicații evidente pentru modelul de business al furnizorilor de AI în cloud (servicii rulate în centre de date, accesate prin internet). [...]
Sam Altman susține că memoria RAM din PC-urile utilizatorilor este o risipă globală , argumentând că o resursă „oricum limitată” ar trebui concentrată în centre de date, unde poate fi folosită mai intens, potrivit WinFuture . Într-o discuție cu canalul de YouTube Cheeky Pint, CEO-ul OpenAI a spus că, din perspectiva distribuirii la nivel mondial a DRAM (memorie RAM), este „destul de îngrozitor” ca fiecare utilizator să țină o parte din această capacitate în propriul computer, în condițiile în care ar fi utilizată „poate cinci la sută din timp”. În opinia sa, aceeași memorie ar avea randament mai bun dacă ar fi „maximal utilizată” în cloud (infrastructură de calcul la distanță, în centre de date). De ce contează: presiune pe piața de memorie și un argument pro-cloud Poziția lui Altman se leagă de contextul mai larg al competiției pentru resurse hardware folosite de inteligența artificială, într-un moment în care memoria este descrisă drept „rară”. Mesajul său susține, practic, o alocare a memoriei către centrele de date, nu către dispozitivele utilizatorilor, ceea ce favorizează modelul de consum al serviciilor AI din cloud. Altman a criticat și ideea că problema ar fi rezolvată prin modele open-source rulate local, menționând că există utilizatori care vor să ruleze modele AI pe propriile sisteme și ajung să creadă că „nu avem nevoie de toate lucrurile astea în centrele de date”. Limitările și contextul omise de această abordare WinFuture notează că perspectiva este una „foarte unilaterală”, mai ales venind de la șeful unuia dintre cei mai mari furnizori de AI. Articolul punctează și un aspect practic: chiar și cele mai ieftine sisteme client (laptopuri, thin clients, smartphone-uri și tablete) nu pot funcționa fără memorie RAM, indiferent dacă utilizatorul rulează sau nu modele AI local. În esență, declarațiile lui Altman mută discuția din zona tehnică în cea de alocare a resurselor: cine „merită” memoria limitată — utilizatorii finali, cu dispozitive personale, sau operatorii de centre de date, care pot crește gradul de utilizare prin consolidare în cloud. [...]
OpenAI își extinde integrarea în ecosistemul Oracle, cu obiectivul de a aduce aplicațiile și datele Oracle direct în ChatGPT , într-o mișcare care țintește utilizarea AI în operațiuni de bază (finanțe, achiziții, planificare) și simplificarea administrării și a controlului accesului în companii, potrivit OpenAI . Parteneriatul se bazează pe relația comercială existentă dintre cele două companii, care acoperă OpenAI API, ChatGPT Work și Codex. OpenAI notează că Oracle a raportat 130.000 de utilizatori activi ChatGPT și peste 95.000 de utilizatori activi Codex. În același context, echipa de recrutare a Oracle folosește ChatGPT Work pentru cercetare de piață: o activitate care dura anterior între două și patru zile ar ajunge acum să fie pregătită în 15–20 de minute. Integrarea aplicațiilor Oracle în ChatGPT: „agent-ready enterprise” Direcția declarată este un „agent-ready enterprise”, adică un mediu în care angajații și agenții AI (software care poate executa sarcini) lucrează în aplicațiile de business într-un spațiu conectat. Obiectivul este ca software-ul Oracle să fie mai ușor de descoperit, folosit și administrat, cu: administrare simplificată, autentificare unificată, acces guvernat de permisiunile și aprobările fiecărei organizații. Miza operațională, în logica anunțului, este scalarea utilizării AI în activități esențiale și creșterea valorii obținute din aplicațiile deja folosite în companie. Oracle AI Workspace : fluxuri de lucru aprobate, într-un singur loc Oracle dezvoltă Oracle AI Workspace pentru a aduce integrarea în ChatGPT, conectând aplicațiile și datele Oracle. Scopul este ca utilizatorii să poată descrie ce au de făcut, să găsească informația relevantă și să finalizeze fluxuri de lucru de business aprobate, dintr-un singur loc. Ca exemplu, OpenAI descrie un scenariu în care un nou membru al echipei financiare ar putea folosi ChatGPT pentru a investiga costuri, a înțelege decizii de achiziție și a identifica ce mai lipsește înainte de închiderea de lună, cu informații agregate din aplicații de finanțe, achiziții și planificare, în limitele permisiunilor interne. Produse Oracle noi și actualizări construite cu modele OpenAI În paralel cu Oracle AI Workspace, Oracle anunță actualizări și oferte noi construite cu modele și instrumente OpenAI: Oracle AI Security Mesh , gândit pentru identificarea și remedierea vulnerabilităților din aplicații și infrastructură folosind modele de securitate cibernetică ale OpenAI; Oracle ar gestiona infrastructura de testare. Oracle AI SMB Bundle , care combină ChatGPT Business și Codex cu aplicații Oracle și credite recurente pentru Oracle Cloud Infrastructure, pentru a ajuta firmele mici să construiască produse și să-și gestioneze operațiunile. Oracle App Composer , destinat construirii de aplicații cu Codex și alte instrumente AI, conectate la date și fluxuri de lucru Oracle aprobate, cu distribuire internă; implementarea ar fi gestionată pe Oracle Cloud Infrastructure, cu controale de acces incluse. Achiziție prin Oracle Marketplace , pentru clienții din SUA OpenAI precizează că clienții Oracle din SUA pot cumpăra acces la OpenAI API, Codex și ChatGPT Work prin Oracle Marketplace, folosind procesele existente de achiziție și credite eligibile Oracle Universal Credits. [...]
OpenAI taie la jumătate prețul API pentru GPT-6.1 Terra , poziționând modelul ca opțiune de automatizare „la volum” pentru sarcini de birou care combină înțelegere vizuală, utilizare de aplicații și redactare, potrivit OpenAI . GPT-6.1 Terra este prezentat ca un model „rapid și eficient”, cu raționament vizual detaliat și „computer use” (capacitatea de a opera aplicații și fluxuri pe calculator), plus scriere mai naturală. Miza practică, în descrierea companiei, este reducerea costului total pentru automatizarea muncii repetitive: de la citirea facturilor primite și introducerea datelor în software de contabilitate, până la completarea de formulare sau editare video. Ce se schimbă pentru costuri: prețuri API și consum în produse OpenAI afirmă că prețurile standard din API pentru GPT-6.1 Terra sunt cu 50% mai mici decât cele ale GPT-5.6 Terra și GPT-6.1 Sol, ceea ce ar face modelul mai potrivit pentru procese cu volum mare. În paralel, în ChatGPT Work și Codex, compania spune că „același plafon de utilizare” acoperă mai multe sarcini decât în GPT‑5.6 Terra și „substanțial mai multe” decât în GPT‑6.1 Sol sau GPT‑6 Astra. Prețurile standard în API, comunicate de OpenAI, sunt: 1 dolar (aprox. 4,6 lei) per milion de tokeni de intrare; 0,05 dolari (aprox. 0,23 lei) per milion de tokeni de intrare din cache (tokeni reutilizați dintr-o intrare anterioară, pentru cost mai mic); 5 dolari (aprox. 23 lei) per milion de tokeni de ieșire. Performanță operațională: viteză și eficiență pe sarcini „de agent” Pe benchmark-ul Agents’ Last Exam (sarcini profesionale, inclusiv transformarea unor planșe arhitecturale într-un model 3D și analiză cadru cu cadru pentru log cu marcaje de timp), OpenAI susține că: la efort mediu de raționament, GPT-6.1 Terra obține un scor cu 15 puncte procentuale peste GPT-5.6 Terra, la circa o treime din cost; rulează „la nivel” cu GPT-6 Astra la o zecime din prețul per token; la efort maxim, este de peste trei ori mai eficient la tokeni decât Claude Opus 5.5 și costă un sfert per token, ceea ce ar duce la un cost per sarcină de aproximativ 9 ori mai mic; finalizează sarcini de peste trei ori mai repede decât GPT-6 Astra și GPT-6.1 Sol. OpenAI mai indică rezultate mai bune față de GPT-5.6 Terra pe MMMU-Pro (raționament vizual) și pe OSWorld 2.1 (utilizarea aplicațiilor desktop pentru sarcini în mai mulți pași), cu accent pe raportul performanță/cost. Calitate: mai puține erori factuale și salt pe sarcini de programare Compania spune că a investit în reducerea „halucinațiilor” (răspunsuri inventate sau eronate). Pe un benchmark intern de prompturi care induc erori, rata de eroare: a scăzut de la 53,6% (GPT-5.6 Terra) la 16,7% (GPT-6.1 Terra) la efort redus de raționament; a coborât la 4,3% la efort maxim, cu o reducere de 18 puncte procentuale, „aproape” de nivelurile GPT-6 Astra și GPT-6.1 Sol. Pe Terminal-Bench 4.0 (sarcini de inginerie software din linia de comandă), la efort maxim, GPT‑6.1 Terra rezolvă 50,3% dintre sarcini, față de 21,5% pentru GPT‑5.6 Terra (scor publicat). Pentru cele mai complexe sarcini de programare, OpenAI precizează că GPT-6.1 Sol și GPT-6 Astra rămân opțiuni mai bune. Siguranță și disponibilitate OpenAI afirmă că GPT‑6.1 Terra atinge pragul „Critical” în securitate cibernetică în cadrul Preparedness Framework și păstrează protecțiile dezvoltate pentru GPT‑6 Astra. Compania mai susține că modelul este mai predispus să rămână „în scop” (să nu devieze de la cererea utilizatorului), să își recunoască limitările și să reziste la prompt-injection (instrucțiuni malițioase care încearcă să deturneze sarcina). Mai multe detalii sunt disponibile în „system card”-ul dedicat: https://deploymentsafety.openai.com/gpt-6-1-terra (link menționat în sursă). Începând „de astăzi”, GPT-6.1 Terra este disponibil pentru utilizatorii Plus, Pro, Enterprise și Edu în ChatGPT Work și Codex, iar pentru dezvoltatori prin API, sub identificatorul gpt-6.1-terra . [...]
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
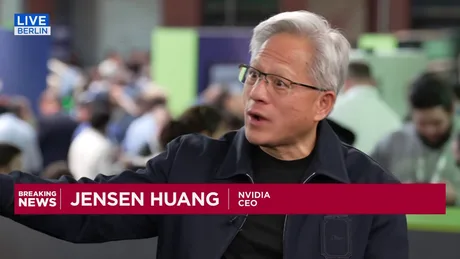
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]