Știri

Știri din categoria Tehnologie
Randamentele încă sub pragul de producție în masă țin Samsung Foundry departe de comenzi 2nm de miliarde, în condițiile în care clienții mari se uită la stabilitate și costuri înainte să rezerve capacități, potrivit SamMobile.
Problema nu este nouă: și procesul de 3 nanometri (3nm) al Samsung a avut dificultăți comerciale din cauza randamentelor (procentul de cipuri funcționale obținute dintr-un lot), în timp ce TSMC ar fi livrat randamente semnificativ mai bune și a atras majoritatea comenzilor de la giganții tech.
Un raport din Coreea de Sud, citat de publicație, indică faptul că randamentul pe 2nm al Samsung Foundry rămâne sub pragul de 60% asociat producției stabile în masă. Estimarea actuală este de aproximativ 55%, „la mică distanță” de zona considerată sigură pentru producție la scară.
În plus, când este luată în calcul procesarea „back-end” (etapele de după fabricarea pe plachetă, precum asamblarea și testarea), randamentele efective ar putea coborî spre zona de 40%, ceea ce ar însemna costuri mai mari și risc operațional pentru clienți.
Analiștii de piață citați în material susțin că un volum relevant de comenzi 2nm de la clienți mari ar urma să apară doar după ce randamentele trec de 60%. Până atunci, Samsung ar avea nevoie de timp suplimentar pentru a ajunge la nivelul cerut de producția în masă.
Contextul este cu atât mai sensibil cu cât TSMC ar avea randamente 2nm în intervalul 60–70%, iar companii precum NVIDIA, Apple și AMD și-ar produce cipurile 2nm acolo, fără să fi „rezervat” încă capacități la Samsung Foundry.
Publicația notează totuși o îmbunătățire accelerată: în urmă cu mai puțin de 12 luni, rapoarte anterioare indicau randamente „blocate” în zona de 20% în a doua jumătate a anului trecut, iar acum Samsung ar fi urcat spre 55%. Chiar și așa, miza comercială rămâne pragul de peste 60%, care ar debloca, potrivit articolului, comenzi de ordinul miliardelor de dolari.
Recomandate
Platforma NVIDIA DSX este adoptată de parteneri europeni pentru a reduce consumul de apă la răcire aproape de zero și pentru a obține același output AI cu până la 30% mai puțină energie , potrivit NVIDIA News . Miza este una operațională și de cost: eficiența energetică și constrângerile de utilități (apă, putere disponibilă, conectare la rețea) devin factorul care limitează cât de repede pot fi puse în funcțiune noi capacități de calcul pentru AI în Europa. NVIDIA descrie DSX ca o arhitectură „full-stack” pentru „fabrici AI” (centre de date optimizate pentru antrenarea și rularea modelelor), în care calculul, rețeaua, stocarea, software-ul, alimentarea electrică și răcirea sunt proiectate ca un singur sistem, de la faza de design până la operare. Răcire fără evaporare: economii de apă la scară mare Publicația susține că designurile de referință DSX folosesc răcire cu lichid în circuit închis și „dry coolers” (radiatoare industriale care disipă căldura în aer) pentru a evita evaporarea apei, mecanismul tipic al turnurilor de răcire convenționale. În acest cadru, NVIDIA afirmă că, la o implementare de 2 gigawați, economiile pot ajunge la 54 milioane litri de apă pe zi, echivalentul consumului zilnic a 180.000 de gospodării. Compania precizează însă că nevoia de răcire mecanică suplimentară depinde de climă, în perioadele cele mai calde. Eficiență energetică: aceeași producție de „tokeni” cu până la 30% mai puțină putere Pentru partea de consum electric, NVIDIA indică două componente software: DSX MaxLPS : alocă dinamic energia în limita bugetului de putere alocat, astfel încât operatorii să poată genera același număr de „tokeni” (unități de text procesate de modele) cu până la 30% mai puțină energie; alternativ, eficiența poate fi folosită pentru mai multă capacitate GPU și debit mai mare în același buget. DSX Flex : transformă centrele de date în consumatori flexibili, care pot ajusta sarcina în funcție de condițiile din rețea, evenimente de tip demand-response și prețuri la energie, cu scopul de a sprijini stabilitatea rețelei și de a facilita conectarea mai rapidă. NVIDIA enumeră companii care „plănuiesc să folosească” sau „explorează” aceste tehnologii, între care CoreWeave, Firmus, Google Cloud, IREN, Lambda, Nebius, Nscale și Sharon AI. Într-un „proof of concept” pe sisteme NVIDIA HGX B200 cu MaxLPS, Lambda ar fi obținut 24% mai mult debit de tokeni la nivel de cluster și 19% mai multă capacitate GPU în același buget de putere, conform datelor prezentate. Exemple de operare: Nscale și teste de flexibilitate pentru rețea NVIDIA oferă și un exemplu din Islanda: în urma unei evaluări în „AI factory”-ul Nscale, folosind DSX MaxLPS pe patru rack-uri NVIDIA GB300 NVL72, compania ar fi demonstrat 49% debit de inferență mai mare și 37% mai multă capacitate GPU administrată în același buget de 264 kilowați. Separat, într-un test timpuriu cu Emerald AI, EPRI, Nebius și U.K. National Grid, NVIDIA afirmă că s-au obținut reduceri de până la 40% ale consumului clusterului ca răspuns la evenimente simulate din rețea, în timp ce sarcinile critice au continuat să ruleze. Digital twins și automatizare: DSX Sim, SimReady Central și DSX OS Pentru a reduce riscul de implementare și a grăbi trecerea de la planificare la capacitate productivă, NVIDIA pune accent pe: DSX Sim pentru simulare și „digital twins” (replici digitale ale infrastructurii fizice, folosite pentru testare și optimizare înainte de instalare); lansarea SimReady Central Library pe Hugging Face, ca bibliotecă de modele validate pentru echipamente de putere și răcire; extinderea DSX OS (open-source) cu componente în „developer preview”, inclusiv Config Manager, Rack Management Service și Cluster Readiness Engine, pentru automatizarea configurării și verificarea stării clusterelor înainte de intrarea în producție. Cine intră în ecosistemul european DSX NVIDIA indică un ecosistem în extindere, de la software industrial la energie și răcire, care ar conecta designul, alimentarea, răcirea și operarea „fabricilor AI”. Sunt menționați, între alții, AVEVA, Dassault Systèmes și Siemens, precum și furnizori precum ABB, Eaton, GE Vernova, Hitachi Energy, Schneider Electric, Siemens Energy, Trane Technologies și Vertiv. De asemenea, sunt descrise inițiative punctuale: Schneider Electric ar fi dezvoltat designuri de referință pentru infrastructura NVIDIA Vera Rubin și ar lucra cu AVEVA la „digital twins” pe întreg ciclul (design–construcție–operare), iar Trane Technologies ar fi publicat șapte designuri de referință pentru management termic, inclusiv trei pentru răcire la 250 MW pe bază DSX. În ansamblu, mesajul operațional al anunțului este că eficiența la apă și energie, plus integrarea cu rețeaua electrică, devin elemente de proiectare „din fabrică” pentru noile centre de date AI din Europa, pe fondul limitărilor de utilități și al presiunii de a pune rapid capacitate nouă în funcțiune. [...]
Apple își consolidează poziția în ecosistemul de creație prin programul „ Designers of Tomorrow 2026 ”, care selectează anual designeri emergenți și le pune în prim-plan munca, într-un demers ce funcționează și ca vitrină pentru rolul produselor Apple în procesul creativ, potrivit Apple . Selecția din acest an a fost făcută de un juriu descris ca reunind „voci globale” din design, care i-a ales pe participanți pentru trei criterii: storytelling (capacitatea de a construi și transmite o poveste prin obiect), inovație în materiale și măiestrie. În componența juriului sunt menționați Alexandra Cunningham Cameron , Fabien Cappello, Jennifer Dunlop Fletcher, Minjae Kim, Hun Chung Lee, Marion Mailaender, Nifemi Marcus-Bello, Jennifer Roberts și Molly Anderson (Apple). Dincolo de componenta de recunoaștere a talentelor, Apple își leagă explicit inițiativa de propriul ecosistem: compania susține că munca participanților „evidențiază rolul dinamic” al Apple în procesul creativ, prin instrumente care îi ajută pe designeri „la orice nivel” să își capteze, rafineze și distribuie ideile către public. Materialul publicat nu include detalii despre numărul total al participanților, țările de proveniență sau calendarul programului, astfel că amploarea exactă a ediției 2026 nu poate fi evaluată doar pe baza informațiilor disponibile în sursă. [...]
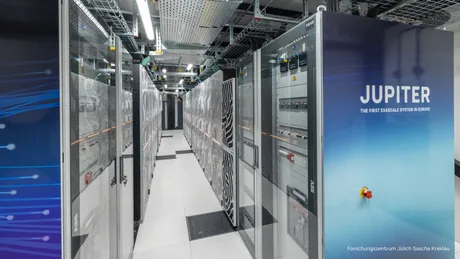
Simularea pe 104 qubiți arată că proiectarea calculului cuantic „tolerant la erori” poate fi accelerată prin testare pe supercomputere , reducând dependența de experimente costisitoare pe hardware, potrivit NVIDIA News . Cercetătorii NVIDIA au rulat pe JUPITER, primul supercomputer exascale din Europa (la Jülich Supercomputing Centre ), o simulare record a unui procesor cuantic „fault-tolerant” (tolerant la erori), la o scară care ar permite validarea unor metode ce promit să reducă masiv resursele necesare. Simularea a ajuns la 104 qubiți și este descrisă ca „cea mai mare simulare cuprinzătoare” de până acum pentru un sistem cuantic tolerant la erori, modelând în detaliu comportamentul unui procesor cuantic realist. Miza operațională este că o astfel de fidelitate oferă date pentru a estima performanța unor arhitecturi viitoare înainte de a fi construite, scurtând ciclurile de încercare–eroare în laborator. De ce contează: mai puțini qubiți fizici și proiectare mai rapidă NVIDIA susține că simularea validează o abordare de „cultivare a stărilor magice” (magic state cultivation) care ar necesita cu 90% mai puțini qubiți fizici decât metodele anterioare. În calculul cuantic tolerant la erori, „zgomotul” (erorile inevitabile introduse de controlul qubiților) obligă la folosirea unor tehnici speciale; „stările magice” sunt o configurație de qubiți consumată continuu în timpul calculelor, iar optimizarea modului în care sunt produse poate reduce semnificativ dificultatea construirii unui sistem util. Simularea a fost făcută „sub zgomot realist de hardware”, tocmai pentru a înțelege impactul erorilor asupra acestui proces. În material este menționat și un reper anterior: cercetări de la Jülich au simulat 50 de qubiți în condiții ideale, fără zgomot; noul rezultat urmărește explicit condiții mai apropiate de realitate. Cum a fost rulat proiectul: de la testare pe clustere la 8.192 GPU-uri Rularea la scară mare a fost posibilă pe o configurație cu NVIDIA GH200 superchips la Jülich. Înainte de execuția pe JUPITER, dezvoltarea s-a făcut pe un sistem NVIDIA GB200 NVL72 la NVIDIA Accelerated Quantum Research Center, folosit ca platformă pentru a scala testele de la patru GPU-uri la sute, înainte de migrarea pe 8.192 GPU-uri pe JUPITER. NVIDIA afirmă că această etapizare a redus un efort de simulare de la săptămâni la zile și a ajutat echipa să folosească mai eficient capacitatea exascale. Concluzia operațională a proiectului, așa cum este prezentată, este că simularea va deveni tot mai importantă și mai complexă pe măsură ce cresc dimensiunile sistemelor cuantice, iar clusterele de calcul accelerat pot funcționa ca „platforme de validare” înainte de a apela la supercomputere de top. Software-ul folosit și ce urmează Simulările au rulat cu software-ul NVIDIA cuQuantum , împreună cu stratul logic „fault-tolerant” din platforma NVIDIA CUDA-Q , pentru exprimarea circuitului de „magic-state”. NVIDIA indică drept resurse suplimentare un articol tehnic pe blogul GitHub despre simularea JUPITER ( GitHub blog ) și prezentări din cadrul GTC Berlin keynote și catalogul de sesiuni ( explore sessions ). [...]
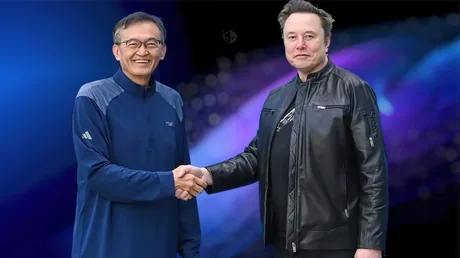
Planul lui Elon Musk pentru Terafab a trecut de la achiziții la parteneriate, după ce Intel, TSMC și Micron ar fi refuzat să vândă fabrici , potrivit Wccftech . Schimbarea de strategie contează operațional: în loc să cumpere capacitate existentă, proiectul ar urma să fie construit „de la zero”, cu o rețea de furnizori și cu acorduri punctuale cu jucători din industrie. De ce contează: execuția și controlul asupra fabricilor devin miza Materialul citează un „raport proaspăt” din presa coreeană, atribuit publicației The Elec , care susține că ritmul de execuție al Terafab i-a surprins pe mai mulți furnizori. În același timp, raportul indică faptul că inginerii ar avea autoritate de decizie în proiect, un detaliu care sugerează o structură operațională orientată spre viteză, nu doar spre conformitate corporativă. Pe fond, refuzul unor mari producători de a vinde facilități (Intel, TSMC, Micron) ar fi împins proiectul către parteneriate, ceea ce poate însemna negocieri mai dificile privind cine operează efectiv liniile de producție și cine își asumă riscurile tehnologice. Ținte de producție: mari pe hârtie, încă mici față de liderii globali Potrivit așteptărilor „observatorilor din industrie” menționate în articol, Terafab ar urmări: producție inițială de 100.000 de wafer-e pe lună înainte de 2030; scalare către 1 milion de wafer-e pe lună ca obiectiv final. Wccftech notează însă că, la nivelul producției inițiale, Terafab „abia ar conta” în industria globală. Ca termen de comparație, TSMC ar urma să producă 120.000 de wafer-e pentru tehnologia sa de fabricație de 2 nanometri până la final de 2026 (conform unui material Wccftech citat în articol). Parteneriate și furnizori: discuții în Coreea și nume mari din SUA Raportul The Elec, preluat de Wccftech, afirmă că Terafab ar fi intrat deja în discuții cu furnizori coreeni și că lucrează și cu companii americane precum Lam Research și Applied Materials . Lista de materiale și componente menționate include elemente tipice lanțului de aprovizionare pentru semiconductori: țevi, suspensii pentru lustruire (slurries), substanțe chimice de curățare și alte consumabile. Relația cu TSMC și rolul Intel: subcontractare vs. operare directă Articolul amintește că au existat informații recente despre discuții cu TSMC pentru un parteneriat, însă Musk ar fi precizat ulterior că rolul maxim al TSMC ar fi cel de subcontractor . În paralel, directorul general al TSMC, Dr. C.C. Wei, ar fi spus într-o teleconferință de rezultate că există discuții, dar că, pentru ca un parteneriat să funcționeze, TSMC trebuie să opereze fabricile . În cazul Intel, Wccftech afirmă că există un parteneriat direct: Intel ar urma să lucreze cu proiectul Terafab prin tehnologia sa de fabricație 14A (un nod tehnologic de generație viitoare). Context: Terafab, legat de nevoia de cipuri pentru vehicule autonome și roboți Wccftech plasează Terafab în planul mai larg al lui Musk de a asigura cipuri pentru vehicule autonome, roboți umanoizi și alte proiecte. Într-un podcast cu Walter Isaacson (înregistrat în august), Musk este citat susținând că „superinteligența digitală” ar putea crește producția de bunuri și servicii cu 20–30%, iar cu roboți care ar permite extinderea în spațiu economia ar putea ajunge, în viziunea sa, la „ de un milion de ori ” dimensiunea economiei Pământului. „…dacă ajungi în spațiu și faci un «mass driver» pe Lună, atunci poți ajunge, cred, potențial, la de un milion de ori dimensiunea economiei Pământului.” Ce urmează rămâne neclar din informațiile disponibile: articolul nu indică un calendar ferm pentru parteneriatele anunțate informal și nici locația sau structura exactă a Terafab, dar sugerează că proiectul avansează prin contractarea treptată a furnizorilor și prin acorduri tehnologice punctuale, nu prin achiziția unei fabrici existente. [...]
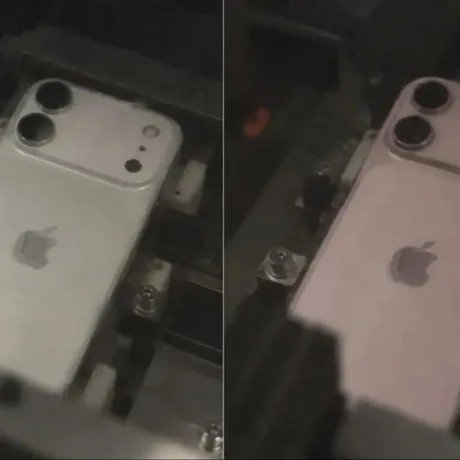
Apple ar putea separa lansarea iPhone 18 standard de modelele Pro , o schimbare cu potențial impact operațional în producție și în calendarul de vânzări, potrivit informațiilor neoficiale prezentate de Mobilissimo . Conform aceluiași material, versiunea standard ar urma să fie programată pentru primăvara lui 2027, iar producția ar putea începe spre finalul lunii noiembrie 2026. Mutarea ar însemna, dacă se confirmă, o rupere de ritmul tradițional în care întreaga gamă iPhone este prezentată în același val, cu efecte directe asupra planificării stocurilor, a lanțului de aprovizionare și a campaniilor comerciale ale partenerilor. Ce indică imaginile „din fabrică”: modul foto mai lat Imaginile apărute online ar arăta un iPhone 18 (model standard) cu un modul foto mult mai lat decât la iPhone 17, întins aproape pe toată lățimea părții superioare a carcasei. Dispunerea senzorilor ar rămâne verticală, însă integrată într-o „insulă” foto orizontală, care ar include și blițul, plus alți senzori. Designul ar aminti parțial de abordarea Apple pentru modelele Pro, dar fără a adăuga o a treia cameră. Specificații vehiculate: A20, 9 GB RAM și 256 GB stocare în baza gamei La nivel de hardware, materialul menționează că iPhone 18 ar putea veni cu: procesor Apple A20 ; 9 GB RAM și 256 GB stocare în configurația de bază; cameră frontală de 18 MP ; iOS 27 ; certificare IP68 (rezistență la apă și praf); modem Apple C2 , dezvoltat intern. Creșterea memoriei RAM este pusă în legătură cu rularea funcțiilor Apple Intelligence și cu multitasking-ul, iar noul modem ar putea aduce îmbunătățiri de eficiență energetică și conectivitate. Toate aceste detalii sunt prezentate ca informații neoficiale , neconfirmate de Apple. Calendar posibil: producție la final de 2026, lansare în primăvara lui 2027 Potrivit informațiilor citate, iPhone 18 standard ar urma să fie lansat în primăvara lui 2027 , în timp ce producția ar putea începe spre finalul lunii noiembrie 2026 . Separarea debutului modelelor Pro de cel al versiunii standard ar fi, dacă se materializează, o schimbare de strategie cu efecte în întreg ecosistemul de producție și distribuție. Sursa originală a informațiilor de pe web este atribuită de Mobilissimo publicației Gizmochina , însă Apple nu a confirmat public aceste planuri. [...]
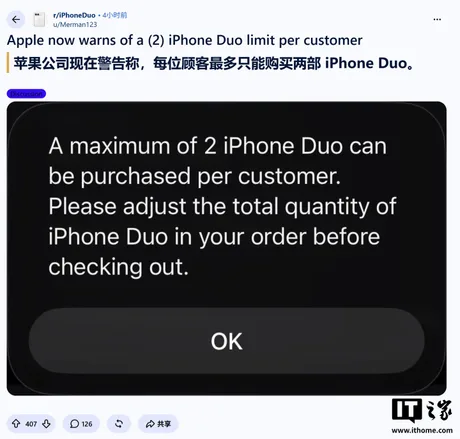
Apple a introdus în SUA o limită de 2 unități per client pentru iPhone Duo , prima sa generație de iPhone pliabil, o măsură care poate reduce cumpărăturile speculative și revânzarea la suprapreț în perioada de cerere ridicată, potrivit IT Home . Publicația notează că restricția se aplică pe site-ul Apple din SUA și în aplicația Apple Store : dacă un client încearcă să adauge mai mult de două telefoane în coș, sistemul afișează un mesaj care cere ajustarea cantității la maximum două unități. Momentul exact al introducerii limitării nu este însă confirmat. IT Home citează relatări ale unor utilizatori care spun că au reușit să cumpere patru unități, în timp ce alții susțin că, încă din 16 octombrie, la precomandă, Apple ar fi impus deja plafonul de două unități. Diferențe de afișare între SUA și China În China, limita de achiziție apare explicit pe pagina de cumpărare a iPhone Duo, unde este menționat că fiecare client poate cumpăra cel mult două unități. În SUA, aceeași informație nu ar fi afișată ca notă vizibilă pe pagină, ci apare abia când utilizatorul încearcă să depășească pragul de două unități în coșul de cumpărături. De ce contează pentru piață O astfel de limitare este, în practică, un instrument operațional prin care Apple încearcă să distribuie stocul către mai mulți cumpărători finali, în detrimentul achizițiilor în volum făcute pentru revânzare. În cazul unui produs nou, cu disponibilitate inițială potențial tensionată, plafonarea cantității per client poate influența direct: accesul consumatorilor la produs în primele săptămâni; dinamica revânzărilor pe piața secundară; presiunea pe canalele oficiale de vânzare (site și aplicație). [...]