Știri

Știri din categoria Inteligență artificială
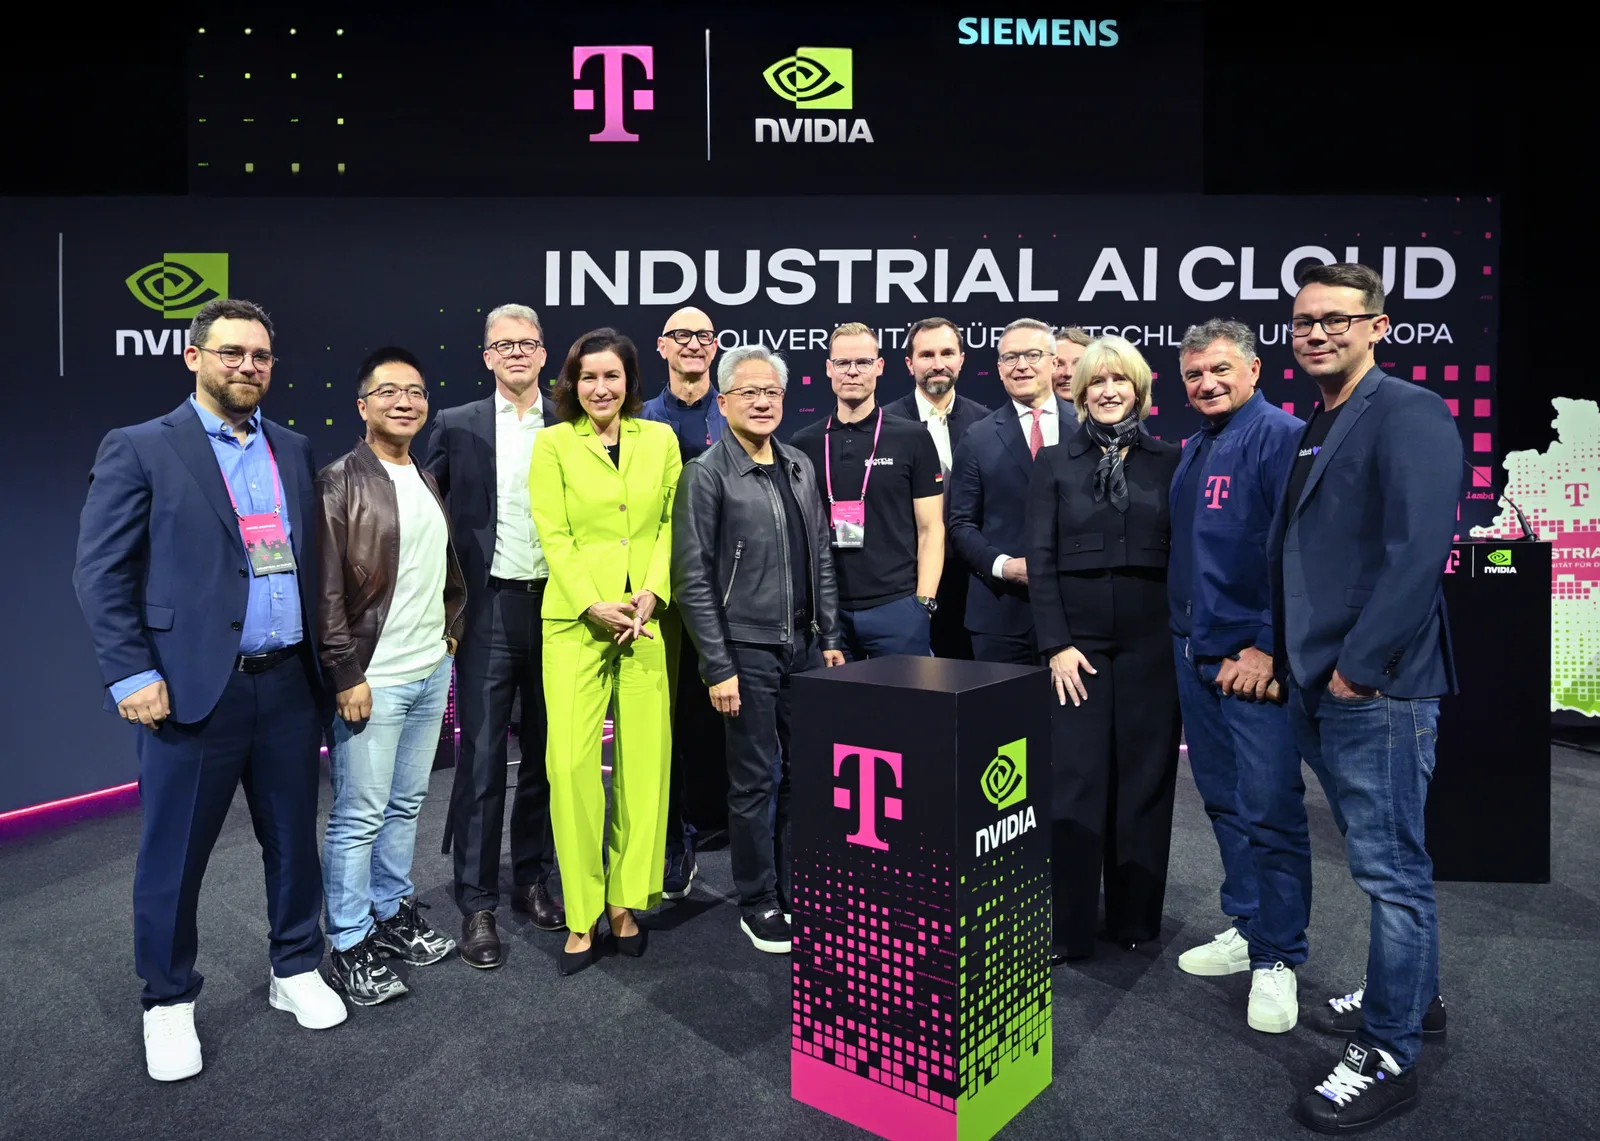
Europa a inaugurat la München una dintre cele mai mari fabrici de inteligență artificială de pe continent, marcând un pas semnificativ în eforturile de a reduce dependența de SUA și China în acest domeniu. Potrivit Ziare.com, noul hub de calcul de mare putere, numit Industrial AI Cloud, a fost dezvoltat de Deutsche Telekom în colaborare cu NVIDIA și Polarise. Acesta este echipat cu aproape 10.000 de GPU-uri NVIDIA Blackwell, oferind o putere de calcul de până la 0,5 exaFLOPS.
Proiectul are ca scop dezvoltarea și rularea aplicațiilor de inteligență artificială cu date păstrate sub jurisdicție europeană, respectând legislația germană și normele UE privind protecția datelor. Acest aspect este esențial pentru Uniunea Europeană, care dorește să creeze o infrastructură proprie pentru industrie, cercetare și sectorul public, evitând dependența de furnizorii externi.
În plus, centrul de la München pune un accent deosebit pe sustenabilitate, utilizând energie regenerabilă și răcire cu apă din râu. De asemenea, există planuri de reutilizare a căldurii reziduale pentru a sprijini zona urbană din jurul orașului. Proiectul a atras deja parteneri importanți, precum Siemens și SAP, care contribuie la dezvoltarea unui ecosistem tehnologic numit „Deutschland stack”, destinat companiilor și instituțiilor publice.
Recomandate
NVIDIA va investi 3 miliarde de dolari (aprox. 13,8 miliarde lei) în oferta de acțiuni a Meta , pe fondul extinderii colaborării dintre cele două companii pentru optimizarea modelelor Muse și a infrastructurii necesare rulării agenților de inteligență artificială, potrivit NVIDIA News . Parteneriatul vizează extinderea lucrului comun pe Muse și „familia” de modele Muse, cu accent pe îmbunătățirea performanței la inferență (rularea modelului în producție) și antrenare. În același timp, companiile urmăresc optimizări „pe fluxuri de lucru” pentru a maximiza performanța și a reduce costul total de deținere (total cost of ownership), adică ansamblul costurilor de infrastructură și operare pe durata utilizării. De ce contează: investiția leagă mai strâns Meta de ecosistemul NVIDIA Elementul cu impact economic direct este investiția de 3 miliarde de dolari în oferta de acțiuni a Meta, pe care NVIDIA spune că o va face în paralel cu extinderea colaborării tehnologice. În termeni practici, mișcarea consolidează relația comercială și tehnologică într-un moment în care Meta își accelerează ambițiile de infrastructură pentru agenți AI și modele de frontieră. Ce include extinderea colaborării tehnologice NVIDIA și Meta indică trei direcții principale: Optimizări pentru Muse : îmbunătățirea performanței la inferență și antrenare, plus optimizări pe întregul flux de lucru pentru eficiență și costuri mai mici. Securitate și monitorizare pentru agenți AI : luarea în calcul a unor colaborări pe NVIDIA OpenShell Reference Architecture , inclusiv OpenShell pentru implementare „sigură” și NVIDIA Sentry pentru monitorizarea comportamentului agenților. Extinderea implementărilor de infrastructură NVIDIA la Meta : Meta intenționează să extindă utilizarea NVIDIA Vera Rubin și Vera CPU , și să folosească NVIDIA Spectrum-X Ethernet și BlueField-4 pentru eficiență de rețea și creșterea debitului de date. Publicația mai notează că modelele și agenții Muse, care folosesc infrastructura NVIDIA, au avut performanțe de tip „frontier-level” în benchmark-uri și o creștere puternică a descărcărilor de la consumatori după lansare, fără a oferi însă cifre. Mesajul celor două companii: agenții AI, noua țintă operațională Jensen Huang , CEO NVIDIA, leagă extinderea parteneriatului de trecerea către agenți AI ca „nouă paradigmă de calcul”, în timp ce Mark Zuckerberg , CEO Meta, poziționează Muse ca vehicul pentru a duce „superinteligența personală” către utilizatori. În perioada următoare, consecința practică a anunțului ar trebui să fie accelerarea implementărilor de infrastructură NVIDIA la Meta și o integrare mai strânsă a instrumentelor de securitate și monitorizare pentru agenți, în măsura în care colaborările „luate în calcul” se concretizează. [...]
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
Anthropic își proiectează o expansiune masivă a cheltuielilor cu „puterea de calcul”, deși a raportat pe hârtie o pierdere netă de 80,7 miliarde de dolari (aprox. 371 miliarde lei) în prima jumătate din 2026 , arată un draft de prospect pentru IPO citat de CNMO . Miza pentru piață nu este atât pierderea contabilă, cât dimensiunea angajamentelor viitoare pentru infrastructură, care pot ajunge la 750 de miliarde de dolari (aprox. 3.450 miliarde lei) în următorii ani, potrivit documentului. Pierderea netă din S1 2026 este mult peste cea din perioada similară a anului trecut, când compania a raportat un minus de 13 miliarde de dolari (aprox. 60 miliarde lei). Totuși, prospectul separă explicit componenta care a „umflat” rezultatul: 72 de miliarde de dolari (aprox. 331 miliarde lei) din pierderea netă provin din cheltuieli contabile legate de variația valorii unor instrumente de finanțare, inclusiv obligațiuni convertibile. Acestea sunt prezentate ca provizioane/înregistrări contabile fără ieșire directă de numerar, deci nu echivalează automat cu o deteriorare similară a fluxului de cash din operațiuni. Pe partea operațională, compania susține o îmbunătățire a structurii financiare: în 2025, pierderea operațională a depășit 8 miliarde de dolari (aprox. 37 miliarde lei), iar în 2026 Anthropic afirmă că a trecut pe profit „ajustat” în trimestrul al doilea și a menținut profitabilitatea ajustată și în trimestrul al treilea, pentru al doilea trimestru consecutiv. În același set de informații, compania indică o marjă operațională ajustată de peste 11% și o marjă brută ajustată de 85% (indicatori „ajustați” înseamnă că exclud anumite elemente contabile/one-off, conform practicii uzuale, fără ca sursa să detalieze aici metodologia completă). Cheltuieli accelerate pentru infrastructură: 9 miliarde dolari în șase luni În paralel cu pierderea contabilă, prospectul descrie o creștere abruptă a cheltuielilor pentru capacitate de calcul și infrastructură. În prima jumătate din 2026, Anthropic ar fi cheltuit aproape 9 miliarde de dolari (aprox. 41 miliarde lei) pentru astfel de resurse, față de 2,3 miliarde de dolari (aprox. 11 miliarde lei) în S1 2025. Documentul mai notează că investiția din primele șase luni din 2026 depășește deja cheltuiala totală din 2025, de 7,3 miliarde de dolari (aprox. 34 miliarde lei). Angajamente pe termen lung: peste 600 miliarde dolari deja asumate Cifra de 750 miliarde de dolari este descrisă ca incluzând tranzacții încă în negociere. Separat, pentru cheltuieli deja asumate, prospectul indică angajamente de peste 600 miliarde de dolari (aprox. 2.760 miliarde lei) pentru acorduri legate de puterea de calcul în următorii zece ani, dintre care aproximativ 450 miliarde de dolari (aprox. 2.070 miliarde lei) ar reprezenta acorduri de cloud pentru anii 7–10, în mare parte neanulabile. Distribuția menționată în document include: aproximativ 111 miliarde dolari (aprox. 511 miliarde lei) pentru Google Cloud ; aproximativ 110 miliarde dolari (aprox. 506 miliarde lei) pentru Amazon AWS; aproximativ 31 miliarde dolari (aprox. 143 miliarde lei) pentru Microsoft; până la 86 miliarde dolari (aprox. 396 miliarde lei) pentru închirierea de cipuri Nvidia. Prospectul mai arată că Anthropic discută extinderea colaborării cu furnizorul britanic de cloud Nscale, vizând închirierea de resurse în campusul de centre de date Monarch din West Virginia, cu o capacitate suplimentară de circa 460 MW. În scenariul în care acordul se încheie, valoarea totală a angajamentelor contractuale cu Nscale ar urca la aproximativ 90 miliarde de dolari (aprox. 414 miliarde lei), conform aceleiași surse. [...]
Elon Musk susține că SpaceX a subestimat piața-țintă pentru servicii de calcul AI , după ce compania a indicat în documentele depuse pentru IPO o piață totală adresabilă (TAM – dimensiunea teoretică maximă a pieței) de 28,5 trilioane de dolari (aprox. 128 trilioane lei), potrivit Wccftech . Mesajul, publicat pe X, nu include o cifră nouă, dar ridică miza pentru narațiunea economică din jurul repoziționării SpaceX ca furnizor de infrastructură de calcul pentru inteligență artificială, nu doar ca operator de lansări și internet prin satelit. Într-o postare scurtă, Musk a afirmat că estimarea din dosarul companiei a fost greșită și că valoarea reală este „mult mai mare”, fără să ofere detalii sau metodologie. Lipsa unei actualizări cuantificabile limitează însă utilitatea afirmației pentru investitori și pentru evaluarea realistă a oportunității, mai ales în contextul în care TAM-urile sunt, prin definiție, estimări sensibile la ipoteze. Ce a spus SpaceX în documentele S1 despre piața AI Conform articolului, SpaceX a menționat în depunerea S1 că 90% din piața totală adresabilă estimată de 26,5 trilioane de dolari ar proveni din AI. În interiorul acestei componente, compania a împărțit potențialul astfel: 22,7 trilioane de dolari din aplicații AI pentru companii (enterprise); 760 miliarde de dolari din abonamente pentru consumatori; 600 miliarde de dolari din publicitate digitală. Separat, Starlink ar reprezenta cea mai mare parte din restul, cu o piață de conectivitate estimată la 1,6 trilioane de dolari. De ce contează: repoziționarea SpaceX pe infrastructura de calcul AI Punctul economic central este că SpaceX își leagă tot mai explicit povestea de creștere de infrastructura pentru AI, unde investițiile sunt masive, iar competiția se poartă pe acces la energie, cipuri și capacitate de procesare. În acest cadru, o estimare de piață „mult mai mare” ar susține o teză de expansiune agresivă și ar justifica proiecte cu cheltuieli de capital ridicate, dar fără o cifră și fără ipoteze publice rămâne, deocamdată, un semnal de poziționare, nu o recalibrare verificabilă. Proiectele invocate: centre de date și „calcul în spațiu” Wccftech leagă afirmația lui Musk de ambițiile sale de a pune online sute de mii de procesoare grafice (GPU) pentru AI în cadrul proiectului de centru de date „Colossus”. Articolul menționează că „Colossus 2”, construit în Memphis , ar urma să aducă online până la finalul anului peste 660.000 de GPU-uri NVIDIA Blackwell și că instalația rulează deja pe 550.000 de GPU-uri Blackwell GB300 și GB200. În paralel, SpaceX ar avea planuri pentru proiectul „Starmind”, descris ca o inițiativă care ar folosi sateliți pentru a livra putere de calcul, după un model inspirat de constelația Starlink. Musk ar viza lansări „încă de la finalul lui 2027”, iar SpaceX ar colabora cu NVIDIA pentru adaptarea platformei „Vera Rubin” la infrastructura din spațiu. Context: cum arată estimările de piață în zona infrastructurii AI Articolul oferă și repere din industrie: CEO-ul AMD, Lisa Su, a vorbit recent la 2026 OCP Global Summit despre o piață totală adresabilă de 1,5 trilioane de dolari pentru acceleratoare AI în centre de date, iar NVIDIA a indicat în apeluri cu investitorii un „backlog” (comenzi/cerere în așteptare) de 2 trilioane de dolari din partea marilor operatori de cloud (hyperscaleri). Pentru SpaceX, diferența este că își ancorează o parte din evaluarea potențială în ipoteza unei piețe AI de ordinul zecilor de trilioane de dolari — iar acum Musk sugerează că și această ancoră ar fi conservatoare, fără să explice de ce. [...]
Google începe testarea limitată a Genie 4 , un „world model” care poate rula simulări interactive în timp real cu audio nativ , o direcție cu potențial operațional direct pentru companii care dezvoltă agenți AI, roboți sau instrumente creative. Informațiile sunt prezentate pe Google Blog . Genie 4 este descris ca un model global („world model”) pentru simulare interactivă în timp real, cu un nivel ridicat de realism și cu generare de sunet „nativ” (adică produs direct de model, pe loc, nu adăugat ulterior). Google spune că modelul integrează și dezvoltă capabilități din familia Gemini: „Gemini Omni” ar ancora simulările în aspect și comportament din lumea reală, iar alte modele Gemini ar furniza raționamentul necesar pentru coerență și continuitate. Ce poate face Genie 4 în simulare, potrivit Google Publicația indică faptul că utilizatorii pot porni un eveniment și pot „dirija” scenele în timp real prin limbaj natural, inclusiv: mișcarea camerei, schimbarea vremii, introducerea de personaje noi. În plus, fiecare „lume” ar genera audio dinamic, inclusiv sunete ambientale, muzică și dialog interactiv. De ce contează pentru utilizare practică și industrie Google poziționează simularea lumii ca un pas important către AGI (inteligență artificială generală), menționând explicit două direcții de utilizare: medii de antrenare mai sigure pentru roboți și agenți, respectiv extinderea instrumentelor creative în industrii precum film, jurnalism, jocuri și producție. Acces: testare limitată și planuri de extindere Google spune că a început distribuirea Genie 4 către un grup restrâns de testeri „de încredere”. Următorul pas ar fi disponibilitatea „în curând” pentru abonații Google AI Ultra , în Project Genie, precum și pentru parteneri cu acces timpuriu prin Gemini API și AI Studio. Pentru demonstrații, compania trimite către blogul Google DeepMind: https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/ . [...]