Știri

Știri din categoria Inteligență artificială

OpenAI își întărește sistemul de „proveniență” a conținutului – adică semnale tehnice care arată de unde vine un material și cum a fost creat – printr-un model în mai multe straturi, menit să facă mai ușor de verificat dacă o imagine a fost generată cu instrumentele sale și să crească interoperabilitatea între platforme, potrivit OpenAI.
Miza operațională este ca aceste semnale să „supraviețuiască” după ce fișierele sunt încărcate, descărcate sau transformate (de exemplu, redimensionare ori capturi de ecran), într-un context în care conținutul generat cu AI circulă rapid și poate fi scos din context.
OpenAI spune că lucrează la standarde de proveniență din 2024, când a început să adauge „Content Credentials” (metadate semnate criptografic) la imagini generate de DALL·E 3, iar ulterior și la ImageGen și Sora. Compania a intrat și în comitetul de coordonare al Coalition for Content Provenance and Authenticity (C2PA), organizația din spatele standardului tehnic deschis folosit pentru a atașa informații verificabile despre un fișier media.
Un pas recent este obținerea statutului de „C2PA Conforming Generator Product” (produs generator conform C2PA), ceea ce ar trebui să ofere platformelor o cale „de încredere” de a citi, păstra și transmite mai departe informațiile de proveniență atașate conținutului. Argumentul central: proveniența funcționează doar dacă nu se pierde după prima platformă pe care este creat conținutul.
OpenAI adaugă și un strat de watermarking (marcare invizibilă) prin SynthID, tehnologie a Google DeepMind, pentru imagini generate prin ChatGPT, Codex sau OpenAI API. Compania precizează că metadatele pot fi eliminate sau degradate prin transformări uzuale (schimbări de format, redimensionări, capturi de ecran), iar watermarking-ul poate rămâne detectabil în mai multe astfel de situații.
OpenAI amintește că a folosit anterior:
În modelul descris, metadatele C2PA oferă context mai bogat (cum a fost creat/editat conținutul și cine a semnat informația), iar watermark-ul invizibil oferă reziliență când metadatele nu mai sunt disponibile.
Compania prezintă și o previzualizare a unui instrument public de verificare, care permite încărcarea unei imagini pentru a vedea dacă aceasta conține semnale de proveniență asociate OpenAI (inclusiv Content Credentials și SynthID). Scopul este ca utilizatorii să poată verifica mai ușor întrebarea „A fost generat cu AI?”, folosind mai multe semnale, nu unul singur.
OpenAI avertizează că nicio metodă de detecție nu este infailibilă. Dacă nu este detectat nici watermark, nici metadate, instrumentul nu va trage o concluzie definitivă că imaginea ar fi fost sau nu generată cu instrumentele OpenAI, deoarece semnalele pot fi, în unele cazuri, eliminate.
La lansare, instrumentul este limitat la conținut generat de OpenAI; în lunile următoare, compania spune că vizează eforturi „cross-industry” pentru verificare între platforme și, în timp, suport pentru mai multe tipuri de conținut.
Recomandate
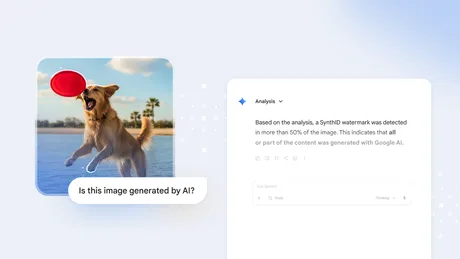
SynthID, tehnologia Google de marcare invizibilă a conținutului generat de AI, a fost inclusă pe lista TIME „Best Inventions 2026” , într-un semnal că piața începe să trateze trasabilitatea conținutului ca infrastructură, nu ca opțiune, potrivit Google Blog . Pe fondul realismului tot mai mare al conținutului generat de inteligența artificială, miza operațională pentru platforme și utilizatori este să poată distinge rapid cum a fost produs un material. În acest context, SynthID este prezentat ca un „filigran” (watermark) digital invizibil și durabil, inserat chiar în momentul creării, pentru imagini, audio, video și text, fără a afecta calitatea. Ce face SynthID și ce volum a atins Google susține că SynthID a fost folosit până acum pentru a marca: peste 180 de miliarde de imagini și videoclipuri ; echivalentul a 240.000 de ani de audio . Tehnologia este descrisă ca fiind „durabilă”, adică proiectată să rămână detectabilă și după transformări uzuale ale conținutului, fără ca materialul să fie modificat vizibil. Unde apar instrumentele de verificare Pentru identificarea conținutului generat de AI, Google spune că a integrat instrumente de verificare direct în: Google Search; aplicația Gemini; Chrome. Separat, compania indică și un instrument dedicat, SynthID Detector , disponibil la SynthID Detector , pentru verificarea conținutului provenit de la Google și partenerii săi. Extindere către biologie sintetică Google afirmă că a anunțat recent SynthID Bio , o extindere a tehnologiei de marcare către biologia sintetică, detaliată pe SynthID Bio . În material nu sunt oferite, însă, date despre adopție sau utilizări comerciale pentru această componentă. TIME a publicat includerea SynthID în selecția sa anuală la Best Inventions , iar lista completă este disponibilă pe TIME’s website . [...]
OpenAI acuză că un fost angajat a scos din companie peste 100 de fișiere confidențiale și le-a folosit la Apple , într-un episod care poate ridica miza litigiilor pe „secrete comerciale” (informații interne cu valoare economică, protejate legal) dintre giganții tech, potrivit The Verge . Într-un document depus miercuri, OpenAI susține că fostul angajat (nenumit) ar fi trimis informațiile către un cont personal înainte să plece la Apple, iar ulterior ar fi prezentat materialele conducerii Apple, inclusiv vicepreședintelui responsabil de operațiunile companiei în Asia. Dosarul apare în contextul unei dispute legale între Apple și OpenAI privind secrete comerciale, însă de această dată OpenAI este cea care formulează acuzațiile. Publicația notează că informația despre depunere a fost relatată anterior de Reuters. Ce ar conține fișierele și de ce contează operațional OpenAI afirmă că fișierele includ elemente sensibile despre planurile sale de produs, precum imagini cu cel puțin un dispozitiv nelansat, informații despre furnizori, date de inginerie, fișiere de proiect, standarde pentru finisaje și rapoarte despre „acoperirea și etanșarea componentelor hardware”. Din perspectivă operațională, astfel de detalii pot influența decizii de proiectare și lanț de aprovizionare (alegerea furnizorilor, materiale, specificații), iar OpenAI susține că există riscul ca informația să circule intern la Apple și să fie folosită de ingineri pentru a modela produse viitoare. Legătura făcută de OpenAI cu noile dispozitive Apple OpenAI leagă explicit noul ecran inteligent HomeView al Apple și alte dispozitive prezentate săptămâna aceasta de o prezentare pe care fostul angajat ar fi susținut-o cu luni în urmă. Compania susține că, având acele informații, Apple „face un nou efort” în zona produselor cu inteligență artificială integrată, invocând un articol și un anunț al companiei despre lansările recente. În același timp, The Verge amintește că planurile de produs ale Apple se derulează, de regulă, pe termene lungi, iar un astfel de ecran inteligent a fost vehiculat în zvonuri de ani de zile — un context care complică demonstrarea unei legături directe între presupusa scurgere și produsele anunțate acum. Reacții și ce urmează OpenAI afirmă că este „foarte îngrijorată” că informațiile confidențiale ar circula în interiorul Apple. Apple nu a răspuns imediat solicitării de comentariu a publicației. Următorul pas relevant va fi modul în care instanța va trata acuzațiile și ce probe vor fi acceptate privind transferul și utilizarea documentelor, într-un moment în care competiția pentru produse hardware „cu AI” aduce în prim-plan nu doar inovația, ci și protecția informațiilor interne. [...]
OpenAI spune că a blocat operațiuni de propagandă care foloseau ChatGPT și identități false de „jurnaliști” , un semnal de risc operațional pentru redacții și platforme online care pot prelua, fără verificări solide, conținut generat cu ajutorul inteligenței artificiale, potrivit Euronews . Compania afirmă că rețele legate de Iran și Rusia au utilizat modele ChatGPT pentru a crea articole, comentarii și entități-paravan, cu scopul de a răspândi narațiuni false despre conflictele din Ucraina și Orientul Mijlociu și de a „semăna diviziune” în SUA și Israel. OpenAI susține că a oprit două operațiuni distincte, una asociată Iranului și alta Rusiei. În ambele cazuri, conturile ar fi fost folosite pentru generarea de conținut și pentru construirea unor identități credibile, inclusiv pentru susținerea unor structuri de tip think-tank (grup de reflecție), utilizate ca vehicule de influențare. Cum ar fi funcționat operațiunea atribuită Iranului În cazul Iranului, OpenAI indică existența a șapte profiluri false de jurnaliști, care pretindeau că provin din țări occidentale, inclusiv din SUA. Aceste identități ar fi fost folosite pentru a plasa articole „de amploare” în publicații online din mai multe țări. OpenAI afirmă că a identificat aproape 100 de articole publicate sau preluate sub semnătura acestei operațiuni, în aproximativ 12 publicații online „mici și medii”, orientate spre afaceri internaționale, geopolitică și Orientul Mijlociu. Cel mai vechi material identificat ar fi fost publicat în iulie 2025, iar cel mai recent în octombrie 2026, cu o creștere a frecvenței după izbucnirea războiului dintre SUA și Iran, potrivit companiei. Un exemplu de identitate fictivă menționat este „Ervin B. Hoskins”, prezentat drept „scriitor american independent”, cu conturi pe mai multe platforme, inclusiv X și Instagram. OpenAI susține că datele de transparență ale platformelor indicau conexiuni tehnice și de localizare către Iran și că a publicat dovezi în acest sens. Operațiunea atribuită Rusiei: think-tank și recrutări în America Latină Pentru Rusia, OpenAI afirmă că operațiunea ar fi cooptat „persoane neștiutoare” din America Latină pentru a conduce un think-tank numit Centrul de Cercetări Sociale (SRC). Structura ar fi fost folosită pentru activități menite să submineze reputația Ucrainei în regiune și să influențeze politica locală. În comunicatul citat de Euronews, OpenAI susține că angajații SRC nu ar fi știut că lucrează pentru o grupare rusească și descrie cazul drept „cea mai complexă încercare de a opera o identitate-paravan” pe care compania ar fi dejucat-o în ultimii doi ani și jumătate. Potrivit OpenAI, operatorii au folosit ChatGPT pentru: redactarea de rapoarte interne despre activități; crearea de conținut pentru operațiuni; elaborarea de rapoarte de performanță ale think-tank-ului; conceperea de texte pentru postări și comentarii pe rețele sociale. Printre temele abordate pe rețelele sociale s-ar fi numărat și reacții la o propunere atribuită europarlamentarului polonez de extremă dreapta Grzegorz Braun, prezentată ca încercare de a alimenta diviziuni în Polonia privind sprijinul pentru Ucraina. De ce contează pentru redacții și platforme Cazul descris de OpenAI indică o presiune în creștere asupra mecanismelor de verificare editorială și a moderării pe platforme: conținutul generat cu ajutorul IA poate fi ambalat în „semnături” și profiluri aparent credibile și apoi redistribuit prin publicații care preiau materiale externe. În lipsa unor detalii suplimentare despre publicațiile vizate și despre metodologia completă de atribuire, rămâne de urmărit în ce măsură aceste operațiuni vor duce la măsuri suplimentare de verificare a autorilor și a surselor, atât în media, cât și pe rețelele sociale. [...]
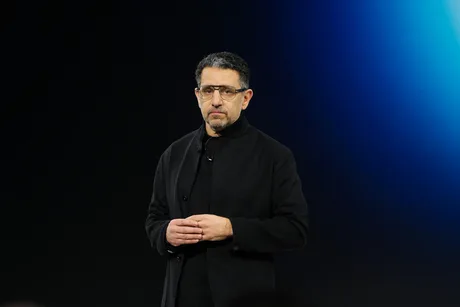
Amazon mizează pe „dispozitive ambientale” cu AI care ar putea reduce dependența de aplicații , iar pariul are implicații operaționale directe: hardware care rulează „în fundal”, captează context din viața utilizatorului și livrează automat sarcini, mementouri și informații. La TechCrunch Disrupt, Panos Panay , SVP Devices, Alexa & Leo, a descris această direcție ca următorul pas în calculul personal, potrivit TechCrunch . Panay a susținut că interacțiunea actuală cu smartphone-ul presupune ca utilizatorul „să-și amintească” ce să ceară dispozitivului, în timp ce viitorul ar porni de la „dispozitive ambientale” care folosesc senzori și inteligență artificială pentru a identifica ce e de făcut, fără comenzi explicite. „Cred că ne îndreptăm spre o lume care începe cu dispozitive ambientale.” Ce înseamnă „ambient” în viziunea Amazon: Bee, înregistrare pasivă și note automate Cea mai concretă intrare a Amazon în această zonă este setul de dispozitive Bee prezentat joi: o brățară purtabilă (care poate fi detașată și purtată ca pandantiv) și un dispozitiv de mărimea unui card, care se prinde magnetic pe spatele smartphone-ului. TechCrunch le leagă de lansarea noilor purtabile AI Bee (context publicat separat, în același site). Funcțional, aceste gadgeturi: înregistrează pasiv audio și generează note despre zi; extrag „to-do”-uri, mementouri și „insight”-uri (informații utile) la care utilizatorul poate reveni ulterior. Miza operațională: AI care „înțelege ce ai nevoie”, nu „dă-mi aplicația” Panay a descris o tranziție în care cererea „dă-mi aplicația pentru asta” devine mai puțin relevantă, pe măsură ce tot mai multe sarcini sunt rezolvate prin AI, pe baza contextului captat de senzori. „Da, cred că transformarea asta vine. Cred că asta este următoarea generație.” În același timp, el a nuanțat că nu vede un singur tip de dispozitiv care să înlocuiască toate celelalte (de exemplu, smartphone-ul), ci mai degrabă un „strat de inteligență” care le conectează și trebuie să fie util în practică. Confidențialitatea, condiție de funcționare pentru dispozitivele care „ascultă” Pentru a limita riscurile de confidențialitate, TechCrunch notează că dispozitivele Bee nu stochează audio brut din conversații: procesează în timp real și șterg apoi. Transcrierile sunt criptate cu chei create și controlate de dispozitiv, iar accesul altor persoane — inclusiv angajați Amazon — nu ar fi posibil fără partajare intenționată din partea utilizatorului. Panay a spus că protecția datelor a fost o considerentă-cheie în proiectarea acestor dispozitive și că utilizatorii trebuie să aibă control. „Trebuie să le oferi clienților acel control.” [...]
Peste 400 de publicații au intrat într-un program prin care Google plătește licențe pentru conținut folosit la dezvoltarea de funcții noi bazate pe inteligență artificială , potrivit Google . Miza pentru editori este una direct economică: compania spune că remunerează livrarea și utilizarea unui „conținut îmbunătățit” (enhanced content) în cadrul News AI pilot . Programul, lansat anul trecut, a pornit cu un grup de parteneri din zona media, iar acum a depășit pragul de 400 de publicații la nivel global. În lista de exemple menționate de Google apar atât nume mari, cât și editori locali. Între partenerii noi enumerați se află publicații internaționale precum Axios , CNN, Financial Times și Forbes, dar și editori locali din SUA, precum Post and Courier, Texas Tribune, Oil City News și Shaw Media. Google amintește și parteneri din etapa inițială, precum The Washington Examiner și The Washington Post. Ce cumpără Google și la ce folosește conținutul Google descrie inițiativa ca un program de licențiere: publicațiile participante sunt plătite pentru „livrarea și utilizarea” conținutului îmbunătățit, utilizat pentru a dezvolta funcții noi de inteligență artificială în produsele companiei. Exemplele de funcții menționate includ: prezentări detaliate ale articolelor (overviews) pe paginile editorilor din Google News, care oferă context înainte ca utilizatorul să dea click; buletine audio personalizabile (audio briefings) pentru ascultători. Google susține că aceste funcții includ atribuire „clară” și linkuri directe către surse, cu scopul de a crea „noi moduri” prin care cititorii să se conecteze la publicațiile pe care le urmăresc. Ce urmează Din informațiile publicate nu reiese valoarea plăților sau criteriile comerciale ale licențelor. Google indică însă că programul este folosit ca bază pentru dezvoltarea de funcții AI în zona de știri, pe măsură ce obiceiurile de consum de informație se schimbă. [...]
CERN și Mistral AI au convenit un parteneriat strategic pe termen lung pentru dezvoltarea unui model fundamental de inteligență artificială, cu miză operațională directă în accelerarea descoperirilor științifice , potrivit Agerpres , care citează Reuters. Colaborarea vizează crearea „Flare”, descris ca un nou model de inteligență artificială destinat fizicii. În formularea din material, cele două organizații urmăresc dezvoltarea unui „model fundamental” (adică un model de bază, antrenat pe volume mari de date, care poate fi adaptat ulterior pentru sarcini specifice) orientat către descoperiri științifice. Informațiile disponibile public din fluxul Agerpres sunt limitate, deoarece articolul integral este accesibil doar abonaților. În consecință, nu sunt precizate detalii despre calendar, buget, modul de utilizare sau aria exactă de aplicații în fizică. [...]