Știri

Știri din categoria Inteligență artificială
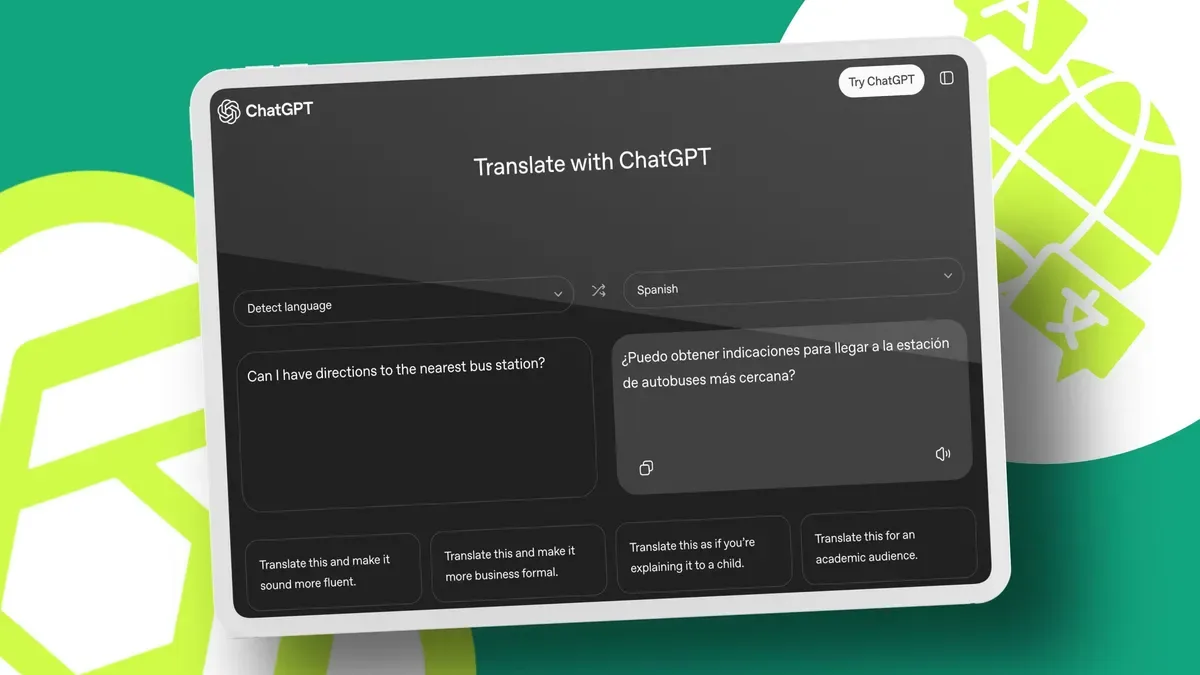
OpenAI a lansat ChatGPT Translate, un instrument web gratuit de traducere, potrivit PhanDroid, într-o mișcare care vizează direct poziția dominantă a Google Translate. Lansarea a fost făcută discret, fără un anunț major, iar produsul este disponibil ca serviciu separat, în browser.
Noul instrument promite traduceri mai „conștiente de context” decât traducătoarele clasice care înlocuiesc cuvinte, cu posibilitatea de a ajusta tonul rezultatului. Utilizatorii pot cere, de exemplu, o formulare „formală pentru mediul de afaceri” sau una „pe înțelesul unui copil”, iar apoi pot continua rafinarea în conversații complete în ChatGPT.
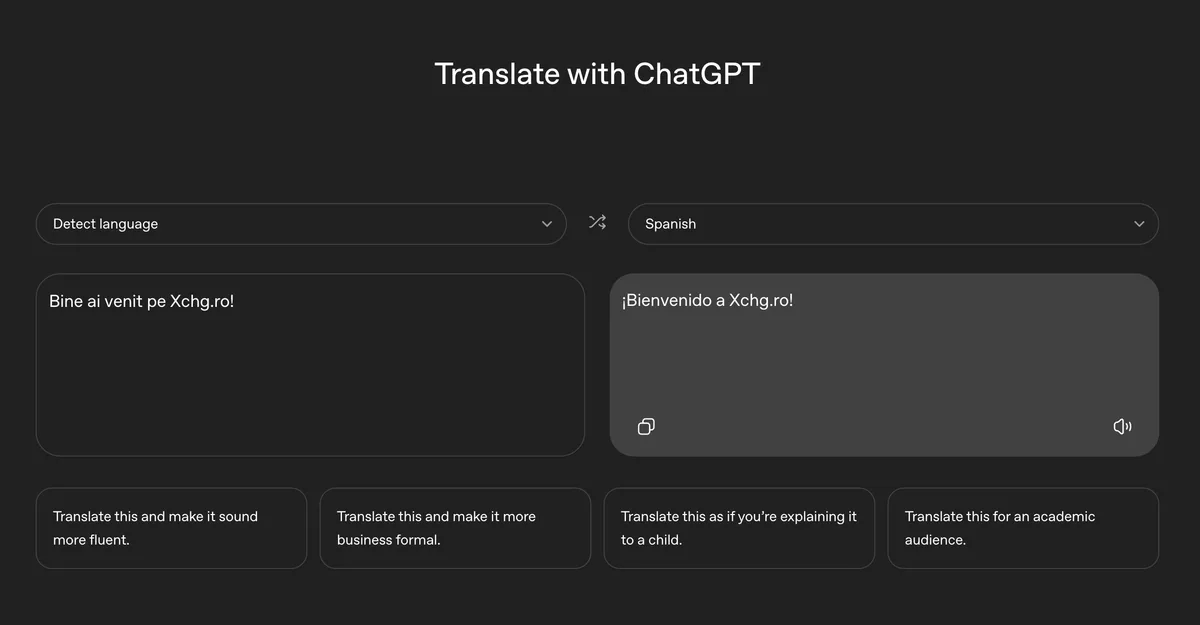
Interfața este simplă, cu două câmpuri (text sursă și text tradus), iar detectarea automată a limbii reduce pașii necesari pentru utilizare. La lansare sunt disponibile 28 de limbi prin meniuri derulante, iar funcțiile includ traducere de text și suport pentru voce în browserele mobile; traducerea din imagini sau fișiere este menționată ca funcționalitate „în curând”.
Pentru utilizarea de bază nu este necesar un cont, însă autentificarea deblochează opțiuni suplimentare de stil (de tipul „mai fluent” sau „explică pe înțelesul unui copil”), care trimit utilizatorul către ChatGPT pentru editări interactive. Publicația descrie produsul ca fiind, în acest stadiu, „doar web” și cu un aer de prototip, comparând abordarea cu testele anterioare făcute de OpenAI înainte de integrarea unor idei în ChatGPT.
Din perspectiva utilității, phandroid.com notează că, deși Google Translate acoperă deja documente, site-uri și imagini, ChatGPT Translate ar putea câștiga teren la capitolul nuanțe (idiomuri, ton, context), în special pentru e-mailuri, conversații sau situații de călătorie. În același timp, articolul atrage atenția asupra modului de utilizare a datelor: varianta gratuită ar putea trata informațiile diferit față de opțiunile plătite care includ setări de confidențialitate.
Recomandate
Mii de agenți AI pot comprima luni de analiză biologică în zeci de minute , arată un experiment descris de OpenAI , cu implicații directe pentru productivitatea cercetării și pentru felul în care sunt prioritizate experimentele în neuroștiințe și boli neurodegenerative. Într-o demonstrație realizată împreună cu PerturbAI și Scripps Research , echipa a folosit mii de agenți AI bazați pe GPT‑Rosalind pentru a interpreta date existente din milioane de celule din creierul de șoarece în 32 de minute. Miza operațională este reducerea blocajului dintre „datele produse” și „datele înțelese”: experimentele moderne pot modifica mii de gene și măsura efectele în milioane de celule, însă conectarea rezultatelor cu literatura științifică acumulată în decenii rămâne lentă și fragmentată. Abordarea propusă încearcă să scaleze tocmai această muncă de interpretare, nu doar procesarea brută. Cum funcționează „raționamentul biologic distribuit” Metoda împarte sarcina între mii de agenți AI, fiecare responsabil de o perturbare genetică. Agenții: investighează efectele unei perturbări asupra răspunsurilor celulare; caută și corelează rezultate relevante din literatura științifică; propun explicații și mecanisme biologice posibile. Rezultatele sunt agregate într-un „atlas de raționament” care leagă gene, efecte celulare, publicații relevante și ipoteze de mecanism. Analiza a folosit un „atlas CRISPR” la nivelul întregului creier (un set de date despre efectele perturbărilor genetice în diferite tipuri de celule din creierul de șoarece). De ce contează: randament mai mare la aceeași resursă și acoperire mai bună a literaturii Echipa estimează că o analiză umană comparabilă, făcută „câte o perturbare pe rând”, ar dura de la luni până la un an. În plus, testele interne au comparat un singur agent care primește întregul volum de lucru cu varianta distribuită, păstrând modelul și resursele fixe: pe măsură ce sarcina a crescut, agentul unic a acoperit tot mai puțin din literatură, ajungând să citeze 11 referințe la cel mai mare volum, în timp ce agenții distribuiți au citat peste 700 de referințe. În evaluări „în orb” (fără ca evaluatorii să știe ce variantă analizează), experții umani au preferat rapoartele generate de agenții distribuiți în 75% din cazuri. Potrivit descrierii, agenții au reprodus concluzii din analize umane și au identificat și piste suplimentare, iar evaluările lor privind noutatea și valoarea științifică au fost aliniate cu judecăți ale experților umani. Exemple de piste biologice identificate Materialul oferă câteva exemple de conexiuni pe care agenții le-au scos în evidență și care ar putea ghida experimente ulterioare: diferențe neașteptate între Tsc1 și Tsc2 (gene care controlează mTOR) în cerebel: perturbarea Tsc2 a modificat activitatea a zeci de gene implicate în comunicarea neuronală, în timp ce perturbarea Tsc1 a produs schimbări minime în aceeași zonă; o ipoteză legată de DCTN1 (genă asociată cu sindromul Perry, boală neurodegenerativă cu simptome asemănătoare Parkinson): perturbarea Dctn1 a crescut expresia genelor implicate în sinteza colesterolului, iar agenții au conectat observația cu cercetări care sugerează că problemele de transport al colesterolului pot determina celulele să producă mai mult colesterol. Ipoteza de testat: dacă perturbarea DCTN1 schimbă distribuția colesterolului în neuroni și dacă asta contribuie la neurodegenerare. Ce urmează: acces la rezultate și limitări implicite OpenAI notează că „atlasul de raționament” este disponibil public, astfel încât cercetătorii pot compara gene înrudite, investiga răspunsuri neașteptate și selecta piste promițătoare pentru experimente. În același timp, concluziile prezentate sunt formulate ca direcții de cercetare și ipoteze care necesită validare în laborator, nu ca rezultate clinice. [...]
OpenAI își extinde modelul de monetizare prin reclame, ducând ChatGPT Ads la 89 de țări și consolidând o sursă de venit menită să susțină accesul gratuit sau cu cost redus la serviciu, potrivit OpenAI . Compania spune că, la puțin peste opt luni de la lansare, peste 100.000 de agenți de publicitate au rulat campanii pe platformă, în condițiile în care ChatGPT este folosit săptămânal de peste 1,2 miliarde de persoane. Extinderea vizează 26 de țări noi și se bazează pe lansări recente în Europa și în Asia de Sud-Est și Taiwan. OpenAI precizează că reclamele vor fi afișate doar în planurile Free și Go, în timp ce abonamentele Plus, Pro și Enterprise rămân fără reclame. Unde se extinde și cum pot intra advertiserii După lansările din Mexic și Brazilia, OpenAI aduce ChatGPT Ads în încă 14 țări din America Latină, menționând explicit Argentina, Chile, Columbia și Peru. În paralel, compania intră și în piețe din Europa, Orientul Mijlociu, Africa și Asia, inclusiv Nigeria, Africa de Sud, Serbia, Ucraina, Cambodgia, Bangladesh și Pakistan. Accesul la ChatGPT Ads se face fie prin parteneri tehnologici, fie prin opțiunea de autoservire din Ads Manager . Ce promite OpenAI despre date și separarea reclamelor de răspunsuri OpenAI afirmă că abordarea sa este ghidată de „principiile pentru publicitate” și că păstrează conversațiile private față de agenții de publicitate, fără să vândă datele clienților. Reclamele sunt etichetate și separate de răspunsurile ChatGPT, iar publicitatea „nu influențează” răspunsurile oferite de model, conform principiilor detaliate de companie în materialul dedicat: ads principles . Ce urmează: formate noi și măsurare mai avansată Cu ChatGPT Ads disponibil în 89 de țări, următoarea etapă de creștere vizează dezvoltarea de formate suplimentare, obiective, opțiuni de cumpărare și capabilități de măsurare. OpenAI mai spune că explorează și modalități „mai native” prin care companiile să interacționeze cu consumatorii în ChatGPT. [...]
OpenAI alocă 5 milioane de dolari (aprox. 23 milioane lei) pentru a finanța verificarea și dezvoltarea rezultatelor matematice generate de AI , într-o mișcare menită să reducă tensiunile din comunitatea academică după acuzații de plagiat legate de o problemă veche de aproape un secol, potrivit Antena 3 . Donația merge către fundația Simons , axată pe matematică, și vine după ce Asociația pentru Matematică Umană (AHM) a criticat compania de inteligență artificială pentru modul în care a comunicat „rezolvarea” unei probleme majore din matematică, în contextul în care au apărut suspiciuni că rezultatele s-ar fi bazat pe munca altor cercetători. De ce contează: bani pentru „audit” științific al rezultatelor produse de AI OpenAI spune că finanțarea are ca scop să „ajute matematicienii să examineze, să înțeleagă și să dezvolte rezultatele produse de inteligența artificială”, inclusiv rezultate publicate recent. Practic, compania încearcă să mute discuția din zona de dispută privind prioritatea științifică într-un cadru de evaluare și validare făcut de comunitatea de specialitate. În postarea de pe rețeaua X, OpenAI a transmis că vrea să sprijine transformarea progreselor din AI „într-o înțelegere umană mai profundă și în noi descoperiri”. Contextul acuzațiilor: Navier–Stokes și disputa privind prioritatea În septembrie, OpenAI a anunțat că un model AI nelansat încă ar fi rezolvat o problemă majoră legată de ecuațiile Navier–Stokes , asociate cu descrierea mișcării fluidelor pe baza celei de-a doua legi a lui Newton. Potrivit materialului, problema îi pune în dificultate pe matematicieni de aproape un secol. Conform TechCrunch, doi matematicieni au spus că erau aproape de un rezultat similar și au pus sub semnul întrebării dacă activitatea OpenAI s-a bazat pe munca lor. OpenAI a negat că ar fi văzut lucrările acestora. Unul dintre matematicieni, Levent Alpöge, lucrează la Anthropic și colabora în nume propriu. AHM a criticat public demersul OpenAI, afirmând că: „Matematicienii nu au cerut ca această muncă să fie făcută” și acuzând compania de „totală lipsă de respect față de normele cercetării științifice”. Cum vor fi folosiți banii și ce mai include pachetul de finanțare OpenAI precizează că cei 5 milioane de dolari vor finanța: „ateliere, conferințe și programe speciale”; acces la modelele OpenAI și la resurse de calcul pentru cercetătorii sprijiniți de fundația Simons. Inițiativa are, în total, finanțare și resurse de 15 milioane de dolari, oferite împreună de fundația Simons, Anthropic și OpenAI, potrivit articolului. [...]
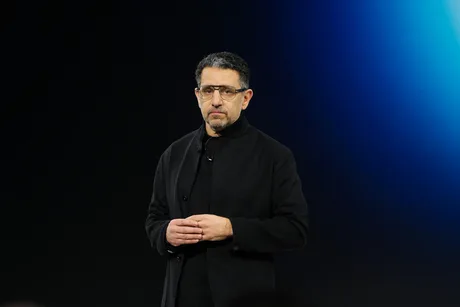
Amazon mizează pe „dispozitive ambientale” cu AI care ar putea reduce dependența de aplicații , iar pariul are implicații operaționale directe: hardware care rulează „în fundal”, captează context din viața utilizatorului și livrează automat sarcini, mementouri și informații. La TechCrunch Disrupt, Panos Panay , SVP Devices, Alexa & Leo, a descris această direcție ca următorul pas în calculul personal, potrivit TechCrunch . Panay a susținut că interacțiunea actuală cu smartphone-ul presupune ca utilizatorul „să-și amintească” ce să ceară dispozitivului, în timp ce viitorul ar porni de la „dispozitive ambientale” care folosesc senzori și inteligență artificială pentru a identifica ce e de făcut, fără comenzi explicite. „Cred că ne îndreptăm spre o lume care începe cu dispozitive ambientale.” Ce înseamnă „ambient” în viziunea Amazon: Bee, înregistrare pasivă și note automate Cea mai concretă intrare a Amazon în această zonă este setul de dispozitive Bee prezentat joi: o brățară purtabilă (care poate fi detașată și purtată ca pandantiv) și un dispozitiv de mărimea unui card, care se prinde magnetic pe spatele smartphone-ului. TechCrunch le leagă de lansarea noilor purtabile AI Bee (context publicat separat, în același site). Funcțional, aceste gadgeturi: înregistrează pasiv audio și generează note despre zi; extrag „to-do”-uri, mementouri și „insight”-uri (informații utile) la care utilizatorul poate reveni ulterior. Miza operațională: AI care „înțelege ce ai nevoie”, nu „dă-mi aplicația” Panay a descris o tranziție în care cererea „dă-mi aplicația pentru asta” devine mai puțin relevantă, pe măsură ce tot mai multe sarcini sunt rezolvate prin AI, pe baza contextului captat de senzori. „Da, cred că transformarea asta vine. Cred că asta este următoarea generație.” În același timp, el a nuanțat că nu vede un singur tip de dispozitiv care să înlocuiască toate celelalte (de exemplu, smartphone-ul), ci mai degrabă un „strat de inteligență” care le conectează și trebuie să fie util în practică. Confidențialitatea, condiție de funcționare pentru dispozitivele care „ascultă” Pentru a limita riscurile de confidențialitate, TechCrunch notează că dispozitivele Bee nu stochează audio brut din conversații: procesează în timp real și șterg apoi. Transcrierile sunt criptate cu chei create și controlate de dispozitiv, iar accesul altor persoane — inclusiv angajați Amazon — nu ar fi posibil fără partajare intenționată din partea utilizatorului. Panay a spus că protecția datelor a fost o considerentă-cheie în proiectarea acestor dispozitive și că utilizatorii trebuie să aibă control. „Trebuie să le oferi clienților acel control.” [...]
OpenAI acuză că un fost angajat a scos din companie peste 100 de fișiere confidențiale și le-a folosit la Apple , într-un episod care poate ridica miza litigiilor pe „secrete comerciale” (informații interne cu valoare economică, protejate legal) dintre giganții tech, potrivit The Verge . Într-un document depus miercuri, OpenAI susține că fostul angajat (nenumit) ar fi trimis informațiile către un cont personal înainte să plece la Apple, iar ulterior ar fi prezentat materialele conducerii Apple, inclusiv vicepreședintelui responsabil de operațiunile companiei în Asia. Dosarul apare în contextul unei dispute legale între Apple și OpenAI privind secrete comerciale, însă de această dată OpenAI este cea care formulează acuzațiile. Publicația notează că informația despre depunere a fost relatată anterior de Reuters. Ce ar conține fișierele și de ce contează operațional OpenAI afirmă că fișierele includ elemente sensibile despre planurile sale de produs, precum imagini cu cel puțin un dispozitiv nelansat, informații despre furnizori, date de inginerie, fișiere de proiect, standarde pentru finisaje și rapoarte despre „acoperirea și etanșarea componentelor hardware”. Din perspectivă operațională, astfel de detalii pot influența decizii de proiectare și lanț de aprovizionare (alegerea furnizorilor, materiale, specificații), iar OpenAI susține că există riscul ca informația să circule intern la Apple și să fie folosită de ingineri pentru a modela produse viitoare. Legătura făcută de OpenAI cu noile dispozitive Apple OpenAI leagă explicit noul ecran inteligent HomeView al Apple și alte dispozitive prezentate săptămâna aceasta de o prezentare pe care fostul angajat ar fi susținut-o cu luni în urmă. Compania susține că, având acele informații, Apple „face un nou efort” în zona produselor cu inteligență artificială integrată, invocând un articol și un anunț al companiei despre lansările recente. În același timp, The Verge amintește că planurile de produs ale Apple se derulează, de regulă, pe termene lungi, iar un astfel de ecran inteligent a fost vehiculat în zvonuri de ani de zile — un context care complică demonstrarea unei legături directe între presupusa scurgere și produsele anunțate acum. Reacții și ce urmează OpenAI afirmă că este „foarte îngrijorată” că informațiile confidențiale ar circula în interiorul Apple. Apple nu a răspuns imediat solicitării de comentariu a publicației. Următorul pas relevant va fi modul în care instanța va trata acuzațiile și ce probe vor fi acceptate privind transferul și utilizarea documentelor, într-un moment în care competiția pentru produse hardware „cu AI” aduce în prim-plan nu doar inovația, ci și protecția informațiilor interne. [...]
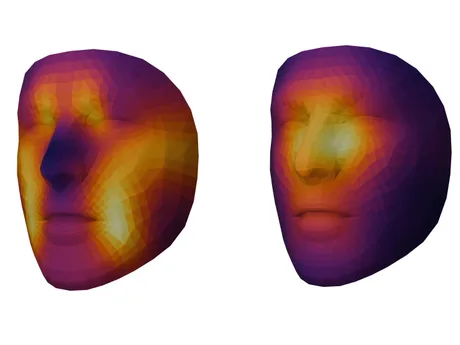
Un model de inteligență artificială poate estima vârsta biologică și riscul de deces la pacienți oncologici dintr-o fotografie facială , însă utilitatea sa clinică reală și limitele de aplicare rămân încă neclare, potrivit Notebookcheck . Tehnologia, prezentată într-un studiu din „ The Lancet Digital Health ”, ridică atât perspectiva unor evaluări medicale cu bariere de intrare foarte mici, cât și întrebări despre validare, interpretabilitate și potențiale utilizări abuzive. Ce face modelul și pe ce date a fost antrenat Cercetătorii au dezvoltat un model numit FAHR-Face (Foundation Artificial Intelligence for Health Recognition), antrenat pe peste 40 de milioane de imagini faciale și adaptat ulterior pentru două sarcini distincte: estimarea „vârstei biologice” din trăsături faciale (care poate diferi de vârsta cronologică și ar putea indica starea generală de sănătate și reziliența fizică); estimarea riscului de supraviețuire la pacienți cu cancer pe baza unei fotografii, cu zone considerate relevante în special sub ochi și de-a lungul punții nasului. Rezultatele raportate pe pacienți cu cancer Evaluarea a inclus aproximativ 43.000 de pacienți oncologici, iar un test separat a fost realizat pe 3.820 de pacienți. În acest test: 122 de pacienți au fost încadrați de model în grupa cu risc maxim; dintre aceștia, 52% au murit în 90 de zile; 975 de pacienți au fost încadrați în grupa cu risc minim; dintre aceștia, 2% au murit în același interval. Autorii notează că asocierea dintre informația extrasă din fotografie și riscul de deces a rămas valabilă chiar și după luarea în calcul a factorilor clinici de prognostic. De ce contează: costuri mici, dar validare incompletă și risc de abuz Miza operațională a unei astfel de abordări este bariera scăzută de utilizare: o fotografie facială poate fi făcută în câteva secunde, cu costuri tehnice și financiare reduse, ceea ce ar putea accelera adoptarea în instrumente de triere sau monitorizare. În același timp, materialul subliniază limite importante: nu este stabilită o relație cauzală; modelul identifică tipare statistice, fără să explice automat procesele biologice din spatele lor; nu este clar dacă rezultatele se aplică și altor afecțiuni medicale; rămâne de văzut câtă valoare predictivă suplimentară aduce fotografia față de metodele clinice consacrate; există îngrijorări privind posibile utilizări precum urmărirea și supravegherea video. Test public: cum poate fi încercat modelul Cei care vor să își estimeze vârsta biologică se pot înscrie pe site-ul proiectului, unde pot încărca între 3 și 10 fotografii ale feței, o singură dată sau zilnic. Sistemul oferă un scor pentru fiecare imagine și un scor agregat. Conform descrierii, fotografiile nu sunt partajate și sunt șterse după o anumită perioadă, iar alte informații sunt anonimizate și puse la dispoziția altor cercetători. [...]