Știri

Știri din categoria Inteligență artificială
OpenAI lansează GPT-5.5 ca model mai eficient pentru lucru și programare, mizând pe reducerea costului operațional (prin folosirea a mai puțini „tokeni”, unități de text procesate) și pe automatizarea unor sarcini mai complexe în ChatGPT și Codex, potrivit The Verge.
Compania spune că GPT-5.5 este „cel mai inteligent și cel mai intuitiv de folosit” model al său și îl prezintă ca un pas spre „un nou mod de a face muncă pe un computer”. După GPT-5.4, lansat luna trecută, OpenAI susține că noul model „excelează” la scriere și depanare de cod, cercetare online, realizarea de foi de calcul și documente, inclusiv atunci când trebuie să lucreze „peste” mai multe instrumente.
„În loc să gestionezi cu grijă fiecare pas, îi poți da lui GPT-5.5 o sarcină dezordonată, în mai multe părți, și să ai încredere că va planifica, va folosi instrumente, își va verifica munca, va naviga prin ambiguitate și va continua”, potrivit OpenAI.
Un element cu impact direct pentru utilizare și costuri este eficiența: OpenAI afirmă că GPT-5.5 poate folosi „semnificativ mai puțini” tokeni pentru a finaliza sarcini în Codex. Compania mai spune că modelul vine cu „cel mai puternic set de măsuri de siguranță de până acum”, fără a detalia în material ce presupun aceste măsuri.
GPT-5.5 începe să fie distribuit începând de joi pentru abonamentele ChatGPT Plus, Pro, Business și Enterprise, precum și în Codex. OpenAI mai precizează că GPT-5.5 Pro va ajunge la utilizatorii Pro, Business și Enterprise.
Lansarea vine într-un moment de competiție accelerată între OpenAI și Anthropic, pe fondul unei curse spre o posibilă listare publică „mai târziu în acest an”, notează publicația. În acest context, ambele companii încearcă să câștige teren pe segmentul de programare asistată de AI și instrumente pentru companii, iar OpenAI ar fi redus recent așa-numitele „side quests” (proiecte secundare) pentru a se concentra pe surse mai mari de venit.
Separat, The Verge menționează că apariția GPT-5.5 are loc cu câteva zile înaintea procesului dintre Elon Musk și executivi OpenAI Sam Altman și Greg Brockman, care ar urma să înceapă luni, într-o instanță federală din Oakland, California.
Recomandate
OpenAI taie la jumătate prețul API pentru GPT-6.1 Terra , poziționând modelul ca opțiune de automatizare „la volum” pentru sarcini de birou care combină înțelegere vizuală, utilizare de aplicații și redactare, potrivit OpenAI . GPT-6.1 Terra este prezentat ca un model „rapid și eficient”, cu raționament vizual detaliat și „computer use” (capacitatea de a opera aplicații și fluxuri pe calculator), plus scriere mai naturală. Miza practică, în descrierea companiei, este reducerea costului total pentru automatizarea muncii repetitive: de la citirea facturilor primite și introducerea datelor în software de contabilitate, până la completarea de formulare sau editare video. Ce se schimbă pentru costuri: prețuri API și consum în produse OpenAI afirmă că prețurile standard din API pentru GPT-6.1 Terra sunt cu 50% mai mici decât cele ale GPT-5.6 Terra și GPT-6.1 Sol, ceea ce ar face modelul mai potrivit pentru procese cu volum mare. În paralel, în ChatGPT Work și Codex, compania spune că „același plafon de utilizare” acoperă mai multe sarcini decât în GPT‑5.6 Terra și „substanțial mai multe” decât în GPT‑6.1 Sol sau GPT‑6 Astra. Prețurile standard în API, comunicate de OpenAI, sunt: 1 dolar (aprox. 4,6 lei) per milion de tokeni de intrare; 0,05 dolari (aprox. 0,23 lei) per milion de tokeni de intrare din cache (tokeni reutilizați dintr-o intrare anterioară, pentru cost mai mic); 5 dolari (aprox. 23 lei) per milion de tokeni de ieșire. Performanță operațională: viteză și eficiență pe sarcini „de agent” Pe benchmark-ul Agents’ Last Exam (sarcini profesionale, inclusiv transformarea unor planșe arhitecturale într-un model 3D și analiză cadru cu cadru pentru log cu marcaje de timp), OpenAI susține că: la efort mediu de raționament, GPT-6.1 Terra obține un scor cu 15 puncte procentuale peste GPT-5.6 Terra, la circa o treime din cost; rulează „la nivel” cu GPT-6 Astra la o zecime din prețul per token; la efort maxim, este de peste trei ori mai eficient la tokeni decât Claude Opus 5.5 și costă un sfert per token, ceea ce ar duce la un cost per sarcină de aproximativ 9 ori mai mic; finalizează sarcini de peste trei ori mai repede decât GPT-6 Astra și GPT-6.1 Sol. OpenAI mai indică rezultate mai bune față de GPT-5.6 Terra pe MMMU-Pro (raționament vizual) și pe OSWorld 2.1 (utilizarea aplicațiilor desktop pentru sarcini în mai mulți pași), cu accent pe raportul performanță/cost. Calitate: mai puține erori factuale și salt pe sarcini de programare Compania spune că a investit în reducerea „halucinațiilor” (răspunsuri inventate sau eronate). Pe un benchmark intern de prompturi care induc erori, rata de eroare: a scăzut de la 53,6% (GPT-5.6 Terra) la 16,7% (GPT-6.1 Terra) la efort redus de raționament; a coborât la 4,3% la efort maxim, cu o reducere de 18 puncte procentuale, „aproape” de nivelurile GPT-6 Astra și GPT-6.1 Sol. Pe Terminal-Bench 4.0 (sarcini de inginerie software din linia de comandă), la efort maxim, GPT‑6.1 Terra rezolvă 50,3% dintre sarcini, față de 21,5% pentru GPT‑5.6 Terra (scor publicat). Pentru cele mai complexe sarcini de programare, OpenAI precizează că GPT-6.1 Sol și GPT-6 Astra rămân opțiuni mai bune. Siguranță și disponibilitate OpenAI afirmă că GPT‑6.1 Terra atinge pragul „Critical” în securitate cibernetică în cadrul Preparedness Framework și păstrează protecțiile dezvoltate pentru GPT‑6 Astra. Compania mai susține că modelul este mai predispus să rămână „în scop” (să nu devieze de la cererea utilizatorului), să își recunoască limitările și să reziste la prompt-injection (instrucțiuni malițioase care încearcă să deturneze sarcina). Mai multe detalii sunt disponibile în „system card”-ul dedicat: https://deploymentsafety.openai.com/gpt-6-1-terra (link menționat în sursă). Începând „de astăzi”, GPT-6.1 Terra este disponibil pentru utilizatorii Plus, Pro, Enterprise și Edu în ChatGPT Work și Codex, iar pentru dezvoltatori prin API, sub identificatorul gpt-6.1-terra . [...]
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
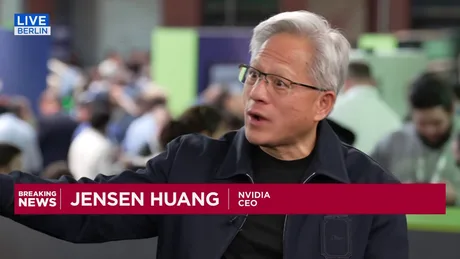
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
Mii de agenți AI pot comprima luni de analiză biologică în zeci de minute , arată un experiment descris de OpenAI , cu implicații directe pentru productivitatea cercetării și pentru felul în care sunt prioritizate experimentele în neuroștiințe și boli neurodegenerative. Într-o demonstrație realizată împreună cu PerturbAI și Scripps Research , echipa a folosit mii de agenți AI bazați pe GPT‑Rosalind pentru a interpreta date existente din milioane de celule din creierul de șoarece în 32 de minute. Miza operațională este reducerea blocajului dintre „datele produse” și „datele înțelese”: experimentele moderne pot modifica mii de gene și măsura efectele în milioane de celule, însă conectarea rezultatelor cu literatura științifică acumulată în decenii rămâne lentă și fragmentată. Abordarea propusă încearcă să scaleze tocmai această muncă de interpretare, nu doar procesarea brută. Cum funcționează „raționamentul biologic distribuit” Metoda împarte sarcina între mii de agenți AI, fiecare responsabil de o perturbare genetică. Agenții: investighează efectele unei perturbări asupra răspunsurilor celulare; caută și corelează rezultate relevante din literatura științifică; propun explicații și mecanisme biologice posibile. Rezultatele sunt agregate într-un „atlas de raționament” care leagă gene, efecte celulare, publicații relevante și ipoteze de mecanism. Analiza a folosit un „atlas CRISPR” la nivelul întregului creier (un set de date despre efectele perturbărilor genetice în diferite tipuri de celule din creierul de șoarece). De ce contează: randament mai mare la aceeași resursă și acoperire mai bună a literaturii Echipa estimează că o analiză umană comparabilă, făcută „câte o perturbare pe rând”, ar dura de la luni până la un an. În plus, testele interne au comparat un singur agent care primește întregul volum de lucru cu varianta distribuită, păstrând modelul și resursele fixe: pe măsură ce sarcina a crescut, agentul unic a acoperit tot mai puțin din literatură, ajungând să citeze 11 referințe la cel mai mare volum, în timp ce agenții distribuiți au citat peste 700 de referințe. În evaluări „în orb” (fără ca evaluatorii să știe ce variantă analizează), experții umani au preferat rapoartele generate de agenții distribuiți în 75% din cazuri. Potrivit descrierii, agenții au reprodus concluzii din analize umane și au identificat și piste suplimentare, iar evaluările lor privind noutatea și valoarea științifică au fost aliniate cu judecăți ale experților umani. Exemple de piste biologice identificate Materialul oferă câteva exemple de conexiuni pe care agenții le-au scos în evidență și care ar putea ghida experimente ulterioare: diferențe neașteptate între Tsc1 și Tsc2 (gene care controlează mTOR) în cerebel: perturbarea Tsc2 a modificat activitatea a zeci de gene implicate în comunicarea neuronală, în timp ce perturbarea Tsc1 a produs schimbări minime în aceeași zonă; o ipoteză legată de DCTN1 (genă asociată cu sindromul Perry, boală neurodegenerativă cu simptome asemănătoare Parkinson): perturbarea Dctn1 a crescut expresia genelor implicate în sinteza colesterolului, iar agenții au conectat observația cu cercetări care sugerează că problemele de transport al colesterolului pot determina celulele să producă mai mult colesterol. Ipoteza de testat: dacă perturbarea DCTN1 schimbă distribuția colesterolului în neuroni și dacă asta contribuie la neurodegenerare. Ce urmează: acces la rezultate și limitări implicite OpenAI notează că „atlasul de raționament” este disponibil public, astfel încât cercetătorii pot compara gene înrudite, investiga răspunsuri neașteptate și selecta piste promițătoare pentru experimente. În același timp, concluziile prezentate sunt formulate ca direcții de cercetare și ipoteze care necesită validare în laborator, nu ca rezultate clinice. [...]
OpenAI își extinde modelul de monetizare prin reclame, ducând ChatGPT Ads la 89 de țări și consolidând o sursă de venit menită să susțină accesul gratuit sau cu cost redus la serviciu, potrivit OpenAI . Compania spune că, la puțin peste opt luni de la lansare, peste 100.000 de agenți de publicitate au rulat campanii pe platformă, în condițiile în care ChatGPT este folosit săptămânal de peste 1,2 miliarde de persoane. Extinderea vizează 26 de țări noi și se bazează pe lansări recente în Europa și în Asia de Sud-Est și Taiwan. OpenAI precizează că reclamele vor fi afișate doar în planurile Free și Go, în timp ce abonamentele Plus, Pro și Enterprise rămân fără reclame. Unde se extinde și cum pot intra advertiserii După lansările din Mexic și Brazilia, OpenAI aduce ChatGPT Ads în încă 14 țări din America Latină, menționând explicit Argentina, Chile, Columbia și Peru. În paralel, compania intră și în piețe din Europa, Orientul Mijlociu, Africa și Asia, inclusiv Nigeria, Africa de Sud, Serbia, Ucraina, Cambodgia, Bangladesh și Pakistan. Accesul la ChatGPT Ads se face fie prin parteneri tehnologici, fie prin opțiunea de autoservire din Ads Manager . Ce promite OpenAI despre date și separarea reclamelor de răspunsuri OpenAI afirmă că abordarea sa este ghidată de „principiile pentru publicitate” și că păstrează conversațiile private față de agenții de publicitate, fără să vândă datele clienților. Reclamele sunt etichetate și separate de răspunsurile ChatGPT, iar publicitatea „nu influențează” răspunsurile oferite de model, conform principiilor detaliate de companie în materialul dedicat: ads principles . Ce urmează: formate noi și măsurare mai avansată Cu ChatGPT Ads disponibil în 89 de țări, următoarea etapă de creștere vizează dezvoltarea de formate suplimentare, obiective, opțiuni de cumpărare și capabilități de măsurare. OpenAI mai spune că explorează și modalități „mai native” prin care companiile să interacționeze cu consumatorii în ChatGPT. [...]
Elon Musk susține că SpaceX a subestimat piața-țintă pentru servicii de calcul AI , după ce compania a indicat în documentele depuse pentru IPO o piață totală adresabilă (TAM – dimensiunea teoretică maximă a pieței) de 28,5 trilioane de dolari (aprox. 128 trilioane lei), potrivit Wccftech . Mesajul, publicat pe X, nu include o cifră nouă, dar ridică miza pentru narațiunea economică din jurul repoziționării SpaceX ca furnizor de infrastructură de calcul pentru inteligență artificială, nu doar ca operator de lansări și internet prin satelit. Într-o postare scurtă, Musk a afirmat că estimarea din dosarul companiei a fost greșită și că valoarea reală este „mult mai mare”, fără să ofere detalii sau metodologie. Lipsa unei actualizări cuantificabile limitează însă utilitatea afirmației pentru investitori și pentru evaluarea realistă a oportunității, mai ales în contextul în care TAM-urile sunt, prin definiție, estimări sensibile la ipoteze. Ce a spus SpaceX în documentele S1 despre piața AI Conform articolului, SpaceX a menționat în depunerea S1 că 90% din piața totală adresabilă estimată de 26,5 trilioane de dolari ar proveni din AI. În interiorul acestei componente, compania a împărțit potențialul astfel: 22,7 trilioane de dolari din aplicații AI pentru companii (enterprise); 760 miliarde de dolari din abonamente pentru consumatori; 600 miliarde de dolari din publicitate digitală. Separat, Starlink ar reprezenta cea mai mare parte din restul, cu o piață de conectivitate estimată la 1,6 trilioane de dolari. De ce contează: repoziționarea SpaceX pe infrastructura de calcul AI Punctul economic central este că SpaceX își leagă tot mai explicit povestea de creștere de infrastructura pentru AI, unde investițiile sunt masive, iar competiția se poartă pe acces la energie, cipuri și capacitate de procesare. În acest cadru, o estimare de piață „mult mai mare” ar susține o teză de expansiune agresivă și ar justifica proiecte cu cheltuieli de capital ridicate, dar fără o cifră și fără ipoteze publice rămâne, deocamdată, un semnal de poziționare, nu o recalibrare verificabilă. Proiectele invocate: centre de date și „calcul în spațiu” Wccftech leagă afirmația lui Musk de ambițiile sale de a pune online sute de mii de procesoare grafice (GPU) pentru AI în cadrul proiectului de centru de date „Colossus”. Articolul menționează că „Colossus 2”, construit în Memphis , ar urma să aducă online până la finalul anului peste 660.000 de GPU-uri NVIDIA Blackwell și că instalația rulează deja pe 550.000 de GPU-uri Blackwell GB300 și GB200. În paralel, SpaceX ar avea planuri pentru proiectul „Starmind”, descris ca o inițiativă care ar folosi sateliți pentru a livra putere de calcul, după un model inspirat de constelația Starlink. Musk ar viza lansări „încă de la finalul lui 2027”, iar SpaceX ar colabora cu NVIDIA pentru adaptarea platformei „Vera Rubin” la infrastructura din spațiu. Context: cum arată estimările de piață în zona infrastructurii AI Articolul oferă și repere din industrie: CEO-ul AMD, Lisa Su, a vorbit recent la 2026 OCP Global Summit despre o piață totală adresabilă de 1,5 trilioane de dolari pentru acceleratoare AI în centre de date, iar NVIDIA a indicat în apeluri cu investitorii un „backlog” (comenzi/cerere în așteptare) de 2 trilioane de dolari din partea marilor operatori de cloud (hyperscaleri). Pentru SpaceX, diferența este că își ancorează o parte din evaluarea potențială în ipoteza unei piețe AI de ordinul zecilor de trilioane de dolari — iar acum Musk sugerează că și această ancoră ar fi conservatoare, fără să explice de ce. [...]