Știri

Știri din categoria Inteligență artificială

Noua suită Gemini Intelligence va rula, cel puțin la început, doar pe o mână de telefoane Android „premium”, ceea ce ridică pragul hardware și de suport software pentru producători și poate fragmenta accesul la funcțiile avansate de inteligență artificială pe Android, potrivit GSMArena.
Gemini Intelligence nu este prezentată doar ca o redenumire, ci ca un pachet de funcții capabile să automatizeze sarcini în mai mulți pași și să le execute în fundal, inclusiv prin interacțiuni autonome cu aplicații și site-uri. Materialul menționează și un component numit „Rambler”, care ar urma să ajungă în Gboard și să permită o conversație mai liberă, inclusiv cu „cuvinte de umplutură” și amestec de limbi în aceeași propoziție.
Din informațiile disponibile în acest moment, funcțiile ar urma să debuteze pe viitoarele Samsung Galaxy Z Fold8 și Z Flip8, iar Google a confirmat că seria Galaxy S26 și seria Pixel 10 vor primi Gemini Intelligence „în această vară”, notează publicația.
O notă de subsol de pe site-ul oficial Android descrie Gemini Intelligence ca pe o funcție „premium” și exclusivistă, cel puțin pentru moment. Printre cerințele enumerate se află:
Pe lângă acestea, apar și condiții suplimentare, inclusiv cerințe legate de platforma hardware („SoC eligibil”, adică un cip de top), teste de calitate și stabilitate (inclusiv rate mici de blocări), dar și obligații de mentenanță pe termen lung: 5 upgrade-uri de sistem de operare și șase ani de actualizări de securitate trimestriale. Sunt menționate și suportul pentru Android Virtualization Framework (AVF) și pKVM (o mașină virtuală protejată la nivel de kernel), plus o cerință vag formulată privind „performanța media” și zona de gaming.
Setul de condiții sugerează că Google împinge Gemini Intelligence spre segmentul de vârf, atât prin resursele necesare pentru rulare locală (pe telefon), cât și prin cerințe de suport software pe termen lung. Consecința practică este că funcțiile pot ajunge mai greu pe modele mai accesibile, chiar și în cadrul aceleiași familii de produse.
În acest context, GSMArena remarcă faptul că un leak de specificații pentru familia Pixel 11 ar indica posibilitatea ca modelele non-Pro să vină cu doar 8 GB RAM, ceea ce ar pune sub semnul întrebării compatibilitatea lor cu Gemini Intelligence. Publicația subliniază că, deocamdată, nu există un răspuns ferm.
Recomandate
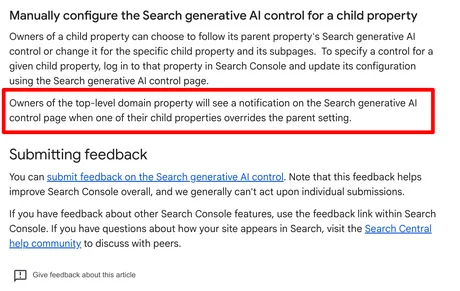
Google a adăugat un mecanism de notificare pentru proprietarii de domenii de nivel superior (TLD) în pagina de control a funcțiilor de AI generativ din Search Console , astfel încât aceștia să vadă când o proprietate „copil” (de tip subdomeniu sau altă proprietate asociată) suprascrie setarea stabilită la nivel de „părinte”, potrivit Search Engine Roundtable . Schimbarea vizează pagina „Search generative AI control” din Google Search Console și este legată de modul în care se aplică setările de control pentru funcțiile de inteligență artificială generativă în Căutare, în special în conturile unde există ierarhii de proprietăți (de exemplu, domeniu principal și proprietăți derivate). Ce s-a schimbat, concret, în Search Console Google a actualizat documentația „deep dive” (ghid detaliat) pentru această funcționalitate și a introdus o precizare operațională: proprietarii unei proprietăți de tip domeniu de nivel superior vor primi o notificare în pagina de control atunci când una dintre proprietățile copil suprascrie setarea părintelui. Formularea adăugată de Google, redată în articol, este: Proprietarii proprietății de domeniu de nivel superior vor vedea o notificare pe pagina de control a AI generativ din Căutare atunci când una dintre proprietățile copil suprascrie setarea părintelui. De ce contează pentru administrarea site-urilor Din perspectivă operațională, actualizarea reduce riscul ca setările de control pentru AI generativ să fie aplicate neuniform fără ca administratorii domeniului să observe. În practică, pentru organizațiile care gestionează mai multe proprietăți sub același domeniu (branduri, piețe, subdomenii, versiuni regionale), vizibilitatea asupra „excepțiilor” făcute la nivel de proprietate copil devine mai ușor de urmărit direct în interfața Search Console. Google reamintește, totodată, că aceste controale sunt „acum disponibile la nivel global”, conform articolului. [...]
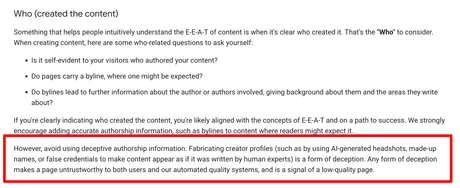
Google își înăsprește criteriile de calitate și avertizează că profilurile de autor fabricate pot trage în jos credibilitatea unei pagini , potrivit Search Engine Roundtable . Mesajul apare odată cu actualizări în documentația Google despre „conținut util ” și vizează explicit „informațiile înșelătoare despre autor” din pagini. Avertismentul, introdus într-un nou paragraf din documentația Google, spune că fabricarea profilurilor de creator — inclusiv folosirea de fotografii de tip portret generate cu inteligență artificială, nume inventate sau acreditări false pentru a face conținutul să pară scris de experți umani — este „o formă de înșelăciune”. Google susține că orice formă de înșelăciune face pagina „nedemnă de încredere” atât pentru utilizatori, cât și pentru „sistemele automate de evaluare a calității”, și reprezintă un semnal de „pagină de calitate scăzută”. Ce înseamnă, practic, pentru publisheri și echipele de conținut Google formulează o listă de interdicții, cu accent pe prezentarea autorului: să nu fie folosite informații înșelătoare despre autor; să nu fie falsificate profiluri de creator; să nu fie folosite fotografii de tip headshot generate cu AI; să nu fie inventate nume de autori; să nu fie falsificate acreditări ale autorilor. Din perspectiva operațională, avertismentul ridică miza pentru site-urile care folosesc conținut produs la scară mare și încearcă să-l „îmbrace” în semnale de expertiză prin identități artificiale. Google leagă direct aceste practici de evaluarea automată a calității, ceea ce poate influența vizibilitatea în căutare. Context: schimbare de poziționare față de mesajele anterioare Publicația notează că Google comunicase anterior că nu este îngrijorat de falsificarea informațiilor despre autori, dar „se pare că vremurile s-au schimbat”. În noua formulare, compania tratează explicit astfel de practici ca înșelătoare și ca indicator de calitate scăzută. Pentru companii, implicația imediată este nevoia de audit al paginilor și al paginilor de autor: dacă identitatea autorilor, fotografiile sau acreditările nu pot fi susținute, riscul este ca paginile să fie considerate mai puțin de încredere de către utilizatori și de sistemele automate ale Google. [...]
Google își accelerează filtrele anti-spam și folosește AI pentru a prinde „spam făcut cu AI”, pe fondul unei creșteri masive a volumului de conținut online , potrivit Search Engine Roundtable . Mesajul, transmis la un eveniment Google Search Central Live Deep Dive din Europa, indică un impact operațional direct pentru publisheri și companii: volatilitate mai mare în trafic și nevoia de controale mai stricte asupra calității, mai ales când conținutul este produs „la scară”. Informațiile provin dintr-un rezumat semnat de John Campbell, publicat de We Are Roast, despre motivele pentru care Google a lansat „atât de multe” actualizări anti-spam în 2026. Explicația centrală: există „mult mai mult conținut nou decât înainte”, iar o „proporție ridicată” din acest conținut este spam, ceea ce împinge Google să ajusteze mai des filtrele. Ce se schimbă operațional: AI contra spamului și praguri noi În prezentarea citată, Google ar fi spus că echipa folosește inteligența artificială pentru a identifica mai mult spam. În același timp, „AI slop” (conținut de slabă calitate generat în masă cu ajutorul AI) este în creștere și ar afecta inclusiv calitatea conținutului din feed-ul Discover. Un alt element important pentru modul în care vor evolua filtrele: feedback-ul utilizatorilor este descris ca „foarte important”, fiind baza pe care se construiesc noile filtre anti-spam. Un reper de volum: 40 de miliarde de pagini spam filtrate zilnic Gary Illyes a menționat un ordin de mărime al efortului de filtrare: Google ar filtra 40 de miliarde de pagini spam pe zi . Publicația notează însă că această cifră nu este nouă, fiind menționată și în trecut în documentația Google. De ce vor continua actualizările: formate mai multe, pagini mai multe, spam mai mult În rezumatul citat sunt enumerate trei motive pentru care Google „tot actualizează” modul în care judecă calitatea: S-au extins formatele de conținut : căutarea nu mai înseamnă doar „zece linkuri albastre”, iar fiecare format ar necesita criterii proprii de evaluare. A crescut „lățimea” conținutului : sunt mult mai multe pagini și site-uri; iar actualizările de tip „core” ar viza conținutul la nivel de pagină, nu domeniul, ceea ce explică de ce unele pagini cresc și altele scad pe același site. Probleme de conținut (spam) : actualizările îmbunătățesc detectarea unor practici precum cloaking, doorway pages, conținut copiat, spam de linkuri, conținut compromis (hacked). În plus, este menționat un avertisment că „scaled content” (conținut produs la scară, cu efort redus) devine o problemă mai mare decât spamul de linkuri. La ce să se aștepte site-urile: mai multe „spam updates” și risc crescut pentru conținutul „la scară” Concluzia rezumatului este directă: „așteptați-vă la mai multe actualizări anti-spam”, pe măsură ce Google gestionează „un val în creștere” de conținut de slabă calitate generat cu AI. Sunt menționate și „noi praguri” anti-spam, iar riscul principal este asociat conținutului „scaled, low-effort” — produs în volum mare, cu valoare redusă pentru utilizator. [...]
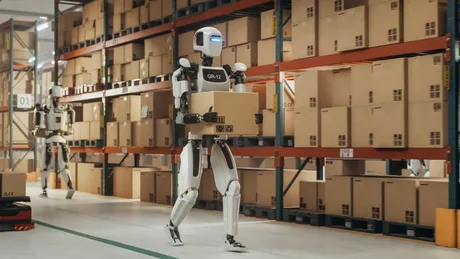
Salling Group testează roboți umanoizi pentru aprovizionarea rafturilor, cu ținta de autonomie din 2027 , într-un proiect care poate schimba modul în care retailerii își organizează munca de noapte și alocarea personalului în magazine, potrivit Antena 3 . Într-un supermarket Føtex de lângă Copenhaga, roboții sunt antrenați să preia una dintre cele mai consumatoare de timp activități din comerț: completarea rafturilor. Scopul declarat este ca angajații să petreacă mai mult timp cu clienții, în timp ce roboții ar urma să lucreze în principal noaptea, când magazinul este închis. Ce presupune testul și cine sunt actorii Roboții sunt dezvoltați de start-up-ul danez Hive Robots și sunt fabricați de compania chineză Unitree . Potrivit informațiilor din material, antrenarea lor a început în iunie, iar în această etapă fiecare mișcare este ghidată de operatori umani, care „învață” sistemul de inteligență artificială să manevreze produse diferite. Experimentul este parte dintr-un program-pilot mai amplu derulat împreună cu Salling Group, descris ca cel mai mare retailer din Danemarca, cu peste 2.000 de magazine în șase țări europene. De ce contează operațional: timpul angajaților și munca repetitivă Føtex estimează că angajații își petrec între 40% și 50% din timp completând rafturile. Retailerul mizează pe faptul că, pe termen mediu, roboții ar putea prelua o parte din munca fizică repetitivă, iar personalul uman să fie redirecționat către activități cu valoare mai mare în relația cu clienții. Pe lista de utilizări potențiale, pe viitor, sunt menționate și sarcini precum verificarea termenelor de valabilitate, identificarea rafturilor goale și a produselor puse greșit. În prezent însă, roboții lucrează mai încet decât oamenii și au nevoie de supraveghere atentă. Ținta: autonomie la începutul lui 2027, dar cu un obstacol de reglementare Obiectivul proiectului este ca, până la începutul lui 2027, roboții să poată aproviziona singuri rafturile, în special pe timpul nopții. Totuși, materialul notează că legislația daneză ar trebui modificată înainte ca roboții să poată funcționa autonom printre cumpărători. Până la eventuale schimbări de reglementare, accentul rămâne pe munca de noapte și pe sarcini care nu presupun contact direct cu clienții. [...]
Șeful Qualcomm estimează că telefoanele ar putea rula local modele LLM de 100 de miliarde de parametri până în 2028, dar pragul de memorie necesar riscă să facă scenariul neeconomic în actualele condiții de ofertă și preț pentru DRAM, potrivit Wccftech . Cristiano Amon , CEO-ul Qualcomm, a spus într-o discuție cu Fireside Alpha că unele companii de inteligență artificială își doresc smartphone-uri capabile să ruleze „continuu” astfel de modele și că „se construiesc” dispozitive în această direcție, fără a oferi nume sau o foaie de parcurs tehnică. Miza este una de cost și fezabilitate: pe telefoane, principalul blocaj pentru modele mai dense este memoria, iar piața se află deja sub presiune din cauza unei „crize” a memoriei, notează publicația (context: roundup Wccftech despre situația DRAM ). De ce memoria (DRAM) devine problema economică centrală Wccftech argumentează că, dincolo de ambiția de produs, cerințele brute de memorie împing smartphone-ul într-o zonă dificil de susținut comercial: un model de 100 de miliarde de parametri cuantizat la 4 biți ar avea nevoie de cel puțin 50 GB RAM , plus memorie suplimentară pentru sistemul de operare, aplicații și „context cache” (memorie folosită pentru a păstra contextul conversației); chiar și la 2 biți, ar fi necesari circa 25 GB RAM doar pentru model, ceea ce rămâne greu de integrat în telefoane la scară mare. În acest context, publicația amintește că mai mulți producători au făcut un pas înapoi de la variantele cu RAM mai mare, deși cu un an înainte existau modele Android cu 24 GB LPDDR5X . Ce opțiuni tehnice ar putea reduce presiunea pe DRAM Materialul trece în revistă câteva direcții care ar putea face posibilă rularea unor modele foarte mari pe mobil, însă fiecare vine cu compromisuri: rulare prin „streaming” din memoria flash (stocarea internă), nu integral din DRAM; problema este că UFS/NVMe sunt mai lente decât DRAM, ceea ce poate reduce viteza de inferență (generarea răspunsurilor); modele MoE (Mixture of Experts) cu „offloading” al unor componente pe flash: doar o parte din „experți” sunt activi și ținuți în RAM pentru fiecare token, restul stau pe stocare; cuantizare agresivă (inclusiv spre 1 bit), care reduce necesarul de memorie, dar Wccftech notează că scade semnificativ calitatea sub 4 biți, mai ales la sarcini de raționament; modele distilate de 20–30 de miliarde de parametri , care ar putea ajunge aproape de calitatea unui 100B pe smartphone și par, în evaluarea publicației, o strategie mai „vandabilă” și realistă. Separat, articolul menționează că Apple și Qualcomm au încercat să atenueze parțial constrângerile prin schimbări de „împachetare” (packaging) a cipurilor, făcând trimitere la A20 Pro și Snapdragon 8 Elite Extreme Gen 6 , însă „gâtul de sticlă” al memoriei rămâne. Costul ascuns: căldură și limitări termice Chiar dacă problema DRAM ar fi rezolvată, Wccftech subliniază un al doilea obstacol: rularea continuă a modelelor dense crește puternic consumul și temperatura, ceea ce poate duce la limitare termică (thermal throttling) — reducerea automată a performanței pentru a controla încălzirea. În lipsa unor detalii despre cum ar fi depășite aceste constrângeri (memorie, cost, termică), afirmația CEO-ului Qualcomm rămâne, în lectura publicației, mai degrabă o proiecție ambițioasă decât un plan verificabil pentru piața de masă până în 2028. (Postarea citată: Fireside Alpha pe X .) [...]
Satya Nadella cere ca modelele de inteligență artificială să fie tratate din start ca „potențial compromise” , o schimbare de abordare care împinge companiile spre controale operaționale mai stricte și standardizate pentru utilizarea AI în produse și procese, potrivit The Verge . Într-o postare amplă pe X, CEO-ul Microsoft descrie riscurile asociate modelelor AI foarte avansate și susține că nu mai este acceptabil un model de funcționare în care AI este tratată ca un „set de cutii negre” (sisteme opace) ale căror recomandări sunt doar acceptate sau respinse. În loc, Nadella propune un sistem mai transparent, în care modelele pot fi „conținute” și observate, iar activitatea lor lasă „dovezi lizibile de oameni” care să fie rezistente la manipulare. „Frâna de urgență” ca cerință operațională Elementul care iese în evidență în poziția lui Nadella este ideea de control activ și imediat asupra unui model, plecând de la prezumția că acesta este deja compromis și trebuie izolat încă de la început. „Trebuie să presupunem că un model este compromis și să îl izolăm de la început. Gândiți-vă la asta ca la o frână de urgență. O persoană autorizată ar trebui să poată întotdeauna să pună pe pauză sau să oprească un model în mijlocul unei sarcini. Modelele mai avansate vor necesita tehnologii de izolare mai avansate, pe care trebuie să le standardizăm.” În termeni practici, mesajul indică o direcție în care implementările AI ar trebui proiectate cu mecanisme explicite de oprire/pauză, supraveghere și limitare a acțiunilor în timp real, nu doar cu politici sau verificări ulterioare. Măsuri propuse: de la raportarea incidentelor la audituri independente Pe lângă „izolare”, Nadella enumeră recomandări care se suprapun cu discuțiile mai largi din industrie privind guvernanța AI, inclusiv: raportarea la timp a incidentelor; audituri independente; date verificabile; mecanisme de izolare („containment”). Publicația notează și că Nadella folosește în mod repetat termenul „super inteligență” pentru a descrie AI în postare, fără a detalia în textul citat o definiție tehnică a conceptului. Ce nu reiese din material este dacă Microsoft intenționează să introducă imediat astfel de cerințe ca standard intern pentru produsele sale sau dacă este, deocamdată, o poziționare de principiu. [...]