Știri

Știri din categoria Inteligență artificială

Google își limitează „Gemini Intelligence” la Pixel și Samsung la lansare, o decizie care poate încetini adoptarea noilor funcții de inteligență artificială pe Android și care pune presiune pe credibilitatea promisiunilor, într-un moment ales cu mai puțin de o lună înainte de WWDC, unde Apple urmează să detalieze ce mai face cu Apple Intelligence, potrivit AppleInsider.
Google a prezentat suita „Gemini Intelligence” pe 12 mai 2026, într-un eveniment transmis online, cu lansare etapizată „în această vară”. Momentul vine înainte de WWDC 2026 (8 iunie), când Apple este așteptată să anunțe următorii pași pentru Apple Intelligence și, în special, pentru o versiune mai „personală” a lui Siri, promisă inițial pentru iOS 18, dar încă nelansată.
În material, „Gemini Intelligence” este descrisă ca un pachet de cinci funcții distincte, prezentate în demonstrații pe telefoane Pixel, cu accent pe utilizare „personală” și automatizări. Exemplele menționate includ:
Un punct operațional important este disponibilitatea inițială. Google, spre deosebire de Apple, nu controlează un singur model de telefon, ci trebuie să țină cont de „zeci” de dispozitive și formate. Consecința, potrivit articolului, este că la lansare funcțiile vor fi limitate la cele mai noi dispozitive Pixel și Samsung Galaxy, iar pentru alte branduri (exemplul dat: Motorola) „nu există garanții”.
Google mai spune că, după debutul pe telefoane, funcțiile ar urma să ajungă și pe ceasuri, mașini, laptopuri și chiar ochelari, însă fără detalii clare despre ce funcții, pe ce dispozitive și în ce ordine.
AppleInsider pune anunțul Google în contextul unui istoric de funcții „personale” sau proactive care au fost retrase ori transformate: Google Now (lansat în 2012, închis după câțiva ani și înlocuit), Google Duplex (prezentat în 2018, cu probleme de fiabilitate și îngrijorări legale și de confidențialitate; varianta web a fost oprită în 2022, iar tehnologia a fost integrată ulterior în alte funcții Gemini). În același timp, sunt menționate și exemple care au rămas în piață, precum „Hold for Me” și „Call Screen” pe Pixel.
În paralel, Apple se confruntă cu propriul deficit de încredere: funcțiile personalizate Apple Intelligence anunțate la WWDC 2024 nu au ajuns încă la utilizatori, iar întârzierea unor capabilități Siri a dus inclusiv la procese și la o înțelegere într-un proces colectiv.
Pe 8 iunie, Apple va prezenta noul software pentru iPhone la WWDC 2026, iar așteptările includ o Siri mai „personală”, capabilă să lucreze „cu și între aplicații”, înțelegând contextul și ce este pe ecran — o direcție apropiată de automatizările între aplicații pe care Google le-a pus în prim-plan la „Gemini Intelligence”.
Miza imediată pentru ambele companii, în lectura AppleInsider, este aceeași: dacă aceste funcții vor trece dincolo de demonstrații și vor deveni instrumente folosite constant, nu doar noutăți pe care utilizatorii le testează o dată și apoi le uită.
Recomandate
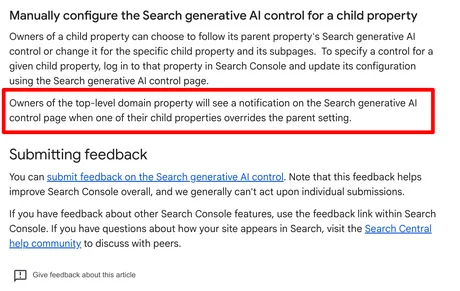
Google a adăugat un mecanism de notificare pentru proprietarii de domenii de nivel superior (TLD) în pagina de control a funcțiilor de AI generativ din Search Console , astfel încât aceștia să vadă când o proprietate „copil” (de tip subdomeniu sau altă proprietate asociată) suprascrie setarea stabilită la nivel de „părinte”, potrivit Search Engine Roundtable . Schimbarea vizează pagina „Search generative AI control” din Google Search Console și este legată de modul în care se aplică setările de control pentru funcțiile de inteligență artificială generativă în Căutare, în special în conturile unde există ierarhii de proprietăți (de exemplu, domeniu principal și proprietăți derivate). Ce s-a schimbat, concret, în Search Console Google a actualizat documentația „deep dive” (ghid detaliat) pentru această funcționalitate și a introdus o precizare operațională: proprietarii unei proprietăți de tip domeniu de nivel superior vor primi o notificare în pagina de control atunci când una dintre proprietățile copil suprascrie setarea părintelui. Formularea adăugată de Google, redată în articol, este: Proprietarii proprietății de domeniu de nivel superior vor vedea o notificare pe pagina de control a AI generativ din Căutare atunci când una dintre proprietățile copil suprascrie setarea părintelui. De ce contează pentru administrarea site-urilor Din perspectivă operațională, actualizarea reduce riscul ca setările de control pentru AI generativ să fie aplicate neuniform fără ca administratorii domeniului să observe. În practică, pentru organizațiile care gestionează mai multe proprietăți sub același domeniu (branduri, piețe, subdomenii, versiuni regionale), vizibilitatea asupra „excepțiilor” făcute la nivel de proprietate copil devine mai ușor de urmărit direct în interfața Search Console. Google reamintește, totodată, că aceste controale sunt „acum disponibile la nivel global”, conform articolului. [...]
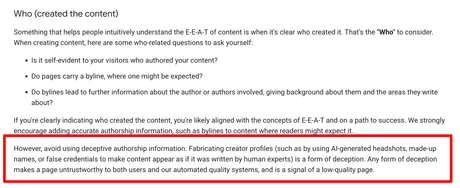
Google își înăsprește criteriile de calitate și avertizează că profilurile de autor fabricate pot trage în jos credibilitatea unei pagini , potrivit Search Engine Roundtable . Mesajul apare odată cu actualizări în documentația Google despre „conținut util ” și vizează explicit „informațiile înșelătoare despre autor” din pagini. Avertismentul, introdus într-un nou paragraf din documentația Google, spune că fabricarea profilurilor de creator — inclusiv folosirea de fotografii de tip portret generate cu inteligență artificială, nume inventate sau acreditări false pentru a face conținutul să pară scris de experți umani — este „o formă de înșelăciune”. Google susține că orice formă de înșelăciune face pagina „nedemnă de încredere” atât pentru utilizatori, cât și pentru „sistemele automate de evaluare a calității”, și reprezintă un semnal de „pagină de calitate scăzută”. Ce înseamnă, practic, pentru publisheri și echipele de conținut Google formulează o listă de interdicții, cu accent pe prezentarea autorului: să nu fie folosite informații înșelătoare despre autor; să nu fie falsificate profiluri de creator; să nu fie folosite fotografii de tip headshot generate cu AI; să nu fie inventate nume de autori; să nu fie falsificate acreditări ale autorilor. Din perspectiva operațională, avertismentul ridică miza pentru site-urile care folosesc conținut produs la scară mare și încearcă să-l „îmbrace” în semnale de expertiză prin identități artificiale. Google leagă direct aceste practici de evaluarea automată a calității, ceea ce poate influența vizibilitatea în căutare. Context: schimbare de poziționare față de mesajele anterioare Publicația notează că Google comunicase anterior că nu este îngrijorat de falsificarea informațiilor despre autori, dar „se pare că vremurile s-au schimbat”. În noua formulare, compania tratează explicit astfel de practici ca înșelătoare și ca indicator de calitate scăzută. Pentru companii, implicația imediată este nevoia de audit al paginilor și al paginilor de autor: dacă identitatea autorilor, fotografiile sau acreditările nu pot fi susținute, riscul este ca paginile să fie considerate mai puțin de încredere de către utilizatori și de sistemele automate ale Google. [...]
Google își accelerează filtrele anti-spam și folosește AI pentru a prinde „spam făcut cu AI”, pe fondul unei creșteri masive a volumului de conținut online , potrivit Search Engine Roundtable . Mesajul, transmis la un eveniment Google Search Central Live Deep Dive din Europa, indică un impact operațional direct pentru publisheri și companii: volatilitate mai mare în trafic și nevoia de controale mai stricte asupra calității, mai ales când conținutul este produs „la scară”. Informațiile provin dintr-un rezumat semnat de John Campbell, publicat de We Are Roast, despre motivele pentru care Google a lansat „atât de multe” actualizări anti-spam în 2026. Explicația centrală: există „mult mai mult conținut nou decât înainte”, iar o „proporție ridicată” din acest conținut este spam, ceea ce împinge Google să ajusteze mai des filtrele. Ce se schimbă operațional: AI contra spamului și praguri noi În prezentarea citată, Google ar fi spus că echipa folosește inteligența artificială pentru a identifica mai mult spam. În același timp, „AI slop” (conținut de slabă calitate generat în masă cu ajutorul AI) este în creștere și ar afecta inclusiv calitatea conținutului din feed-ul Discover. Un alt element important pentru modul în care vor evolua filtrele: feedback-ul utilizatorilor este descris ca „foarte important”, fiind baza pe care se construiesc noile filtre anti-spam. Un reper de volum: 40 de miliarde de pagini spam filtrate zilnic Gary Illyes a menționat un ordin de mărime al efortului de filtrare: Google ar filtra 40 de miliarde de pagini spam pe zi . Publicația notează însă că această cifră nu este nouă, fiind menționată și în trecut în documentația Google. De ce vor continua actualizările: formate mai multe, pagini mai multe, spam mai mult În rezumatul citat sunt enumerate trei motive pentru care Google „tot actualizează” modul în care judecă calitatea: S-au extins formatele de conținut : căutarea nu mai înseamnă doar „zece linkuri albastre”, iar fiecare format ar necesita criterii proprii de evaluare. A crescut „lățimea” conținutului : sunt mult mai multe pagini și site-uri; iar actualizările de tip „core” ar viza conținutul la nivel de pagină, nu domeniul, ceea ce explică de ce unele pagini cresc și altele scad pe același site. Probleme de conținut (spam) : actualizările îmbunătățesc detectarea unor practici precum cloaking, doorway pages, conținut copiat, spam de linkuri, conținut compromis (hacked). În plus, este menționat un avertisment că „scaled content” (conținut produs la scară, cu efort redus) devine o problemă mai mare decât spamul de linkuri. La ce să se aștepte site-urile: mai multe „spam updates” și risc crescut pentru conținutul „la scară” Concluzia rezumatului este directă: „așteptați-vă la mai multe actualizări anti-spam”, pe măsură ce Google gestionează „un val în creștere” de conținut de slabă calitate generat cu AI. Sunt menționate și „noi praguri” anti-spam, iar riscul principal este asociat conținutului „scaled, low-effort” — produs în volum mare, cu valoare redusă pentru utilizator. [...]
Google își înăsprește regulile de clasare, vizând direct site-urile care folosesc autori inventați și fotografii generate de AI , o practică asociată cu „fabricarea” credibilității pentru a împinge conținut de slabă calitate în Search și Google News , potrivit Futurism . Schimbarea vine după o investigație a publicației despre Brown Brothers Media , o companie care ar fi atras zeci de milioane de vizualizări lunar cumpărând site-uri de știri în dificultate și transformându-le în „mori” de conținut alimentate de inteligență artificială. Modelul descris: inventarea de jurnaliști și „experți”, cu istorii personale și acreditări false, folosiți ca semnături pentru mii de articole optimizate pentru motoare de căutare (SEO). Materialele erau adesea plagiate, bazate pe experiențe inventate sau atât de neglijente încât nu ofereau valoare cititorilor, susține Futurism. Ce a schimbat Google în ghiduri și de ce contează Google a actualizat ghidurile pentru „conținut util, de încredere, orientat către oameni” și a introdus explicit interdicția de a folosi informații înșelătoare despre autor. Înainte, documentația încuraja includerea de informații corecte despre autor (byline), ca semnal de aliniere la E-E-A-T (experiență, expertiză, autoritate și încredere). Acum, compania adaugă un paragraf nou, cu formulare mai dură, care califică drept „înșelăciune” fabricarea profilurilor de creatori. „Totuși, evitați folosirea informațiilor înșelătoare despre autor. Fabricarea profilurilor creatorilor (de exemplu, folosind fotografii generate de AI, nume inventate sau acreditări false pentru a face conținutul să pară ca și cum ar fi fost scris de experți umani) este o formă de înșelăciune. Orice formă de înșelăciune face o pagină nedemnă de încredere atât pentru utilizatori, cât și pentru sistemele noastre automate de calitate și este un semnal al unei pagini de calitate scăzută.” Implicația operațională este directă: site-urile care se bazează pe astfel de artificii riscă să nu mai fie „prioritizate” de Google, adică să piardă vizibilitate în rezultate și, implicit, trafic. Context: presiune pe „fabricile” de conținut, dar efect incert pentru presă Futurism notează că, potrivit datelor pe care le-a analizat, o parte importantă din audiența operațiunii descrise ar fi venit din Google. După publicarea investigației, Google ar fi acționat pentru a reduce prezența site-urilor Brown Brothers pe platforme precum Search și Google News, iar ulterior compania ar fi oprit brusc publicarea. Actualizarea ghidurilor apare și pe fondul altor cazuri similare: în Canada, o publicație a fost pusă în dificultate după ce „reporterii” inexistenți au început să afișeze mesaje de eroare, iar un alt caz a implicat plagiat sub numele unui jurnalist indigen inventat. Scheme asemănătoare au fost documentate și în Florida și Rhode Island. Totuși, aceeași sursă avertizează că nu este sigur că această „crackdown” pe semnături false va ajuta semnificativ ecosistemul media, în condițiile în care Google folosește tot mai mult inteligența artificială și promovează rezumate generate automat, care pot reduce traficul către reportajele originale. [...]
Grok Bot primește o adresă de e-mail proprie, ceea ce îi extinde rolul de „agent” capabil să interacționeze autonom cu servicii online , inclusiv pentru înscrieri, contactarea companiilor sau programări, potrivit 9to5Mac . Funcționalitatea este „în curs de lansare” către utilizatori și, conform anunțului citat de publicație, adresa poate fi folosită de bot pentru a se înregistra pe diverse servicii, pentru a contacta firme în numele utilizatorului sau pentru a stabili întâlniri. Cum îți revendici adresa și ce format are Procesul pornește din interfața de chat: dacă îi ceri botului ceva de tipul „claim your email address”, acesta inițiază pașii necesari. Alternativ, utilizatorii pot „tag-ui” contul pe X, conform aceluiași anunț. Utilizatorul poate solicita o adresă personalizată, iar Grok Bot verifică disponibilitatea. Adresele se termină în .grokbot.com și, potrivit sursei, vor fi folosite de „sistemul de agenți” (agent system) al Grok Bot. Context: cursa pentru agenți AI Actualizarea vine după un alt upgrade din această săptămână, când Grok Bot a primit o îmbunătățire de „inteligență” cu ajutorul modelului Claude al Anthropic , notează publicația (detalii în materialul asociat: 9to5Mac ). În paralel, 9to5Mac plasează mișcarea în contextul competiției din zona „agenților” AI: Meta își împinge agentul Muse, iar OpenAI dezvoltă ChatGPT Dot. Grok Bot este disponibil pe iPhone, iPad și Mac, iar pagina indicată pentru acces este x.ai . [...]
OpenAI spune că a blocat operațiuni de propagandă care foloseau ChatGPT și identități false de „jurnaliști” , un semnal de risc operațional pentru redacții și platforme online care pot prelua, fără verificări solide, conținut generat cu ajutorul inteligenței artificiale, potrivit Euronews . Compania afirmă că rețele legate de Iran și Rusia au utilizat modele ChatGPT pentru a crea articole, comentarii și entități-paravan, cu scopul de a răspândi narațiuni false despre conflictele din Ucraina și Orientul Mijlociu și de a „semăna diviziune” în SUA și Israel. OpenAI susține că a oprit două operațiuni distincte, una asociată Iranului și alta Rusiei. În ambele cazuri, conturile ar fi fost folosite pentru generarea de conținut și pentru construirea unor identități credibile, inclusiv pentru susținerea unor structuri de tip think-tank (grup de reflecție), utilizate ca vehicule de influențare. Cum ar fi funcționat operațiunea atribuită Iranului În cazul Iranului, OpenAI indică existența a șapte profiluri false de jurnaliști, care pretindeau că provin din țări occidentale, inclusiv din SUA. Aceste identități ar fi fost folosite pentru a plasa articole „de amploare” în publicații online din mai multe țări. OpenAI afirmă că a identificat aproape 100 de articole publicate sau preluate sub semnătura acestei operațiuni, în aproximativ 12 publicații online „mici și medii”, orientate spre afaceri internaționale, geopolitică și Orientul Mijlociu. Cel mai vechi material identificat ar fi fost publicat în iulie 2025, iar cel mai recent în octombrie 2026, cu o creștere a frecvenței după izbucnirea războiului dintre SUA și Iran, potrivit companiei. Un exemplu de identitate fictivă menționat este „Ervin B. Hoskins”, prezentat drept „scriitor american independent”, cu conturi pe mai multe platforme, inclusiv X și Instagram. OpenAI susține că datele de transparență ale platformelor indicau conexiuni tehnice și de localizare către Iran și că a publicat dovezi în acest sens. Operațiunea atribuită Rusiei: think-tank și recrutări în America Latină Pentru Rusia, OpenAI afirmă că operațiunea ar fi cooptat „persoane neștiutoare” din America Latină pentru a conduce un think-tank numit Centrul de Cercetări Sociale (SRC). Structura ar fi fost folosită pentru activități menite să submineze reputația Ucrainei în regiune și să influențeze politica locală. În comunicatul citat de Euronews, OpenAI susține că angajații SRC nu ar fi știut că lucrează pentru o grupare rusească și descrie cazul drept „cea mai complexă încercare de a opera o identitate-paravan” pe care compania ar fi dejucat-o în ultimii doi ani și jumătate. Potrivit OpenAI, operatorii au folosit ChatGPT pentru: redactarea de rapoarte interne despre activități; crearea de conținut pentru operațiuni; elaborarea de rapoarte de performanță ale think-tank-ului; conceperea de texte pentru postări și comentarii pe rețele sociale. Printre temele abordate pe rețelele sociale s-ar fi numărat și reacții la o propunere atribuită europarlamentarului polonez de extremă dreapta Grzegorz Braun, prezentată ca încercare de a alimenta diviziuni în Polonia privind sprijinul pentru Ucraina. De ce contează pentru redacții și platforme Cazul descris de OpenAI indică o presiune în creștere asupra mecanismelor de verificare editorială și a moderării pe platforme: conținutul generat cu ajutorul IA poate fi ambalat în „semnături” și profiluri aparent credibile și apoi redistribuit prin publicații care preiau materiale externe. În lipsa unor detalii suplimentare despre publicațiile vizate și despre metodologia completă de atribuire, rămâne de urmărit în ce măsură aceste operațiuni vor duce la măsuri suplimentare de verificare a autorilor și a surselor, atât în media, cât și pe rețelele sociale. [...]