Știri

Știri din categoria Inteligență artificială

Google încearcă să folosească DMCA ca barieră anti-scraping, dar instanța i-a respins cazul pe motiv de „lipsă de calitate procesuală”, iar miza se mută acum pe cât de departe pot merge platformele în a „închide” accesul la date publice de pe web, potrivit Ars Technica.
Google a dat în judecată SerpApi în decembrie, invocând Digital Millennium Copyright Act (DMCA) – lege americană folosită frecvent pentru a combate ocolirea măsurilor tehnice de protecție a conținutului. Compania a susținut că SerpApi ar fi eludat tehnologiile anti-scraping ale Google, apoi ar fi vândut conținut extras din rezultatele de căutare printr-un „Google Search API” neautorizat. În argumentația Google, această ocolire ar fi pus în pericol relațiile cu deținători de drepturi, inclusiv cu cei care licențiază conținut ce apare în „knowledge panels” (casete informative afișate în unele rezultate).
Instanța a admis devreme cererea SerpApi de respingere a acțiunii (motion to dismiss), iar judecătorul a concluzionat că Google nu are calitate să dea în judecată în baza DMCA, deoarece nu deține conținutul din rezultatele de căutare și nu a arătat că acționează în numele unor deținători de drepturi.
Meredith Rose, consilier de politici publice la organizația Public Knowledge, specializată în DMCA, a spus că argumentația Google și Reddit pare o încercare de a „apuca orice instrument disponibil” în fața creșterii accelerate a scraping-ului pentru inteligență artificială din ultimii trei ani. Ea a descris folosirea DMCA în acest context drept „bizară” și în afara scopului inițial al legii, dar nu surprinzătoare, având în vedere eficiența istorică a DMCA ca instrument rapid de blocare și de forțare a discuțiilor despre licențiere.
Deși a pierdut această rundă, Google a primit 21 de zile pentru a-și modifica plângerea. Compania a recunoscut că rezultatele de căutare nu pot fi protejate prin drepturi de autor, dar a încercat să își ancoreze cazul în ideea că „knowledge panels” pot include conținut protejat, licențiat de la deținători de drepturi.
Un purtător de cuvânt al Google, José Castañeda, a declarat că firma intenționează să depună o plângere modificată și că este „mulțumită” că instanța a respins „aproape toate” argumentele SerpApi care contestau calitatea procesuală a Google.
Rose avertizează însă că această linie de apărare poate împinge Google într-un colț: dacă susține că acele casete sunt „pline” de material protejat, compania riscă să deschidă discuții despre conținut neacoperit de licențe și, implicit, despre posibile litigii viitoare legate de încălcarea drepturilor sau despre „utilizarea echitabilă” (fair use).
Reddit a mers pe o strategie similară, după ce a intentat în octombrie un proces apropiat ca logică, acuzând SerpApi și Perplexity că ar fi extras conținut Reddit care apare în rezultatele Google. Potrivit relatării, nu este clar cum va decide instanța în cazul Reddit, însă Rose consideră că hotărârea din dosarul Google nu este un semn bun pentru Reddit, deoarece acesta nu poate pretinde că este proprietarul sau licențiatul exclusiv al conținutului din rezultatele de căutare.
SerpApi spune că lupta este costisitoare, dar o vede ca pe o apărare a „webului deschis” și acuză Google și Reddit că încearcă să folosească DMCA pentru a „zidi” Internetul prin revendicarea retroactivă a controlului asupra unui conținut pe care nu l-au creat și nu îl dețin.
În plan operațional, SerpApi afirmă că procesele au creat incertitudine pentru clienți – compania menționează Nvidia, Uber și Adobe – care ar depinde zilnic de acces structurat la date de căutare.
În plan mai larg, Rose leagă disputa de ceea ce numește „re-îngrădirea” webului, accelerată după vara lui 2023, când tot mai mulți actori au început să limiteze accesul automatizat, pe fondul creșterii scraping-ului pentru AI. Ea avertizează că efectele nu se opresc la antrenarea modelelor de inteligență artificială, ci pot afecta și cercetarea, arhivarea, jurnalismul sau raportările din sănătate publică, care se bazează pe crawling anonim și scraping la scară mare.
Ce urmează: după expirarea termenului de 21 de zile, va deveni mai limpede dacă Google poate formula o plângere suficient de îngustă încât să supraviețuiască în instanță și dacă dosarul Reddit va fi respins pe o logică similară.
Recomandate
Universal Music Group își mută strategia de la litigii la monetizare printr-un acord multianual de licențiere cu ElevenLabs , care ar trebui să ducă la o platformă separată de creare muzicală pentru fani, potrivit The Next Web . Miza economică este că marile case de discuri încearcă să transforme remixurile și vocile sintetice dintr-un risc de piraterie într-un produs licențiat, cu plăți și control asupra drepturilor. Platforma, aflată în dezvoltare, ar urma să permită realizarea de remixuri, „mashup”-uri (colaje din mai multe piese), reinterpretări și „experiențe vocale personalizate” pe baza pieselor artiștilor care aleg să participe. Acordul acoperă atât dezvoltarea produsului, cât și licențierea, și ar urma să se extindă în anii următori către alte produse pentru artiști și fani. Important operațional: produsul va fi lansat de ElevenLabs și va funcționa separat de Music API și de ElevenMusic, produsele existente ale companiei. Ce lipsește din anunț și de ce contează Acordul nu înseamnă acces la întregul catalog Universal, ci doar la artiștii și compozitorii care „opt-in” (își dau acordul). Publicația notează că nu sunt numite nume de artiști, nu există o dată de lansare și nu sunt făcuți publici termenii financiari. În practică, tocmai aceste detalii vor decide dacă inițiativa devine o linie de venit relevantă sau rămâne un experiment de nișă: câți artiști intră, ce compensații primesc și ce drepturi se acordă asupra rezultatelor generate de fani. Licențe și procese, în paralel: mecanismul de stabilire a „prețului” pentru AI În context, The Next Web descrie o industrie care rulează simultan două strategii: acorduri de licențiere și litigii. Exemplele menționate includ faptul că Sony dă în judecată Udio pentru peste 30.000 de piese (conform articolului), iar o instanță germană a decis că Suno a încălcat drepturi de autor. În același timp, apar acorduri de licențiere: Suno a lansat modele antrenate pe catalog licențiat de la Warner și BMG, iar Universal a mai încheiat un acord legat de „AI covers” și remixuri cu Spotify. În această logică, un acord precum cel cu ElevenLabs are și o funcție defensivă: Universal devine partener de distribuție și monetizare, nu reclamant, iar produsul licențiat ar putea canaliza cererea fanilor către un cadru controlat. De ce e un pas sensibil pentru Universal: vocile sintetice Partea „incomodă”, subliniată în articol, este că ElevenLabs este cunoscută pentru tehnologie de clonare vocală, iar „experiențele vocale personalizate” ating exact zona pe care industria a încercat să o controleze strict. Publicația amintește că Universal a obținut în 2023 eliminarea de pe platforme de streaming a unui fals generat de AI care imita doi artiști ai săi, iar ElevenLabs a fost asociată în relatările anterioare ale publicației cu proiecte de „revigorare” digitală a vocii lui Stan Lee. În acest cadru, acordul nu este prezentat ca o schimbare de principiu, ci ca o încercare de a aduce sub licență un fenomen care oricum există: dacă vocile sintetice vor circula, casa de discuri preferă să existe consimțământ și plată, nu viralizare neautorizată. Întrebările-cheie: cine deține rezultatul și unde poate fi distribuit Eficiența comercială a platformei depinde de aspecte pe care anunțul nu le detaliază: dacă un fan generează o voce personalizată a unui artist participant, cine deține rezultatul, cum poate fi sublicențiat și dacă poate fi urcat pe servicii de streaming. Separat, există și un strat de conformare: pentru că ElevenLabs operează sub Regulamentul european privind inteligența artificială (AI Act), un produs pentru consumatori care generează voci sintetice ale unor persoane identificabile implică obligații de transparență (etichetare), indiferent cât de bine sunt „curățate” drepturile de autor. Cu alte cuvinte, licența poate rezolva disputa de copyright, dar nu elimină automat obligațiile de informare privind conținutul generat de AI. [...]
Google extinde accesul la Gemini pe PC printr-o aplicație dedicată pentru Windows 10 și 11 , o mutare care poate reduce fricțiunea de utilizare în companii și pentru utilizatorii care lucrează preponderent în aplicații desktop, prin acces rapid și integrare cu fluxurile de lucru existente, potrivit Google . Aplicația este gândită să ruleze „alături” de instrumentele și aplicațiile folosite zilnic, oferind asistență fără a întrerupe activitatea curentă. Google susține că aplicația este „ușoară și silențioasă” și nu încetinește PC-ul. Ce schimbă operațional: acces rapid și spațiu dedicat de lucru Google descrie trei scenarii principale de utilizare pe Windows: Deschidere instant prin scurtătură de tastatură : combinația Alt + Space deschide Gemini peste fereastra activă, pentru verificări rapide sau idei de conținut, după care utilizatorul revine în fluxul de lucru. Lucru „în profunzime” într-un spațiu dedicat : aplicația oferă acces la funcțiile deja disponibile în Gemini, inclusiv posibilitatea de a delega sarcini în mai mulți pași către Gemini Spark (descris ca „agent personal AI 24/7”). Tot aici, Gemini poate redacta un rezumat de proiect folosind informații din aplicațiile Google, precum Gmail și Google Drive. Generare de conținut vizual : utilizatorii pot crea imagini și pot genera video, inclusiv prin Gemini Omni , direct din aplicația desktop. Disponibilitate și ce urmează Aplicația Gemini pentru Windows este disponibilă „astăzi”, la nivel global, pentru Windows 10 și Windows 11 , iar descărcarea se face de la gemini.google/desktop (menționat în sursă). Google precizează că „este doar începutul” și că vor fi adăugate în timp „mai multe capabilități native” pentru desktop, fără a detalia un calendar. În privința datelor și confidențialității, sursa trimite la politica de confidențialitate Google . [...]
Google extinde controlul vocal în Workspace , introducând trei funcții conversaționale care pot reduce timpul pierdut cu căutări și redactare în Gmail, Docs și Keep, potrivit Google . Noutatea are miză operațională pentru utilizatori și echipe: interacțiunea „hands-free” (fără tastatură) mută o parte din munca de căutare, structurare și redactare în fluxuri ghidate de modele audio Gemini. Ce se schimbă în Gmail, Docs și Keep Google lansează capabilități bazate pe „ Gemini Audio models ” (modele de inteligență artificială care înțeleg și generează vorbire), prezentate anterior în Workspace la I/O, iar acum disponibile ca funcții noi în trei aplicații. Gmail Live: căutare conversațională în inbox Gmail Live permite utilizatorilor să „întrebe” direct, pe voce, lucruri precum „Care este numărul porții de îmbarcare?” sau „Ce se întâmplă săptămâna aceasta la școala copilului?”, iar funcția scanează inboxul și returnează rapid răspunsuri, fără căutare manuală prin fire lungi de e-mailuri. Docs Live: redactare și structurare prin dialog Docs Live este poziționat ca „partener de idei” și coautor: utilizatorul vorbește, iar instrumentul organizează ideile și structurează documentul pentru a ajunge mai repede la o primă versiune. Google precizează că, „cu permisiunea” utilizatorului, Docs Live poate extrage detalii relevante din Gmail, Drive și Chat, dar și de pe web, pentru a completa contextul. Keep Live: transformă „brain dump” în notițe organizate În Keep, funcția vocală nouă preia un flux liber de idei și îl procesează „în fundal”, transformându-l în liste și notițe structurate, fără tastare. Disponibilitate și condiții de acces Funcțiile „conversaționale” încep să fie distribuite „săptămâna aceasta”, conform Google. Accesul este condiționat de tipul de abonament: Gmail Live și Keep Live : disponibile pentru abonații Google AI Plus, Pro și Ultra (detalii despre planuri: Google One – Google AI plans ). Docs Live : disponibil pentru abonații Pro și Ultra . Pentru clienții Google Workspace business , Google spune că funcțiile „vin în curând”, fără un calendar mai precis în material. Ce rămâne de urmărit pentru companii Pentru organizații, miza imediată este modul în care aceste funcții vor fi integrate în pachetele business și ce politici interne vor fi necesare pentru utilizarea extragerii de informații din e-mail și fișiere „cu permisiunea” utilizatorului. Google trimite la politica sa de confidențialitate pentru cadrul general: Google Privacy Policy . [...]
Google își extinde colaborarea cu MrBeast într-un parteneriat pe mai mulți ani, care mută utilizarea Gemini din zona de divertisment în demonstrații publice de utilizare practică și include și Google Health , potrivit Google Blog . În esență, Google își leagă produsele de un creator cu audiență uriașă pentru a arăta, în contexte „de teren”, cum poate fi folosită inteligența artificială generativă (AI care produce conținut și sugestii) în situații concrete. Parteneriatul este încheiat cu Beast Industries și „extinde relația dincolo de YouTube” către Gemini și Google Health. Google îl prezintă pe Jimmy Donaldson (MrBeast) drept „primul creator” care a atins 500 de milioane de abonați pe YouTube , iar colaborarea urmărește ca acesta să folosească Gemini pentru a-și executa concepte „mai sălbatice” și, în paralel, să arate cum Google Health poate sprijini obiective zilnice de fitness și stare de bine. Ce se vede prima dată: un clip pe 5 septembrie, cu Gemini folosit în scenarii extreme Primul material anunțat este un nou videoclip MrBeast programat pentru 5 septembrie, în care echipa încearcă să supraviețuiască în „unele dintre cele mai extreme și periculoase climate” de pe Pământ. Conform sursei, echipele vor concura în trei medii: junglă, deșert, Arctica, folosind Gemini pentru a identifica pericole, a face față schimbărilor brutale de vreme și a rămâne „cu un pas înainte”. Extinderea dincolo de YouTube: campanie Gemini și integrarea Fitbit Air Google mai spune că MrBeast va apărea într-un „nou lansat” (recent lansat) demers de promovare pentru Gemini, unde va arăta cum folosește aplicația ca partener pentru partea de logistică a cascadoriilor sale. În plus, compania precizează că Jimmy va integra „Fitbit Air” într-o provocare viitoare. Google nu oferă în material detalii financiare, termeni contractuali sau calendar complet al activărilor, dar descrie colaborarea drept începutul unui proiect mai amplu, cu noi apariții pe canalele MrBeast și pe conturile Gemini. [...]
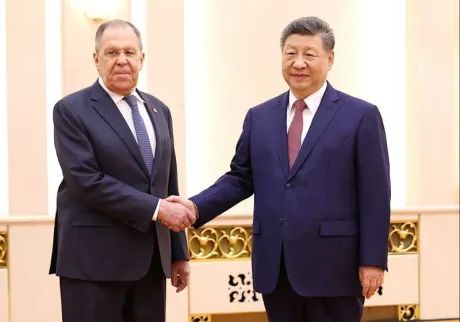
China împinge BRICS spre o cooperare tehnologică aplicată printr-o „zonă comună” de AI open-source , o inițiativă care ar putea influența modul în care economiile din grup își coordonează dezvoltarea și utilizarea modelelor avansate de inteligență artificială, potrivit Wall Street . Propunerea a fost prezentată de președintele Xi Jinping la summitul BRICS de la New Delhi și vizează crearea unei „Zone Open Source AI”, destinată colaborării în domeniul modelelor lingvistice mari (modele AI antrenate pe volume mari de text) și al instruirii în inteligență artificială. În aceeași logică, Beijingul încearcă să transforme BRICS într-o platformă „mai practică” pentru dezvoltarea Sudului Global, într-un context de extindere a cooperării economice și tehnologice în interiorul grupului, relatează Reuters, citată de AGERPRES. Ce ar include „Zona Open Source AI” propusă de China Conform informațiilor prezentate, proiectul ar urmări să stimuleze cooperarea între statele BRICS pe mai multe direcții operaționale: dezvoltarea și utilizarea modelelor lingvistice mari; instruirea și formarea în domeniul inteligenței artificiale; construirea unui „ecosistem deschis” de AI, adică bazat pe colaborare și acces mai larg la tehnologii și resurse. Xi Jinping a legat succesul „Inițiativei Greater BRICS” de construirea unei baze solide pentru „cooperare pragmatică”, potrivit agenției chineze Xinhua. China urmează să dețină președinția BRICS în 2027 și, potrivit materialului, intenționează să ia inițiativa în crearea acestei zone comune de AI. Miza economică: lanțuri de aprovizionare, piață integrată și proiecte comerciale Dincolo de componenta tehnologică, Xi a cerut statelor BRICS să coopereze mai strâns pentru menținerea stabilității lanțurilor industriale și de aprovizionare și pentru dezvoltarea unei piețe integrate. Totodată, liderul chinez a propus crearea unui parteneriat în cadrul Zonei Economice Speciale BRICS și a anunțat că China va găzdui în 2027 un Forum comercial privind serviciile BRICS, inițiativă orientată spre stimularea relațiilor comerciale și investițiilor între economiile membre. Reacții în BRICS și contextul politic al extinderii Premierul indian Narendra Modi a susținut că beneficiile soluțiilor dezvoltate în cadrul BRICS nu ar trebui să rămână limitate la statele grupului, ci să fie „suficient de accesibile și adaptabile” pentru a răspunde și nevoilor statelor din Sudul Global. La rândul său, președintele rus Vladimir Putin a descris BRICS drept o „forță motrice puternică” pentru construirea unei noi ordini mondiale „mai echitabile și multipolare” și a cerut statelor membre să găsească modalități de a combina avantajele competitive ale economiilor lor. BRICS reunește Brazilia, Rusia, India, China, Africa de Sud, Egipt, Etiopia, Iran, Arabia Saudită, Emiratele Arabe Unite și Indonezia. Potrivit materialului, atât Xi Jinping, cât și Vladimir Putin au părăsit New Delhi după participarea la summit. [...]
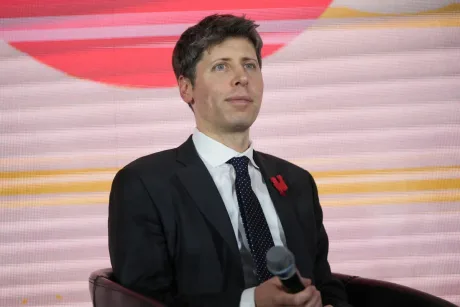
OpenAI nu vizează listarea la bursă în 2026 , iar CEO-ul Sam Altman spune că, în contextul discuțiilor despre siguranța inteligenței artificiale, ar fi „neînțelept” ca firma să devină publică acum, potrivit TechCrunch . Altman a confirmat că OpenAI a depus confidențial documentația pentru o ofertă publică inițială (IPO), însă a respins ideea unei listări în acest an și a indicat că 2026 nu mai este ținta. Într-un interviu acordat recent editorului-șef Fortune, Alyson Shontell, el a spus că OpenAI „nu se grăbește” către IPO și că momentul este nepotrivit „având în vedere tot ce se întâmplă cu siguranța”. „Nu ne grăbim către un IPO. Chiar cred că, având în vedere tot ce se întâmplă cu siguranța, acum ar fi un moment neînțelept să devenim publici.” De ce contează: presiunea pieței publice vs. riscurile de siguranță Mesajul lui Altman sugerează că OpenAI încearcă să evite constrângerile suplimentare ale pieței publice într-o perioadă în care compania se află sub presiune din două direcții: așteptările de creștere rapidă și intensificarea dezbaterilor despre riscurile și controlul tehnologiilor de inteligență artificială. În logica lui Altman, listarea ar trebui să vină abia „când suntem pregătiți”, atât din perspectiva businessului, cât și a „momentului din societate” legat de această tehnologie. Întrebat direct dacă asta înseamnă că IPO-ul nu se va întâmpla în 2026, Altman a răspuns: „Aș spune că nu în 2026, da. Avem multe de făcut.” Ce se știa despre calendarul IPO-ului TechCrunch notează că The New York Times a relatat în iunie că OpenAI ar fi angajat bancheri și avocați cu obiectivul de a se lista în trimestrul al treilea sau al patrulea din 2026, dar că firma ar fi înclinat spre 2027, invocând volatilitatea acțiunilor din tehnologie și propriile dificultăți financiare. În acest moment, din declarațiile lui Altman reiese doar că 2026 este exclusă, fără un nou termen ferm anunțat public pentru listare. [...]