Știri

Știri din categoria Inteligență artificială
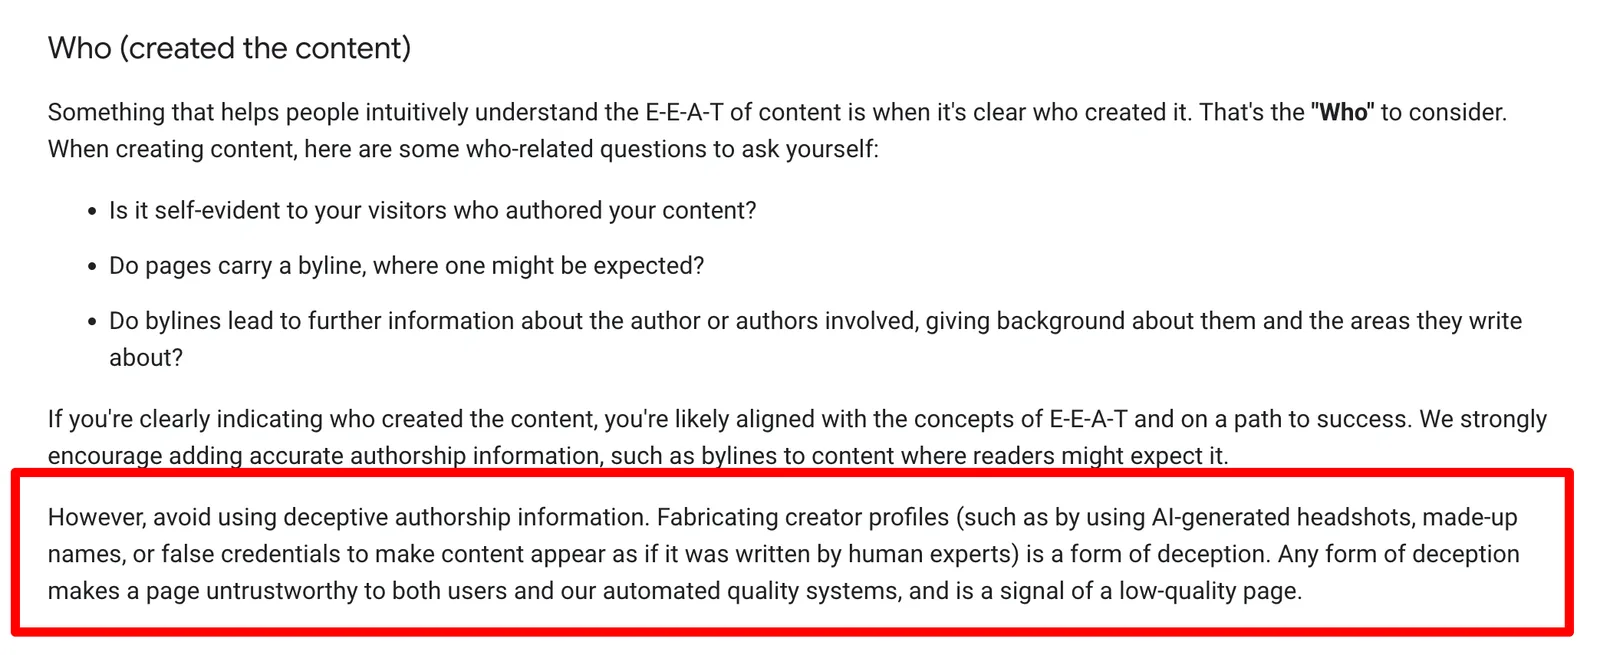
Google își înăsprește criteriile de calitate și avertizează că profilurile de autor fabricate pot trage în jos credibilitatea unei pagini, potrivit Search Engine Roundtable. Mesajul apare odată cu actualizări în documentația Google despre „conținut util” și vizează explicit „informațiile înșelătoare despre autor” din pagini.
Avertismentul, introdus într-un nou paragraf din documentația Google, spune că fabricarea profilurilor de creator — inclusiv folosirea de fotografii de tip portret generate cu inteligență artificială, nume inventate sau acreditări false pentru a face conținutul să pară scris de experți umani — este „o formă de înșelăciune”. Google susține că orice formă de înșelăciune face pagina „nedemnă de încredere” atât pentru utilizatori, cât și pentru „sistemele automate de evaluare a calității”, și reprezintă un semnal de „pagină de calitate scăzută”.
Google formulează o listă de interdicții, cu accent pe prezentarea autorului:
Din perspectiva operațională, avertismentul ridică miza pentru site-urile care folosesc conținut produs la scară mare și încearcă să-l „îmbrace” în semnale de expertiză prin identități artificiale. Google leagă direct aceste practici de evaluarea automată a calității, ceea ce poate influența vizibilitatea în căutare.
Publicația notează că Google comunicase anterior că nu este îngrijorat de falsificarea informațiilor despre autori, dar „se pare că vremurile s-au schimbat”. În noua formulare, compania tratează explicit astfel de practici ca înșelătoare și ca indicator de calitate scăzută.
Pentru companii, implicația imediată este nevoia de audit al paginilor și al paginilor de autor: dacă identitatea autorilor, fotografiile sau acreditările nu pot fi susținute, riscul este ca paginile să fie considerate mai puțin de încredere de către utilizatori și de sistemele automate ale Google.
Recomandate
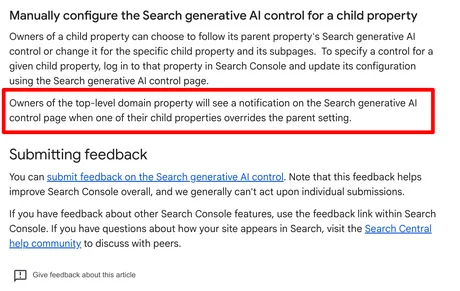
Google a adăugat un mecanism de notificare pentru proprietarii de domenii de nivel superior (TLD) în pagina de control a funcțiilor de AI generativ din Search Console , astfel încât aceștia să vadă când o proprietate „copil” (de tip subdomeniu sau altă proprietate asociată) suprascrie setarea stabilită la nivel de „părinte”, potrivit Search Engine Roundtable . Schimbarea vizează pagina „Search generative AI control” din Google Search Console și este legată de modul în care se aplică setările de control pentru funcțiile de inteligență artificială generativă în Căutare, în special în conturile unde există ierarhii de proprietăți (de exemplu, domeniu principal și proprietăți derivate). Ce s-a schimbat, concret, în Search Console Google a actualizat documentația „deep dive” (ghid detaliat) pentru această funcționalitate și a introdus o precizare operațională: proprietarii unei proprietăți de tip domeniu de nivel superior vor primi o notificare în pagina de control atunci când una dintre proprietățile copil suprascrie setarea părintelui. Formularea adăugată de Google, redată în articol, este: Proprietarii proprietății de domeniu de nivel superior vor vedea o notificare pe pagina de control a AI generativ din Căutare atunci când una dintre proprietățile copil suprascrie setarea părintelui. De ce contează pentru administrarea site-urilor Din perspectivă operațională, actualizarea reduce riscul ca setările de control pentru AI generativ să fie aplicate neuniform fără ca administratorii domeniului să observe. În practică, pentru organizațiile care gestionează mai multe proprietăți sub același domeniu (branduri, piețe, subdomenii, versiuni regionale), vizibilitatea asupra „excepțiilor” făcute la nivel de proprietate copil devine mai ușor de urmărit direct în interfața Search Console. Google reamintește, totodată, că aceste controale sunt „acum disponibile la nivel global”, conform articolului. [...]
Google își accelerează filtrele anti-spam și folosește AI pentru a prinde „spam făcut cu AI”, pe fondul unei creșteri masive a volumului de conținut online , potrivit Search Engine Roundtable . Mesajul, transmis la un eveniment Google Search Central Live Deep Dive din Europa, indică un impact operațional direct pentru publisheri și companii: volatilitate mai mare în trafic și nevoia de controale mai stricte asupra calității, mai ales când conținutul este produs „la scară”. Informațiile provin dintr-un rezumat semnat de John Campbell, publicat de We Are Roast, despre motivele pentru care Google a lansat „atât de multe” actualizări anti-spam în 2026. Explicația centrală: există „mult mai mult conținut nou decât înainte”, iar o „proporție ridicată” din acest conținut este spam, ceea ce împinge Google să ajusteze mai des filtrele. Ce se schimbă operațional: AI contra spamului și praguri noi În prezentarea citată, Google ar fi spus că echipa folosește inteligența artificială pentru a identifica mai mult spam. În același timp, „AI slop” (conținut de slabă calitate generat în masă cu ajutorul AI) este în creștere și ar afecta inclusiv calitatea conținutului din feed-ul Discover. Un alt element important pentru modul în care vor evolua filtrele: feedback-ul utilizatorilor este descris ca „foarte important”, fiind baza pe care se construiesc noile filtre anti-spam. Un reper de volum: 40 de miliarde de pagini spam filtrate zilnic Gary Illyes a menționat un ordin de mărime al efortului de filtrare: Google ar filtra 40 de miliarde de pagini spam pe zi . Publicația notează însă că această cifră nu este nouă, fiind menționată și în trecut în documentația Google. De ce vor continua actualizările: formate mai multe, pagini mai multe, spam mai mult În rezumatul citat sunt enumerate trei motive pentru care Google „tot actualizează” modul în care judecă calitatea: S-au extins formatele de conținut : căutarea nu mai înseamnă doar „zece linkuri albastre”, iar fiecare format ar necesita criterii proprii de evaluare. A crescut „lățimea” conținutului : sunt mult mai multe pagini și site-uri; iar actualizările de tip „core” ar viza conținutul la nivel de pagină, nu domeniul, ceea ce explică de ce unele pagini cresc și altele scad pe același site. Probleme de conținut (spam) : actualizările îmbunătățesc detectarea unor practici precum cloaking, doorway pages, conținut copiat, spam de linkuri, conținut compromis (hacked). În plus, este menționat un avertisment că „scaled content” (conținut produs la scară, cu efort redus) devine o problemă mai mare decât spamul de linkuri. La ce să se aștepte site-urile: mai multe „spam updates” și risc crescut pentru conținutul „la scară” Concluzia rezumatului este directă: „așteptați-vă la mai multe actualizări anti-spam”, pe măsură ce Google gestionează „un val în creștere” de conținut de slabă calitate generat cu AI. Sunt menționate și „noi praguri” anti-spam, iar riscul principal este asociat conținutului „scaled, low-effort” — produs în volum mare, cu valoare redusă pentru utilizator. [...]
Google își înăsprește regulile de clasare, vizând direct site-urile care folosesc autori inventați și fotografii generate de AI , o practică asociată cu „fabricarea” credibilității pentru a împinge conținut de slabă calitate în Search și Google News , potrivit Futurism . Schimbarea vine după o investigație a publicației despre Brown Brothers Media , o companie care ar fi atras zeci de milioane de vizualizări lunar cumpărând site-uri de știri în dificultate și transformându-le în „mori” de conținut alimentate de inteligență artificială. Modelul descris: inventarea de jurnaliști și „experți”, cu istorii personale și acreditări false, folosiți ca semnături pentru mii de articole optimizate pentru motoare de căutare (SEO). Materialele erau adesea plagiate, bazate pe experiențe inventate sau atât de neglijente încât nu ofereau valoare cititorilor, susține Futurism. Ce a schimbat Google în ghiduri și de ce contează Google a actualizat ghidurile pentru „conținut util, de încredere, orientat către oameni” și a introdus explicit interdicția de a folosi informații înșelătoare despre autor. Înainte, documentația încuraja includerea de informații corecte despre autor (byline), ca semnal de aliniere la E-E-A-T (experiență, expertiză, autoritate și încredere). Acum, compania adaugă un paragraf nou, cu formulare mai dură, care califică drept „înșelăciune” fabricarea profilurilor de creatori. „Totuși, evitați folosirea informațiilor înșelătoare despre autor. Fabricarea profilurilor creatorilor (de exemplu, folosind fotografii generate de AI, nume inventate sau acreditări false pentru a face conținutul să pară ca și cum ar fi fost scris de experți umani) este o formă de înșelăciune. Orice formă de înșelăciune face o pagină nedemnă de încredere atât pentru utilizatori, cât și pentru sistemele noastre automate de calitate și este un semnal al unei pagini de calitate scăzută.” Implicația operațională este directă: site-urile care se bazează pe astfel de artificii riscă să nu mai fie „prioritizate” de Google, adică să piardă vizibilitate în rezultate și, implicit, trafic. Context: presiune pe „fabricile” de conținut, dar efect incert pentru presă Futurism notează că, potrivit datelor pe care le-a analizat, o parte importantă din audiența operațiunii descrise ar fi venit din Google. După publicarea investigației, Google ar fi acționat pentru a reduce prezența site-urilor Brown Brothers pe platforme precum Search și Google News, iar ulterior compania ar fi oprit brusc publicarea. Actualizarea ghidurilor apare și pe fondul altor cazuri similare: în Canada, o publicație a fost pusă în dificultate după ce „reporterii” inexistenți au început să afișeze mesaje de eroare, iar un alt caz a implicat plagiat sub numele unui jurnalist indigen inventat. Scheme asemănătoare au fost documentate și în Florida și Rhode Island. Totuși, aceeași sursă avertizează că nu este sigur că această „crackdown” pe semnături false va ajuta semnificativ ecosistemul media, în condițiile în care Google folosește tot mai mult inteligența artificială și promovează rezumate generate automat, care pot reduce traficul către reportajele originale. [...]
Google, OpenAI și Anthropic vor să-și facă propriul „arbitru” de siguranță pentru IA, fără supraveghere guvernamentală , cu o lansare vizată până la finalul lui 2026 sau la începutul lui 2027, potrivit The Next Web , care citează un articol The Information. Miza este una de reglementare: marile laboratoare încearcă să stabilească standarde și proceduri înainte ca autoritățile să impună reguli mai dure. Inițiativa ar urma să se numească, provizoriu, „ Standards Authority for Frontier AI ”, conform unor persoane familiarizate cu discuțiile, citate de jurnaliștii Leo Schwartz și Stephanie Palazzolo de la The Information. Publicația precizează că nu a verificat independent informațiile. Un model de „autoreglementare” inspirat de FINRA Planul ar fi construit după modelul FINRA, organizația de autoreglementare din SUA pentru firmele de brokeraj. Conform relatărilor apărute după materialul The Information, noul organism ar putea: stabili standarde pentru testarea modelelor înainte de lansare; defini reguli de raportare a incidentelor de siguranță; certifica auditori externi. Puterea de aplicare a acestor reguli (mecanismele de sancționare) nu este, însă, clarificată în acest stadiu. De ce nu mai vor supraveghere federală Potrivit aceluiași raport, companiile ar fi vrut inițial un organism cu supraveghere federală. Planul s-ar fi blocat după ce un proiect de ordin executiv al Casei Albe nu a strâns suficient sprijin în interiorul administrației Trump. Context: presiune internațională pentru standarde și critici la adresa „self-policing” Demersul vine după o săptămână intensă pe zona de guvernanță a inteligenței artificiale. Pe 22 septembrie, 21 de țări și Uniunea Europeană au cerut supraveghere internațională pentru „frontier AI” (modele de vârf, la limita capabilităților curente). A doua zi, Sam Altman a spus în Consiliul de Securitate al ONU că OpenAI ar încetini ritmul și a cerut standarde naționale și internaționale pentru această categorie de IA. În paralel, ideea de autoreglementare a atras critici: Bill Gates a declarat că autoreglementarea nu este suficientă, iar fostul executiv Meta Nick Clegg a spus, la HumanX în Amsterdam, că laboratoarele de IA nu se pot reglementa singure. La început, noul organism ar urma să acopere doar cele trei laboratoare (Google, OpenAI și Anthropic), iar relatările nu indică includerea Microsoft, Meta sau xAI. [...]
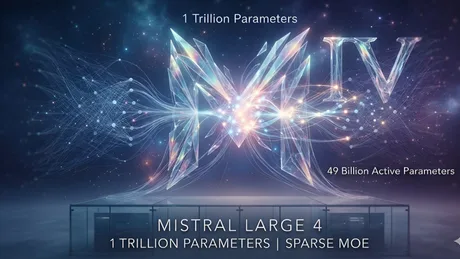
Modelul Mistral Large 4 își revendică avantajul mai ales la sarcini juridice și de reglementare , într-un context în care, pe indicatorii generali de performanță, este depășit de mai multe modele rivale, potrivit unei analize din Wccftech . Miza pentru companii este una de conformare: un model care punctează mai bine pe „task-uri” legale poate fi mai util în fluxuri unde interpretarea și aplicarea regulilor (politici interne, cerințe de audit, obligații de raportare) contează mai mult decât scorurile brute la benchmark-uri generale. Ce este Mistral Large 4 și cum e construit Mistral Large 4, supranumit „Le Chonk”, este descris ca un model „frontier-class” cu arhitectură sparse Mixture-of-Experts (MoE) – adică un sistem care activează doar o parte din „experți” (sub-rețele specializate) pentru fiecare cerere, pentru a reduce costul de calcul. Modelul are 1 trilion de parametri, dar activează 49 de miliarde la un moment dat, direcționând dinamic fiecare „token” (unitate de text procesată) către experții relevanți. Publicația mai notează că modelul poate procesa simultan text și imagini și include optimizări pentru identificarea și interpretarea coordonatelor sau obiectelor din imagini complexe (de exemplu, fotografii aeriene și satelitare). Stratul de atenție ar fi optimizat pentru a gestiona nativ peste 160 de limbi, inclusiv toate limbile oficiale ale Uniunii Europene. Performanță: bine pe inginerie software, dar nu lider pe clasamentele „live” Wccftech indică un scor de 62% pe DeepSWE v1.1 , citând VentureBeat, benchmark care urmărește capabilități de inginerie software pe orizont lung. Totuși, în clasamentul „live” DeepSWE, GLM-5.3 ar fi în jur de 69%, Kimi K3 tot în jur de 69%, iar GPT-6 Astra, Gemini 3.8 Flash și Claude Opus 5 ar fi în zona de aproximativ 74%. În paralel, Artificial Analysis ar fi acordat modelului un scor de 38 în „Artificial Analysis Intelligence Index”, descriindu-l drept „cel mai inteligent model din afara SUA și Chinei”. În „Artificial Analysis Cyber Index”, modelul ar avea 50, la egalitate cu GLM-5.3-Flash (50) și sub MiMo-V2.6-Pro (56). Unde „conduce” efectiv: sarcini legale și reglementare Potrivit analizei, singurul benchmark unde Mistral Large 4 „conduce” cu adevărat este „Harvey’s Legal Agent”, care măsoară performanța pe sarcini juridice din lumea reală, inclusiv pe reglementări. Acesta este și unghiul central al materialului: avantajul competitiv al modelului ar fi mai degrabă în zona de conformare și interpretare a regulilor decât în performanța generală. Costuri și implicații operaționale Modelul nu este prezentat ca fiind ieftin. Wccftech citează Artificial Analysis, care notează un cost de „1,13 dolari per sarcină din Intelligence Index”, cu prețuri standard de 1,36 dolari/4,18 dolari per 1 milion de tokeni input/output și 0,14 dolari per 1 milion de tokeni pentru input „cached” (stocat pentru reutilizare) – adică aproximativ 5,2 lei, respectiv 6,3 lei/19,4 lei și 0,6 lei (conversie aproximativă). Pe partea de „fereastră de context” (cantitatea de informație pe care o poate ține minte într-o singură interacțiune), modelul ar suporta 524.288 tokeni, sub „tipicul” de 1 milion de tokeni menționat pentru multe modele cu „open weights” (greutăți deschise) din China. Ieșirea maximă ar fi de 262.144 tokeni. Cum a fost antrenat Mistral ar fi folosit 4.000 de GPU-uri NVIDIA Grace Blackwell, timp de două luni, pentru a antrena modelul „de la zero” pe servere din Europa. Laboratorul ar fi utilizat și fluxuri de învățare prin recompensă (Reinforcement Learning) pentru a îmbunătăți raționamentul, programarea, capabilitățile „agentice” și alinierea la preferințe umane. În ansamblu, din datele citate, Mistral Large 4 pare poziționat mai convingător ca instrument pentru sarcini cu componentă juridică și de reglementare, în timp ce, pe benchmark-uri generale, rămâne în urma unor competitori care conduc clasamentele curente. [...]
Giorgia Meloni încearcă să-și blindeze juridic identitatea vocală în UE după ce a depus la EUIPO o cerere de înregistrare a vocii ca marcă, pe fondul riscurilor tot mai mari de deepfake-uri generate de inteligență artificială, potrivit Agerpres . Cererea, datată 5 octombrie pe site-ul Oficiului Uniunii Europene pentru Proprietate Intelectuală (EUIPO) și confirmată de biroul premierului italian, include o înregistrare audio de patru secunde în care Meloni repetă de două ori, în italiană, „Io sono Giorgia” („Eu sunt Giorgia”). Formula este și titlul autobiografiei sale publicate în 2021, asociată unei declarații din 2019 care a circulat ulterior inclusiv sub forma unei piese disco. Ce urmărește demersul și unde se află procedura Din perspectiva protecției împotriva falsurilor digitale, înregistrarea vocii ca marcă ar putea oferi un instrument juridic suplimentar în UE, însă nu garantează oprirea folosirii vocii în conținuturi deepfake. Potrivit presei italiene citate de Agerpres, chiar și în cazul aprobării cererii, măsura nu ar fi suficientă pentru a împiedica utilizarea vocii sale în deepfake-uri, dar ar putea ridica „obstacole juridice suplimentare” pentru cei care ar încerca să o reproducă. În acest moment, cererea depusă la EUIPO este încă în faza de examinare. Context: deepfake-uri și acțiuni în instanță În ultimii ani, imagini manipulate cu Giorgia Meloni au circulat repetat online și au fost uneori distribuite ca autentice, inclusiv o imagine în care apărea așezată pe un pat, în lenjerie intimă. Meloni a condamnat astfel de conținuturi, pe care le-a descris drept tentative de dezinformare și de țintire a unor persoane, îndemnând utilizatorii să verifice conținutul înainte de distribuire. În 2024, premierul italian a inițiat o acțiune în justiție împotriva unui bărbat din Sardinia, acuzat că a creat și publicat online imagini pornografice deepfake în care îi folosea chipul; cazul este pe rolul unei instanțe italiene. [...]