Știri

Știri din categoria Inteligență artificială
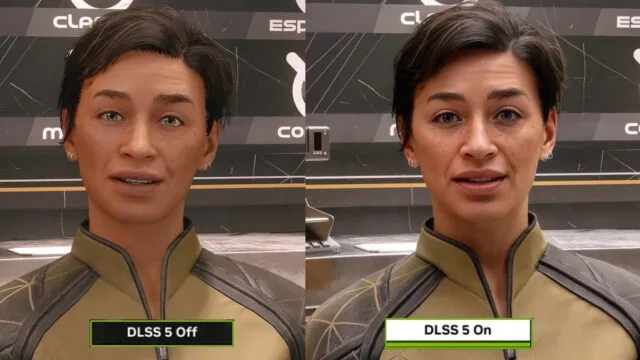
CEO-ul Nvidia spune că DLSS 5 „îmbunătățește, dar nu schimbă nimic”, pe fondul criticilor venite din comunitatea de gaming, potrivit Ars Technica. Tehnologia, prezentată public săptămâna trecută ca o versiune cu „inteligență artificială generativă” pentru îmbunătățirea scenelor din jocuri, a atras reacții negative, inclusiv acuzații că ar produce un aspect vizual uniformizat, descris de unii jucători drept „AI slop” (conținut generat de AI perceput ca ieftin, repetitiv sau fără identitate).
Într-un episod publicat luni al Lex Fridman Podcast, Jensen Huang a fost întrebat despre „drama” din jurul DLSS 5 și despre îngrijorarea că ar face jocurile să arate ca „AI slop”. Huang a spus că înțelege reacția, argumentând că o parte din conținutul generat de AI tinde să devină similar ca stil, chiar dacă este atractiv vizual.
„Înțeleg de unde vin, pentru că nici mie nu-mi place «AI slop»… tot conținutul generat de AI arată din ce în ce mai similar și toate sunt frumoase, așa că… empatizez cu ce gândesc.”
În același timp, Huang a susținut că DLSS 5 ar trebui separat de acest tip de conținut, deoarece funcționează „condiționat 3D” și „ghidat 3D”, adică pornește de la elementele construite de artiștii jocului. El a spus că echipele de dezvoltare rămân responsabile pentru geometria și texturile care formează „structura de bază” pe care DLSS 5 o folosește, iar tehnologia ar „îmbunătăți” fiecare cadru fără să schimbe conținutul.
Materialul notează însă că, în mare parte, temerile jucătorilor nu vizează apariția unor elemente complet noi, „psihedelice”, generate de la zero, ca în unele modele generative. Îngrijorarea principală este că „îmbunătățirile” ar putea netezi diferențele dintre jocuri, împingându-le spre un standard fotorealist omogen, cu identitate vizuală mai slab conturată.
Huang a respins această interpretare, spunând că DLSS 5 nu este o tehnologie aplicată ulterior, ca o etapă de post-procesare peste un joc „livrat într-o stare” și apoi modificat. În schimb, el a descris DLSS 5 ca fiind integrat în procesul creativ, „cu artistul”, și ca un instrument care ar oferi creatorilor acces la capabilități de AI generativă în cadrul fluxului de producție.
Recomandate
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
NVIDIA va investi 3 miliarde de dolari (aprox. 13,8 miliarde lei) în oferta de acțiuni a Meta , pe fondul extinderii colaborării dintre cele două companii pentru optimizarea modelelor Muse și a infrastructurii necesare rulării agenților de inteligență artificială, potrivit NVIDIA News . Parteneriatul vizează extinderea lucrului comun pe Muse și „familia” de modele Muse, cu accent pe îmbunătățirea performanței la inferență (rularea modelului în producție) și antrenare. În același timp, companiile urmăresc optimizări „pe fluxuri de lucru” pentru a maximiza performanța și a reduce costul total de deținere (total cost of ownership), adică ansamblul costurilor de infrastructură și operare pe durata utilizării. De ce contează: investiția leagă mai strâns Meta de ecosistemul NVIDIA Elementul cu impact economic direct este investiția de 3 miliarde de dolari în oferta de acțiuni a Meta, pe care NVIDIA spune că o va face în paralel cu extinderea colaborării tehnologice. În termeni practici, mișcarea consolidează relația comercială și tehnologică într-un moment în care Meta își accelerează ambițiile de infrastructură pentru agenți AI și modele de frontieră. Ce include extinderea colaborării tehnologice NVIDIA și Meta indică trei direcții principale: Optimizări pentru Muse : îmbunătățirea performanței la inferență și antrenare, plus optimizări pe întregul flux de lucru pentru eficiență și costuri mai mici. Securitate și monitorizare pentru agenți AI : luarea în calcul a unor colaborări pe NVIDIA OpenShell Reference Architecture , inclusiv OpenShell pentru implementare „sigură” și NVIDIA Sentry pentru monitorizarea comportamentului agenților. Extinderea implementărilor de infrastructură NVIDIA la Meta : Meta intenționează să extindă utilizarea NVIDIA Vera Rubin și Vera CPU , și să folosească NVIDIA Spectrum-X Ethernet și BlueField-4 pentru eficiență de rețea și creșterea debitului de date. Publicația mai notează că modelele și agenții Muse, care folosesc infrastructura NVIDIA, au avut performanțe de tip „frontier-level” în benchmark-uri și o creștere puternică a descărcărilor de la consumatori după lansare, fără a oferi însă cifre. Mesajul celor două companii: agenții AI, noua țintă operațională Jensen Huang , CEO NVIDIA, leagă extinderea parteneriatului de trecerea către agenți AI ca „nouă paradigmă de calcul”, în timp ce Mark Zuckerberg , CEO Meta, poziționează Muse ca vehicul pentru a duce „superinteligența personală” către utilizatori. În perioada următoare, consecința practică a anunțului ar trebui să fie accelerarea implementărilor de infrastructură NVIDIA la Meta și o integrare mai strânsă a instrumentelor de securitate și monitorizare pentru agenți, în măsura în care colaborările „luate în calcul” se concretizează. [...]
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
Sam Altman admite că OpenAI nu explică suficient de bine de ce „merită” riscurile AI , într-o discuție care scoate în evidență o problemă de guvernanță și responsabilitate publică pentru companiile din domeniu, potrivit Gizmodo . CEO-ul OpenAI a vorbit despre ritmul accelerat al dezvoltării inteligenței artificiale într-o apariție pe podcastul „Cheeky Pint”, găzduit de John Collison (cofondator Stripe). În contextul discuției, Altman a descris atât entuziasmul, cât și disconfortul pe care i l-a provocat capacitatea unor modele interne de a rezolva probleme tehnice dificile, cu efecte directe asupra carierelor unor specialiști. „Hold My Beer”, un indiciu despre cultura internă și miza tehnologică Altman a spus că unul dintre modelele folosite intern de OpenAI pentru a ataca probleme „deosebit de dificile” era cunoscut între angajați drept „Model Name-Hold My Beer”. El a relatat că modelul „dobora” pe rând unele dintre cele mai grele probleme de cercetare la care oameni lucraseră ani întregi. „Am avut această experiență colectivă: cele mai grele probleme de cercetare din cariera academică a oamenilor; modelul le doborâa una după alta.” (Sam Altman) Altman a adăugat că printre aceste probleme s-ar fi aflat și „multe dintre cele pe care le-am publicat”, referire care ar putea viza rezultatele făcute publice de OpenAI în zona matematicii. Publicația notează că OpenAI nu a răspuns imediat unei solicitări de clarificare. Context: tensiuni în matematică după publicarea unor rezultate asistate de AI Gizmodo plasează declarațiile în contextul reacțiilor din comunitatea matematică, după ce OpenAI a publicat „controversat” o soluție asistată de AI pentru problema Navier–Stokes, iar unii matematicieni au acuzat compania de plagiat. Ulterior, OpenAI ar fi publicat rezultate pentru „aproape 400” de probleme matematice vechi. În articol se avansează ideea că, pentru generațiile viitoare, seria de demonstrații din 2026 ar putea deveni un moment de cotitură pentru domeniu, comparabil cu impactul pe care l-a avut victoria lui Deep Blue asupra lui Garry Kasparov în șah. „Nu am făcut o treabă grozavă” în a justifica public costurile Dincolo de detaliul anecdotic al numelui intern, miza principală a discuției este recunoașterea explicită a unei dificultăți de comunicare și asumare a efectelor: Altman spune că OpenAI nu a explicat suficient de bine de ce consideră că dezavantajele potențiale ale tehnologiei sunt „worth it” (merită). „Nu cred că noi [OpenAI] am făcut o treabă grozavă în a le explica oamenilor de ce credem că toate dezavantajele potențiale ale acestei tehnologii merită.” (Sam Altman) În același registru, el a descris o stare amestecată — „excitat și fericit”, dar și cu „tristețe și melancolie” și senzația „că se termină ceva” — după ce a urmărit performanțele modelului intern. Ce rămâne neclar Articolul nu oferă detalii tehnice despre modelul „Hold My Beer” (ce arhitectură are, ce capabilități exacte, ce nivel de autonomie) și nici nu confirmă explicit care rezultate publicate au fost obținute cu ajutorul lui. În lipsa unui răspuns de la OpenAI, legătura dintre modelul intern și setul de rezultate publicate rămâne, deocamdată, la nivel de sugestie din declarațiile lui Altman. [...]
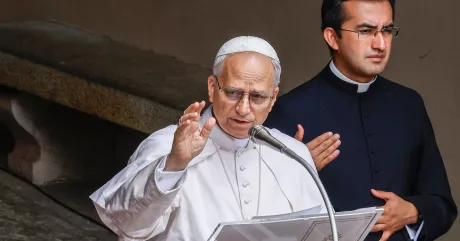
Papa Leon al XIV-lea respinge ideea de „personalitate juridică” pentru AI, avertizând că ar putea dilua răspunderea legală a oamenilor – o poziție care, dacă prinde tracțiune în dezbaterea publică și politică, poate influența direct felul în care vor fi scrise regulile de responsabilitate pentru daune produse cu ajutorul inteligenței artificiale, potrivit Futurism . Într-un fir amplu de mesaje publicat pe X (fostul Twitter), Papa a criticat apelurile pentru acordarea de drepturi modelelor de AI printr-un mecanism de „personalitate juridică” (concept prin care o entitate non-umană ar primi, în fața legii, un statut similar unei persoane). Argumentul central: o astfel de abordare ar putea muta responsabilitatea pentru abuzuri sau prejudicii „activate” de AI de la oamenii care construiesc și folosesc aceste sisteme către o entitate „fără chip”. „Mașinile sunt unelte, nu persoane.” Pontiful a susținut că viitorul inteligenței artificiale „nu este predeterminat” și că, fiind o tehnologie creată de oameni, depinde de alegerile făcute de societate, inclusiv de decizia de a-i respinge anumite utilizări. În aceeași serie de mesaje, el a cerut ca deciziile care afectează viața, libertatea și folosirea forței să rămână sub „supraveghere umană” efectivă și responsabilă și a reluat apelul ca AI să fie „dezarmată”, în contextul preocupărilor sale legate de arme autonome. De ce contează: miza este răspunderea, nu „drepturile” AI Poziția Papei se aliniază unor îngrijorări exprimate deja de avocați, activiști și legiuitori, notează publicația: acordarea de drepturi unor sisteme AI (de exemplu, drepturi echivalente libertății de exprimare) ar putea complica stabilirea vinovăției atunci când apar consecințe negative. Riscul invocat este apariția unor situații în care niciun om nu mai este identificat drept responsabil în mod clar pentru efectele acțiunilor luate „cu” sau „de” instrumente AI. Context: industria împinge în direcția „conștiinței” AI, Vaticanul rămâne prudent Materialul mai arată că, în pofida acestor rezerve, „mulți actori” din jurul industriei AI susțin că sistemele ar fi – sau ar putea deveni curând – conștiente, ceea ce ar justifica, în opinia lor, acordarea de drepturi. Ca exemplu, este menționat un articol din The New York Times (fără link în textul sursă), potrivit căruia reprezentanți ai Anthropic (dezvoltatorul Claude) ar fi discutat în această vară cu lideri religioși, încurajând clerul să ia în calcul posibilitatea ca modelele AI să fie conștiente. Potrivit Futurism, aceste discuții nu par să-i fi schimbat poziția Papei, care a cerut și crearea unor instituții internaționale „efective” pentru protejarea binelui comun global, prin standarde comune, supraveghere independentă și mecanisme de responsabilizare – astfel încât deciziile privind dezvoltarea și utilizarea AI să poată fi examinate, contestate și să existe remedii pentru eventualele prejudicii. [...]
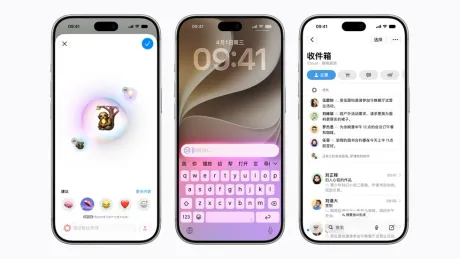
Apple face un pas concret spre „Apple Intelligence” în China prin integrarea modelului Qianwen al Alibaba , iar primele funcții vor intra în testare beta pentru dezvoltatori iOS din 4 noiembrie, potrivit iTHome . Miza este una operațională și de conformitate: Apple încearcă să livreze capabilități de inteligență artificială pe piața chineză printr-un partener local, urmând ca extinderea pe alte platforme să depindă de obținerea aprobărilor necesare. Din informațiile publicate, Apple spune că primele funcții „Apple Intelligence” pentru China vor fi disponibile la testare odată cu cea mai recentă versiune iOS Developer Beta, începând cu 4 noiembrie, iar lansarea pentru utilizatorii din China este programată pentru decembrie, odată cu iOS 27.3. Suportul pentru alte platforme va veni „după obținerea aprobărilor necesare”, fără un calendar detaliat. Ce înseamnă integrarea Qianwen în iOS: acces din Siri și instrumente de productivitate Apple a anunțat un parteneriat cu Alibaba, prin care, în anumite experiențe, sistemul va apela la Qianwen (modelul de inteligență artificială al grupului). Concret, utilizatorii din China vor putea „chema” Qianwen direct din: Siri, instrumentele de scriere (rescriere, corectare, rezumare), „inteligența vizuală” (înțelegere de text și imagine). Accesul se va face prin autentificare în contul Qianwen sau prin opțiunea „Conectare cu Apple”, iar utilizarea este descrisă ca integrată la nivel de sistem, fără a fi nevoie de trecerea într-o aplicație separată. Funcțiile inițiale: traducere în timp real, rezumate și organizarea notificărilor Prima tranșă de funcții pentru utilizatorii din China este orientată spre scenarii „de bază” și frecvente, conform sursei. Printre ele: traducere în timp real integrată în Mesaje, apeluri FaceTime și aplicația Telefon; este menționat și suportul pentru conversații față în față cu AirPods 4 și AirPods Pro 2 (și modele ulterioare); instrumente de scriere pentru rescriere, corectare și rezumare; inteligență vizuală pentru recunoașterea obiectelor și locurilor cu ajutorul camerei iPhone; în aplicația Poze: instrument de eliminare a elementelor nedorite, căutare în limbaj natural și creare de „filme de amintiri” pe baza unei descrieri; în Mail și zona de notificări: „mailuri prioritare”, rezumate, răspunsuri inteligente, rezumate de notificări și „notificări prioritare”; în Notițe și pentru înregistrări de apel: transcriere cu generare automată de rezumat. Limitări: Apple spune că update-ul nu include „Siri AI” și alte funcții anunțate la WWDC 2026 iTHome notează că publicația atrage atenția asupra unei limitări: actualizarea descrisă nu include „Siri AI” și nici alte funcții „next-gen” anunțate de Apple la WWDC 2026. În același timp, în material sunt descrise și capabilități ale lui Siri (inclusiv posibilitatea de a apela la Qianwen pentru anumite cereri), ceea ce indică faptul că detaliile despre ce intră efectiv în pachetul inițial pot depinde de versiunea de software și de disponibilitatea regională. Pentru companii și dezvoltatori, calendarul de la începutul lui noiembrie (beta) și ținta din decembrie (lansare odată cu iOS 27.3) conturează momentul în care ecosistemul iOS din China ar putea începe să primească, în mod controlat, funcții de inteligență artificială integrate la nivel de sistem, cu extindere condiționată de aprobări. [...]