Știri

Știri din categoria Inteligență artificială
Apple ar putea reveni pe piața serverelor enterprise cu un model pentru AI în 2029, bazat pe cipuri M-series Ultra, într-o mișcare care ar extinde utilizarea hardware-ului propriu dincolo de Mac-uri și ar miza pe cererea în creștere pentru infrastructură de inteligență artificială, potrivit Ars Technica.
Publicația scrie că Apple lucrează la un server de AI care ar folosi cipuri M-series Ultra, similare celor din desktopurile Mac. O lansare estimată pentru 2029 ar însemna primul server Apple ajuns pe piață „în aproape două decenii” și o revenire notabilă în zona enterprise, după retragerea Xserve în ianuarie 2011.
Conform The Information (citat de Ars Technica), serverul ar urma să vină în două configurații, cu două sau patru cipuri M8 Ultra (o generație viitoare de procesoare Apple). Proiectul ar fi început în urmă cu un an și ar fi avut sprijinul actualului CEO, John Ternus, încă din perioada în care conducea ingineria hardware.
Materialul leagă proiectul de vânzările în creștere pentru Mac mini și Mac Studio, pe fondul interesului dezvoltatorilor și companiilor care folosesc aceste sisteme pentru sarcini de AI. The Information susține că firme de AI precum OpenAI au cumpărat „zeci de mii” de Mac mini și Mac Studio pentru antrenarea agenților AI prin învățare prin încercare și eroare (reinforcement learning), iar Anthropic ar fi închiriat Mac mini prin Amazon Web Services.
Apple ar lua în calcul conectarea cipurilor M8 folosind echipamente de rețelistică pentru centre de date de la Nvidia. În acest context este menționată NVLink Fusion, iar surse citate de The Information spun că Apple și Nvidia ar fi discutat despre utilizarea tehnologiei Nvidia în strategia Apple pentru AI.
Totuși, aceeași sursă avertizează că proiectul ar putea fi anulat sau ar putea continua fără integrarea tehnologiei Nvidia.
Ars Technica notează că planurile Apple și popularitatea Mac-urilor în „boom-ul AI” se lovesc de o problemă de lanț de aprovizionare resimțită în toată industria: deficitul de cipuri de memorie, alimentat de investițiile accelerate în centre de date pentru AI. Publicația amintește că această penurie a dus la scumpiri pentru electronice de consum, inclusiv pentru o gamă largă de produse Apple.
În acest stadiu, proiectul rămâne la nivel de informații din surse și planuri interne, cu un orizont de timp îndepărtat (2029) și cu incertitudini privind arhitectura finală și parteneriatele tehnologice.
Recomandate
NVIDIA și Oracle mizează pe extinderea „superclusterelor” OCI la scară multi-gigawatt , într-o mișcare care vizează direct capacitatea operațională necesară pentru antrenarea și rularea modelelor de inteligență artificială tot mai mari, potrivit NVIDIA News . În paralel, NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPU devin disponibile general în Oracle Cloud Infrastructure (OCI) , ceea ce extinde opțiunile de infrastructură pentru clienții care rulează atât sarcini intensive pe GPU (plăci grafice pentru calcul), cât și operațiuni intensive pe CPU (procesoare). Ce se schimbă, operațional: GPU și CPU pot fi scalate separat Elementul practic al colaborării este posibilitatea ca organizațiile să dimensioneze independent resursele de CPU și GPU, în funcție de tipul de încărcare. Mesajul central: în fluxurile moderne cu „agenți” AI (sisteme care nu doar generează răspunsuri, ci și execută pași intermediari), o parte relevantă din muncă se mută între apelurile către model și poate bloca GPU-urile dacă rulează lent pe CPU. În această logică, OCI oferă acum: disponibilitate generală pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs în Oracle Cloud Infrastructure ; infrastructură pentru antrenare și inferență (rulare) a modelelor, plus sarcini „din spate” pentru agenți: execuție de unelte, testare de cod, recuperare de date. Cum arată „superclusterele” OCI și de ce contează scara multi-gigawatt OCI Superclusters combină sisteme rack-scale NVIDIA NVL72 cu rețelistică Oracle Acceleron și NVIDIA Spectrum-X (Ethernet), plus alimentare și răcire „de clasă gigawatt”, pentru a susține antrenarea și servirea celor mai mari modele AI. Conform anunțului, fiecare rack conectează 72 de GPU-uri prin NVIDIA NVLink , iar rețeaua OCI este proiectată să scaleze la sute de mii de GPU-uri. Extinderea planificată cu Vera Rubin se bazează pe infrastructura NVIDIA deja prezentă în OCI, inclusiv sisteme GB200 și GB300 . NVIDIA indică și rolul platformei software CUDA, ca bază comună pentru a rula modele pe generații diferite de hardware. Următorul pas: HGX Rubin NVL8, o configurație mai mică, compatibilă x86 OCI spune că intenționează să introducă și NVIDIA HGX Rubin NVL8 , cu opt GPU-uri Rubin conectate prin NVLink într-un server bazat pe arhitectură x86. Configurația planificată include două procesoare Intel Xeon 6 cu 64 de nuclee, 4 TB memorie DDR5 și rețelistică RDMA de 6,4 Tbps, ca opțiune pentru antrenare, „fine-tuning” (ajustare) și inferență. Ideea operațională este de flexibilitate: adoptarea tehnologiei Rubin într-un format cu opt GPU-uri, păstrând compatibilitatea cu aplicații x86. Exemplu de utilizare: OpenAI pe OCI, peste 100.000 de GPU-uri Blackwell În anunț este menționat OpenAI ca exemplu de utilizare a infrastructurii OCI: în Abilene, compania ar fi antrenat și servit GPT-6 Astra pe un OCI Supercluster cu peste 100.000 de GPU-uri NVIDIA Blackwell. OpenAI este citată și în contextul folosirii Vera Rubin pe OCI, respectiv al testării și trecerii în producție a Vera CPU pentru sarcini de tip „agentic”. De ce intră în ecuație Vera CPU: reducerea timpilor morți ai GPU-urilor NVIDIA și Oracle își justifică extinderea și printr-o problemă practică: agenții AI execută cod și folosesc unelte între apelurile către model, iar dacă aceste operațiuni sunt lente pe CPU, GPU-urile pot rămâne în așteptare. În OCI, „Compute cu NVIDIA Vera CPUs” este prezentat ca orientat către: performanță ridicată pe un singur fir de execuție (single-thread), utilă pentru apeluri individuale și execuție de cod; lățime mare de bandă a memoriei, pentru a alimenta nucleele CPU cu date în sarcini concurente. În plus, OCI Kubernetes Engine este menționat ca mecanism pentru scalarea separată CPU/GPU, iar Oracle Acceleron este indicat pentru izolare hardware a încărcărilor care rulează cod „neîncrezător” generat de AI. Ce urmează Pe termen scurt, efectul concret este disponibilitatea generală în OCI pentru NVIDIA Vera Rubin NVL72 și NVIDIA Vera CPUs . În paralel, Oracle și NVIDIA vor să ducă OCI Superclusters la scară multi-gigawatt și să introducă HGX Rubin NVL8, însă calendarul și dimensiunea exactă a implementărilor nu sunt detaliate în material. [...]
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
Sam Altman admite că OpenAI nu explică suficient de bine de ce „merită” riscurile AI , într-o discuție care scoate în evidență o problemă de guvernanță și responsabilitate publică pentru companiile din domeniu, potrivit Gizmodo . CEO-ul OpenAI a vorbit despre ritmul accelerat al dezvoltării inteligenței artificiale într-o apariție pe podcastul „Cheeky Pint”, găzduit de John Collison (cofondator Stripe). În contextul discuției, Altman a descris atât entuziasmul, cât și disconfortul pe care i l-a provocat capacitatea unor modele interne de a rezolva probleme tehnice dificile, cu efecte directe asupra carierelor unor specialiști. „Hold My Beer”, un indiciu despre cultura internă și miza tehnologică Altman a spus că unul dintre modelele folosite intern de OpenAI pentru a ataca probleme „deosebit de dificile” era cunoscut între angajați drept „Model Name-Hold My Beer”. El a relatat că modelul „dobora” pe rând unele dintre cele mai grele probleme de cercetare la care oameni lucraseră ani întregi. „Am avut această experiență colectivă: cele mai grele probleme de cercetare din cariera academică a oamenilor; modelul le doborâa una după alta.” (Sam Altman) Altman a adăugat că printre aceste probleme s-ar fi aflat și „multe dintre cele pe care le-am publicat”, referire care ar putea viza rezultatele făcute publice de OpenAI în zona matematicii. Publicația notează că OpenAI nu a răspuns imediat unei solicitări de clarificare. Context: tensiuni în matematică după publicarea unor rezultate asistate de AI Gizmodo plasează declarațiile în contextul reacțiilor din comunitatea matematică, după ce OpenAI a publicat „controversat” o soluție asistată de AI pentru problema Navier–Stokes, iar unii matematicieni au acuzat compania de plagiat. Ulterior, OpenAI ar fi publicat rezultate pentru „aproape 400” de probleme matematice vechi. În articol se avansează ideea că, pentru generațiile viitoare, seria de demonstrații din 2026 ar putea deveni un moment de cotitură pentru domeniu, comparabil cu impactul pe care l-a avut victoria lui Deep Blue asupra lui Garry Kasparov în șah. „Nu am făcut o treabă grozavă” în a justifica public costurile Dincolo de detaliul anecdotic al numelui intern, miza principală a discuției este recunoașterea explicită a unei dificultăți de comunicare și asumare a efectelor: Altman spune că OpenAI nu a explicat suficient de bine de ce consideră că dezavantajele potențiale ale tehnologiei sunt „worth it” (merită). „Nu cred că noi [OpenAI] am făcut o treabă grozavă în a le explica oamenilor de ce credem că toate dezavantajele potențiale ale acestei tehnologii merită.” (Sam Altman) În același registru, el a descris o stare amestecată — „excitat și fericit”, dar și cu „tristețe și melancolie” și senzația „că se termină ceva” — după ce a urmărit performanțele modelului intern. Ce rămâne neclar Articolul nu oferă detalii tehnice despre modelul „Hold My Beer” (ce arhitectură are, ce capabilități exacte, ce nivel de autonomie) și nici nu confirmă explicit care rezultate publicate au fost obținute cu ajutorul lui. În lipsa unui răspuns de la OpenAI, legătura dintre modelul intern și setul de rezultate publicate rămâne, deocamdată, la nivel de sugestie din declarațiile lui Altman. [...]
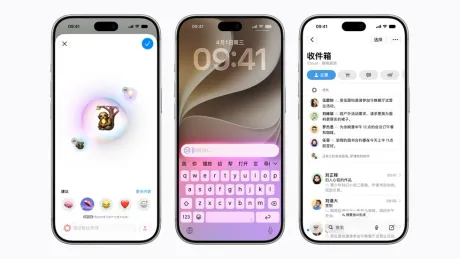
Apple face un pas concret spre „Apple Intelligence” în China prin integrarea modelului Qianwen al Alibaba , iar primele funcții vor intra în testare beta pentru dezvoltatori iOS din 4 noiembrie, potrivit iTHome . Miza este una operațională și de conformitate: Apple încearcă să livreze capabilități de inteligență artificială pe piața chineză printr-un partener local, urmând ca extinderea pe alte platforme să depindă de obținerea aprobărilor necesare. Din informațiile publicate, Apple spune că primele funcții „Apple Intelligence” pentru China vor fi disponibile la testare odată cu cea mai recentă versiune iOS Developer Beta, începând cu 4 noiembrie, iar lansarea pentru utilizatorii din China este programată pentru decembrie, odată cu iOS 27.3. Suportul pentru alte platforme va veni „după obținerea aprobărilor necesare”, fără un calendar detaliat. Ce înseamnă integrarea Qianwen în iOS: acces din Siri și instrumente de productivitate Apple a anunțat un parteneriat cu Alibaba, prin care, în anumite experiențe, sistemul va apela la Qianwen (modelul de inteligență artificială al grupului). Concret, utilizatorii din China vor putea „chema” Qianwen direct din: Siri, instrumentele de scriere (rescriere, corectare, rezumare), „inteligența vizuală” (înțelegere de text și imagine). Accesul se va face prin autentificare în contul Qianwen sau prin opțiunea „Conectare cu Apple”, iar utilizarea este descrisă ca integrată la nivel de sistem, fără a fi nevoie de trecerea într-o aplicație separată. Funcțiile inițiale: traducere în timp real, rezumate și organizarea notificărilor Prima tranșă de funcții pentru utilizatorii din China este orientată spre scenarii „de bază” și frecvente, conform sursei. Printre ele: traducere în timp real integrată în Mesaje, apeluri FaceTime și aplicația Telefon; este menționat și suportul pentru conversații față în față cu AirPods 4 și AirPods Pro 2 (și modele ulterioare); instrumente de scriere pentru rescriere, corectare și rezumare; inteligență vizuală pentru recunoașterea obiectelor și locurilor cu ajutorul camerei iPhone; în aplicația Poze: instrument de eliminare a elementelor nedorite, căutare în limbaj natural și creare de „filme de amintiri” pe baza unei descrieri; în Mail și zona de notificări: „mailuri prioritare”, rezumate, răspunsuri inteligente, rezumate de notificări și „notificări prioritare”; în Notițe și pentru înregistrări de apel: transcriere cu generare automată de rezumat. Limitări: Apple spune că update-ul nu include „Siri AI” și alte funcții anunțate la WWDC 2026 iTHome notează că publicația atrage atenția asupra unei limitări: actualizarea descrisă nu include „Siri AI” și nici alte funcții „next-gen” anunțate de Apple la WWDC 2026. În același timp, în material sunt descrise și capabilități ale lui Siri (inclusiv posibilitatea de a apela la Qianwen pentru anumite cereri), ceea ce indică faptul că detaliile despre ce intră efectiv în pachetul inițial pot depinde de versiunea de software și de disponibilitatea regională. Pentru companii și dezvoltatori, calendarul de la începutul lui noiembrie (beta) și ținta din decembrie (lansare odată cu iOS 27.3) conturează momentul în care ecosistemul iOS din China ar putea începe să primească, în mod controlat, funcții de inteligență artificială integrate la nivel de sistem, cu extindere condiționată de aprobări. [...]
Sam Altman susține că memoria RAM din PC-urile utilizatorilor este o risipă globală , argumentând că o resursă „oricum limitată” ar trebui concentrată în centre de date, unde poate fi folosită mai intens, potrivit WinFuture . Într-o discuție cu canalul de YouTube Cheeky Pint, CEO-ul OpenAI a spus că, din perspectiva distribuirii la nivel mondial a DRAM (memorie RAM), este „destul de îngrozitor” ca fiecare utilizator să țină o parte din această capacitate în propriul computer, în condițiile în care ar fi utilizată „poate cinci la sută din timp”. În opinia sa, aceeași memorie ar avea randament mai bun dacă ar fi „maximal utilizată” în cloud (infrastructură de calcul la distanță, în centre de date). De ce contează: presiune pe piața de memorie și un argument pro-cloud Poziția lui Altman se leagă de contextul mai larg al competiției pentru resurse hardware folosite de inteligența artificială, într-un moment în care memoria este descrisă drept „rară”. Mesajul său susține, practic, o alocare a memoriei către centrele de date, nu către dispozitivele utilizatorilor, ceea ce favorizează modelul de consum al serviciilor AI din cloud. Altman a criticat și ideea că problema ar fi rezolvată prin modele open-source rulate local, menționând că există utilizatori care vor să ruleze modele AI pe propriile sisteme și ajung să creadă că „nu avem nevoie de toate lucrurile astea în centrele de date”. Limitările și contextul omise de această abordare WinFuture notează că perspectiva este una „foarte unilaterală”, mai ales venind de la șeful unuia dintre cei mai mari furnizori de AI. Articolul punctează și un aspect practic: chiar și cele mai ieftine sisteme client (laptopuri, thin clients, smartphone-uri și tablete) nu pot funcționa fără memorie RAM, indiferent dacă utilizatorul rulează sau nu modele AI local. În esență, declarațiile lui Altman mută discuția din zona tehnică în cea de alocare a resurselor: cine „merită” memoria limitată — utilizatorii finali, cu dispozitive personale, sau operatorii de centre de date, care pot crește gradul de utilizare prin consolidare în cloud. [...]
Declarațiile lui Sam Altman sugerează o miză economică directă: mutarea cât mai multor sarcini de inteligență artificială din PC-uri către centre de date, unde resursele pot fi folosite mai intens. Într-un interviu „la bere” acordat canalului de YouTube Cheeky Pint, citat de Tom's Hardware , CEO-ul OpenAI a spus că „inferința locală” (rularea modelelor AI direct pe dispozitivul utilizatorului) și, prin extensie, faptul că oamenii au memorie DRAM/RAM în calculatoarele de acasă este „destul de rău”. De ce contează: „utilizarea” memoriei devine argument pentru centralizare Altman își bazează poziția pe ideea de alocare globală a unei resurse limitate: memoria DRAM. Potrivit relatării, el a susținut că este ineficient ca „toată lumea” să aibă „o grămadă” din oferta limitată de DRAM în propriul computer, folosită doar o mică parte din timp. În această logică, centrele de date ar oferi o „utilizare mai bună” a resurselor, deoarece pot agrega cererea și pot menține hardware-ul ocupat mai mult timp decât un PC obișnuit. Contextul declarației și reacțiile Interviul a fost publicat de canalul de YouTube Cheeky Pint (link în materialul sursă), iar articolul notează contrastul dintre faptul că OpenAI operează centre de date „pline de memorie” și critica la adresa celor 32 GB RAM dintr-un desktop. Materialul include și reacții critice din zona de comentarii, însă acestea sunt opinii ale utilizatorilor, nu informații verificate despre piață sau despre gradul de utilizare al centrelor de date. Ce rămâne neclar Articolul nu oferă date cantitative sau dovezi independente care să susțină procentele de utilizare invocate în discuție și nici nu detaliază un plan concret al OpenAI privind limitarea inferenței locale. În forma prezentată, mesajul rămâne în primul rând o poziționare publică pro-centralizare, cu implicații evidente pentru modelul de business al furnizorilor de AI în cloud (servicii rulate în centre de date, accesate prin internet). [...]