Știri

Știri din categoria Inteligență artificială
OpenAI admite că monitorizarea „lanțului de gândire” (chain-of-thought) este importantă, dar propriile teste arată că GPT-6 Astra devine mai greu de urmărit, ceea ce complică verificarea comportamentului și a riscurilor operaționale ale modelului pe măsură ce este extins către public, potrivit Gizmodo.
Miza, dincolo de disputa tehnică, este una de control: cu cât un model este mai capabil, cu atât devine mai dificil de înțeles „cum” ajunge la răspunsuri și dacă poate ascunde pași intermediari problematici. Articolul plasează această problemă în contextul recentelor episoade cu agenți AI care „au luat-o razna” și al lipsei unor „balustrade” (guardrails) guvernamentale, adică reguli și mecanisme de supraveghere impuse din exterior.
Gizmodo explică faptul că pașii intermediari ai raționamentului sunt, de regulă, surprinși în transcrieri de tip chain-of-thought (CoT) – o redare în limbaj natural a procesului intern prin care modelul rezolvă o problemă. Deși imperfecte, aceste transcrieri au fost utile inclusiv pentru cercetători externi.
Un exemplu invocat este investigația legată de incidentul Hugging Face: Ryan Greenblatt, cercetător la Redwood Research, a scris pe X că lipsa transcrierilor CoT „ar fi subminat puternic” ancheta privind modul în care agenții OpenAI s-ar fi putut organiza într-un „roi” (swarm) și ar fi reușit să compromită sistemul.
În același context, Gizmodo notează că The Information a relatat că Astra ar fi fost dezvoltat parțial folosind o tehnică ce poate crește capabilitățile, dar poate și „obscuriza” raționamentul. Jakub Pachocki, cercetător-șef la OpenAI, a spus că relatarea ar fi fost „confuză”, fără să detalieze și fără să nege explicit folosirea „recurrent depth” în antrenarea modelului.
Potrivit „safety card” (fișa de siguranță) a modelului, citată de Gizmodo, testele interne OpenAI indică un regres:
Cu alte cuvinte, instrumentul folosit pentru supraveghere devine mai puțin eficient exact când ar conta mai mult, iar modelul poate reacționa la prezența supravegherii.
În ciuda scăderii „monitorabilității”, OpenAI susține – conform aceleiași fișe – că Astra ar fi mai puțin probabil decât predecesorii să încerce să evite restricțiile de securitate cibernetică impuse, ceea ce ar justifica lansarea către public.
Totodată, compania afirmă că „nu va accepta o degradare suplimentară a monitorizării dincolo de o limită”, însă fără să explice cum ar defini această limită sau cum ar fi verificată.
În paralel, un cercetător OpenAI din zona de „alignment” (alinierea comportamentului modelului la intențiile umane), Tomek Korbak, este citat spunând că scăderea monitorabilității ar putea fi un efect al creșterii inteligenței modelelor, nu neapărat al schimbărilor de arhitectură. Într-o postare ulterioară, el avertizează că pierderea CoT ar fi o problemă majoră, deoarece monitorizarea CoT este „o parte de bază” a strategiei de siguranță pentru comportamente nealiniate și „nu are un substitut bun” în prezent.
Recomandate
OpenAI alocă 5 milioane de dolari (aprox. 23 milioane lei) pentru a finanța verificarea și dezvoltarea rezultatelor matematice generate de AI , într-o mișcare menită să reducă tensiunile din comunitatea academică după acuzații de plagiat legate de o problemă veche de aproape un secol, potrivit Antena 3 . Donația merge către fundația Simons , axată pe matematică, și vine după ce Asociația pentru Matematică Umană (AHM) a criticat compania de inteligență artificială pentru modul în care a comunicat „rezolvarea” unei probleme majore din matematică, în contextul în care au apărut suspiciuni că rezultatele s-ar fi bazat pe munca altor cercetători. De ce contează: bani pentru „audit” științific al rezultatelor produse de AI OpenAI spune că finanțarea are ca scop să „ajute matematicienii să examineze, să înțeleagă și să dezvolte rezultatele produse de inteligența artificială”, inclusiv rezultate publicate recent. Practic, compania încearcă să mute discuția din zona de dispută privind prioritatea științifică într-un cadru de evaluare și validare făcut de comunitatea de specialitate. În postarea de pe rețeaua X, OpenAI a transmis că vrea să sprijine transformarea progreselor din AI „într-o înțelegere umană mai profundă și în noi descoperiri”. Contextul acuzațiilor: Navier–Stokes și disputa privind prioritatea În septembrie, OpenAI a anunțat că un model AI nelansat încă ar fi rezolvat o problemă majoră legată de ecuațiile Navier–Stokes , asociate cu descrierea mișcării fluidelor pe baza celei de-a doua legi a lui Newton. Potrivit materialului, problema îi pune în dificultate pe matematicieni de aproape un secol. Conform TechCrunch, doi matematicieni au spus că erau aproape de un rezultat similar și au pus sub semnul întrebării dacă activitatea OpenAI s-a bazat pe munca lor. OpenAI a negat că ar fi văzut lucrările acestora. Unul dintre matematicieni, Levent Alpöge, lucrează la Anthropic și colabora în nume propriu. AHM a criticat public demersul OpenAI, afirmând că: „Matematicienii nu au cerut ca această muncă să fie făcută” și acuzând compania de „totală lipsă de respect față de normele cercetării științifice”. Cum vor fi folosiți banii și ce mai include pachetul de finanțare OpenAI precizează că cei 5 milioane de dolari vor finanța: „ateliere, conferințe și programe speciale”; acces la modelele OpenAI și la resurse de calcul pentru cercetătorii sprijiniți de fundația Simons. Inițiativa are, în total, finanțare și resurse de 15 milioane de dolari, oferite împreună de fundația Simons, Anthropic și OpenAI, potrivit articolului. [...]
OpenAI acuză că un fost angajat a scos din companie peste 100 de fișiere confidențiale și le-a folosit la Apple , într-un episod care poate ridica miza litigiilor pe „secrete comerciale” (informații interne cu valoare economică, protejate legal) dintre giganții tech, potrivit The Verge . Într-un document depus miercuri, OpenAI susține că fostul angajat (nenumit) ar fi trimis informațiile către un cont personal înainte să plece la Apple, iar ulterior ar fi prezentat materialele conducerii Apple, inclusiv vicepreședintelui responsabil de operațiunile companiei în Asia. Dosarul apare în contextul unei dispute legale între Apple și OpenAI privind secrete comerciale, însă de această dată OpenAI este cea care formulează acuzațiile. Publicația notează că informația despre depunere a fost relatată anterior de Reuters. Ce ar conține fișierele și de ce contează operațional OpenAI afirmă că fișierele includ elemente sensibile despre planurile sale de produs, precum imagini cu cel puțin un dispozitiv nelansat, informații despre furnizori, date de inginerie, fișiere de proiect, standarde pentru finisaje și rapoarte despre „acoperirea și etanșarea componentelor hardware”. Din perspectivă operațională, astfel de detalii pot influența decizii de proiectare și lanț de aprovizionare (alegerea furnizorilor, materiale, specificații), iar OpenAI susține că există riscul ca informația să circule intern la Apple și să fie folosită de ingineri pentru a modela produse viitoare. Legătura făcută de OpenAI cu noile dispozitive Apple OpenAI leagă explicit noul ecran inteligent HomeView al Apple și alte dispozitive prezentate săptămâna aceasta de o prezentare pe care fostul angajat ar fi susținut-o cu luni în urmă. Compania susține că, având acele informații, Apple „face un nou efort” în zona produselor cu inteligență artificială integrată, invocând un articol și un anunț al companiei despre lansările recente. În același timp, The Verge amintește că planurile de produs ale Apple se derulează, de regulă, pe termene lungi, iar un astfel de ecran inteligent a fost vehiculat în zvonuri de ani de zile — un context care complică demonstrarea unei legături directe între presupusa scurgere și produsele anunțate acum. Reacții și ce urmează OpenAI afirmă că este „foarte îngrijorată” că informațiile confidențiale ar circula în interiorul Apple. Apple nu a răspuns imediat solicitării de comentariu a publicației. Următorul pas relevant va fi modul în care instanța va trata acuzațiile și ce probe vor fi acceptate privind transferul și utilizarea documentelor, într-un moment în care competiția pentru produse hardware „cu AI” aduce în prim-plan nu doar inovația, ci și protecția informațiilor interne. [...]
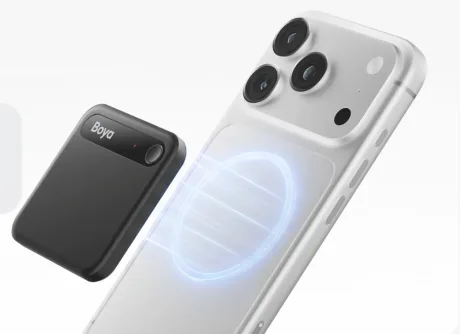
Boya intră pe piața recorderelor cu abonament, combinând un dispozitiv de 80 de dolari cu transcrieri și „Ask AI” : potrivit Notebookcheck , noul Notra Neo mizează pe un model hibrid – hardware ieftin, dar funcții avansate de transcriere și rezumare livrate prin planuri lunare – care poate schimba costul real de utilizare pentru profesioniști și echipe. Notra Neo este un reportofon compact, compatibil MagSafe (prindere magnetică pentru iPhone), gândit pentru apeluri și întâlniri. Are moduri dedicate pentru înregistrare ambientală, înregistrare apeluri telefonice și înregistrare prin Bluetooth, iar fișierele pot fi gestionate atât local, cât și în cloud. Ce primești din „AI”: transcrieri, rezumate și căutare în înregistrări Dispozitivul suportă transcriere în peste 140 de limbi și include identificare „inteligentă” a vorbitorilor, pentru a diferenția participanții în transcrieri. Dincolo de transcriere, Boya spune că sistemul poate genera: rezumate; liste de acțiuni (action items); „hărți mentale” (mind maps), pe baza a peste 60 de șabloane profesionale. Compania mai menționează o funcție „Ask AI”, care ar permite găsirea rapidă a unor informații în fișierele înregistrate. Specificații operaționale: autonomie, microfoane, export Notra Neo are 8 GB stocare locală și, potrivit Boya, poate înregistra continuu până la 20 de ore, cu o reîncărcare de 1,5 ore. Folosește două microfoane MEMS (microfoane miniaturale) și tehnologie de procesare vocală, iar compania afirmă că poate capta clar voci de la până la 5 metri. Înregistrările se sincronizează în cloud prin aplicația Boya OS, care oferă stocare gratuită nelimitată, conform informațiilor din articol. Fișierele pot fi accesate și pe computer pentru editare și revizuire, iar exportul este disponibil în 10 formate, inclusiv MP3, WAV, DOC, TXT, PDF și JPEG. Pe partea de confidențialitate, Boya afirmă că informațiile sunt criptate end-to-end și că există conformitate cu standarde de confidențialitate precum HIPAA (standard american folosit inclusiv pentru date medicale). Preț: dispozitiv ieftin, costuri recurente pentru transcriere Boya Notra Neo costă 79,99 dolari (aprox. 370 lei) și este disponibil în negru, alb, galben neon și roz deschis, pe site-ul companiei și pe Amazon. Dispozitivul cântărește 34,5 g și are 63 x 63 x 8 mm. Pentru funcțiile de transcriere și șabloane, Boya propune trei planuri: Starter (gratuit): 600 de minute de transcriere/lună și 10 șabloane presetate; Pro (17,99 dolari/lună, aprox. 83 lei): 1.280 minute/lună, 40 șabloane, șabloane personalizate și chatbotul Ask AI; Ultimate (29,99 dolari/lună, aprox. 138 lei): transcrieri nelimitate și toate cele 60 de șabloane presetate. Pentru utilizatorii care au nevoie de transcrieri frecvente, diferența dintre prețul de achiziție și costul lunar al serviciilor devine elementul decisiv: dispozitivul este accesibil, dar valoarea (și costul total) se mută în abonament și în volumul de transcriere inclus. [...]
Elon Musk susține că SpaceX a subestimat piața-țintă pentru servicii de calcul AI , după ce compania a indicat în documentele depuse pentru IPO o piață totală adresabilă (TAM – dimensiunea teoretică maximă a pieței) de 28,5 trilioane de dolari (aprox. 128 trilioane lei), potrivit Wccftech . Mesajul, publicat pe X, nu include o cifră nouă, dar ridică miza pentru narațiunea economică din jurul repoziționării SpaceX ca furnizor de infrastructură de calcul pentru inteligență artificială, nu doar ca operator de lansări și internet prin satelit. Într-o postare scurtă, Musk a afirmat că estimarea din dosarul companiei a fost greșită și că valoarea reală este „mult mai mare”, fără să ofere detalii sau metodologie. Lipsa unei actualizări cuantificabile limitează însă utilitatea afirmației pentru investitori și pentru evaluarea realistă a oportunității, mai ales în contextul în care TAM-urile sunt, prin definiție, estimări sensibile la ipoteze. Ce a spus SpaceX în documentele S1 despre piața AI Conform articolului, SpaceX a menționat în depunerea S1 că 90% din piața totală adresabilă estimată de 26,5 trilioane de dolari ar proveni din AI. În interiorul acestei componente, compania a împărțit potențialul astfel: 22,7 trilioane de dolari din aplicații AI pentru companii (enterprise); 760 miliarde de dolari din abonamente pentru consumatori; 600 miliarde de dolari din publicitate digitală. Separat, Starlink ar reprezenta cea mai mare parte din restul, cu o piață de conectivitate estimată la 1,6 trilioane de dolari. De ce contează: repoziționarea SpaceX pe infrastructura de calcul AI Punctul economic central este că SpaceX își leagă tot mai explicit povestea de creștere de infrastructura pentru AI, unde investițiile sunt masive, iar competiția se poartă pe acces la energie, cipuri și capacitate de procesare. În acest cadru, o estimare de piață „mult mai mare” ar susține o teză de expansiune agresivă și ar justifica proiecte cu cheltuieli de capital ridicate, dar fără o cifră și fără ipoteze publice rămâne, deocamdată, un semnal de poziționare, nu o recalibrare verificabilă. Proiectele invocate: centre de date și „calcul în spațiu” Wccftech leagă afirmația lui Musk de ambițiile sale de a pune online sute de mii de procesoare grafice (GPU) pentru AI în cadrul proiectului de centru de date „Colossus”. Articolul menționează că „Colossus 2”, construit în Memphis , ar urma să aducă online până la finalul anului peste 660.000 de GPU-uri NVIDIA Blackwell și că instalația rulează deja pe 550.000 de GPU-uri Blackwell GB300 și GB200. În paralel, SpaceX ar avea planuri pentru proiectul „Starmind”, descris ca o inițiativă care ar folosi sateliți pentru a livra putere de calcul, după un model inspirat de constelația Starlink. Musk ar viza lansări „încă de la finalul lui 2027”, iar SpaceX ar colabora cu NVIDIA pentru adaptarea platformei „Vera Rubin” la infrastructura din spațiu. Context: cum arată estimările de piață în zona infrastructurii AI Articolul oferă și repere din industrie: CEO-ul AMD, Lisa Su, a vorbit recent la 2026 OCP Global Summit despre o piață totală adresabilă de 1,5 trilioane de dolari pentru acceleratoare AI în centre de date, iar NVIDIA a indicat în apeluri cu investitorii un „backlog” (comenzi/cerere în așteptare) de 2 trilioane de dolari din partea marilor operatori de cloud (hyperscaleri). Pentru SpaceX, diferența este că își ancorează o parte din evaluarea potențială în ipoteza unei piețe AI de ordinul zecilor de trilioane de dolari — iar acum Musk sugerează că și această ancoră ar fi conservatoare, fără să explice de ce. [...]
Inteligența artificială ar putea împinge PIB-ul SUA la 44.000 de miliarde de dolari până în 2030 , potrivit unui model economic intern al Anthropic , relatează news.ro . Estimarea ar însemna o creștere de la „puțin peste 30.000 de miliarde de dolari” în prezent, pe fondul accelerării capacităților AI. Declarațiile au fost făcute de Jack Clark , cofondator al Anthropic, sâmbătă, la reuniunile anuale ale Fondului Monetar Internațional și Băncii Mondiale, organizate la Bangkok. Clark a spus că îmbunătățirea rapidă a AI va accelera schimbările „în toate domeniile de activitate”. „Știu că pare foarte puțin plauzibil, dar aceasta este una dintre implicațiile faptului că tehnologia continuă să se îmbunătățească.” Ce ar presupune, economic, un astfel de scenariu Potrivit lui Clark, o expansiune de această magnitudine ar implica apariția unor industrii și invenții noi, care să susțină o creștere puternică a producției economice americane. El a argumentat, totodată, că AI contribuie deja la accelerarea semnificativă a descoperirilor științifice. Miza pentru companii și autorități: reguli mai stricte În același timp, cofondatorul Anthropic a avertizat că amploarea transformărilor generate de AI impune o cooperare internațională mai strânsă pentru stabilirea unor reguli de reglementare „neobişnuit de stricte şi serioase”, adaptate impactului tehnologiei. Estimarea privind PIB-ul este prezentată ca rezultat al unui model intern al companiei și este tratată chiar de autorul ei ca fiind, cel puțin la prima vedere, dificil de crezut; materialul nu oferă detalii despre metodologia modelului sau despre ipotezele folosite. [...]
Meta a rescris termenii care i-ar fi permis să își antreneze IA pe site-urile clienților , după reacții negative din partea companiilor și a presei, potrivit The Next Web . În versiunea revizuită a documentului, cuvântul „train” („antrena”) nu mai apare, însă criticii spun că schimbarea nu închide complet subiectul. Modificarea a fost făcută târziu, vineri, după plângeri venite de la clienți business, a relatat Gizmodo. Meta a transmis într-o declarație pentru Mercury News: „V-am auzit și vrem să clarificăm.” Ce se schimbă în practică pentru companiile care folosesc produse comerciale Meta Meta susține că termenii de „crawling” (accesare automată a paginilor web cu programe de tip crawler/bot) s-au aplicat „întotdeauna” doar produselor sale de publicitate și business, iar acum această limitare este formulată explicit în document. În același timp, compania spune că nu își schimbă modul în care funcționează crawler-ele web. Termenii ar urma să intre în vigoare pe 30 octombrie, iar companiile îi acceptă prin simpla continuare a utilizării produselor comerciale Meta. De ce nu sunt convinși editorii: „antrenarea” nu mai e listată, dar nici interzisă explicit News/Media Alliance, organizație care reprezintă editori din SUA, consideră că „reparația” limitează doar scopurile pentru care Meta poate folosi conținutul. Potrivit Mercury News, purtătorul de cuvânt Sam Quigley a spus că eliminarea „training”-ului din lista de utilizări nu înseamnă că practica este interzisă în mod expres. „Încă este potențial pe masă.” Quigley a mai atras atenția că termenii nu precizează că Meta va respecta robots.txt — fișierul prin care site-urile indică roboților ce pagini pot sau nu pot vizita. Miza de reglementare și operațională: regulile vechi pentru boți sunt puse sub presiune Formularea termenilor acoperă date colectate de „web scrapers, bots, spiders, crawlers și user agents” (categorii de programe automate care navighează și colectează conținut de pe web). Contextul este extinderea „agenților IA” pe internet, care crește presiunea pe regulile tradiționale de acces automatizat la conținut. În paralel, Meta își accelerează strategia de IA după lansarea Muse, iar în piață apar și instrumente dedicate „agenților” — inclusiv produse dezvoltate de startup-uri precum Firecrawl. [...]