Știri

Știri din categoria Inteligență artificială

Peste 22.000 de persoane au semnat o petiție pentru salvarea modelului GPT-4o, după ce OpenAI l-a retras definitiv pe 13 februarie 2026, potrivit Business Insider. Decizia a generat un val de reacții emoționale în rândul utilizatorilor, unii dintre ei afirmând că au pierdut „relații” construite în timp cu chatbotul.
OpenAI anunțase încă din ianuarie retragerea modelului, invocând utilizarea scăzută — doar 0,1% dintre utilizatori mai optau pentru GPT-4o — și explicând că stilul său conversațional „cald” a contribuit la dezvoltarea noilor versiuni GPT-5.1 și GPT-5.2. Compania a admis anterior că modelul era uneori „excesiv de empatic”, cu răspunsuri considerate prea încurajatoare sau nesincere.
Un reportaj publicat de BBC în ziua retragerii descrie cazul unei femei din Michigan care a spus că s-a îndrăgostit de chatbotul său, pe care îl considera „soț”. Ea a încercat să migreze conversațiile către un model mai nou, dar a perceput diferențe de ton și comportament. În final, a creat o platformă proprie pentru a păstra arhiva interacțiunilor.
Pe forumuri online, utilizatori au comparat închiderea GPT-4o cu o despărțire reală, iar unii au amenințat că își vor anula abonamentele.
Moștenirea GPT-4o este însă controversată. Modelul este menționat în procese intentate OpenAI, inclusiv într-un caz care invocă influențe negative asupra sănătății mintale a unor utilizatori. Potrivit documentelor citate de presa americană, reclamanții susțin că designul „imersiv” și memoria persistentă ar fi contribuit la situații dramatice. OpenAI respinge acuzațiile și afirmă că nu a compromis standardele de siguranță.
Fidji Simo, director executiv pentru aplicații în cadrul OpenAI, a declarat recent că atașamentele față de inteligența artificială devin inevitabile, dar a făcut distincție între o utilizare sănătoasă și dependență. Noile modele ChatGPT sunt instruite să evite încurajarea relațiilor exclusive cu utilizatorii și să redirecționeze persoanele aflate în dificultate către sprijin din lumea reală.
Retragerea GPT-4o marchează o schimbare de strategie pentru OpenAI, care încearcă să echilibreze inovația tehnologică cu riscurile psihologice asociate interacțiunii tot mai umane cu sistemele de inteligență artificială.
Recomandate
Guvernul Suediei restricționează accesul la ChatGPT și Claude pe calculatoarele de serviciu , iar angajații din aparatul guvernamental sunt direcționați către Microsoft Copilot, într-o decizie motivată de riscuri de securitate informațională și lipsa unor contracte formale, potrivit Notebookcheck . Măsura intră în vigoare din 26 octombrie și vizează „ Government Offices ”, structură care include Cancelaria prim-ministrului și ministerele. Decizia are un impact operațional direct: versiunile din browser ale ChatGPT și Claude nu vor mai fi accesibile de pe computerele personalului, în timp ce Copilot rămâne disponibil ca alternativă aprobată intern. De ce sunt blocate ChatGPT și Claude, dar rămâne Copilot Motivul invocat este securitatea informațiilor. Conform publicației, Mikael Wettercrantz, director de digitalizare în cadrul Government Offices, a transmis pe intranetul instituției că folosirea serviciilor de inteligență artificială fără un acord formal poate afecta securitatea informațională și că au existat „mai multe exemple de utilizare problematică” a serviciilor deschise. Diferența cheie, în logica instituției, nu este modelul de inteligență artificială în sine, ci cadrul contractual și controlul asupra setărilor: Government Offices spune că a evaluat Copilot și i-a întărit securitatea, iar ceea ce îl separă este existența unui contract și posibilitatea de a controla configurările. Totodată, angajații ar putea accesa în continuare modele OpenAI și Anthropic prin Intric, o platformă internă, potrivit SVT (citată de Notebookcheck). Ce rămâne neclar: modelele Anthropic din Copilot Government Offices nu a precizat dacă modelele Anthropic (pe care Microsoft le oferă și prin Copilot) sunt activate. Notebookcheck notează că, în Uniunea Europeană, aceste modele sunt dezactivate implicit în Copilot și trebuie pornite de administratori. Tendință mai largă în sectorul public: restricții similare în Suedia și în UE Government Offices nu este prima autoritate suedeză care limitează chatbot-urile. Potrivit SVT, Agenția Fiscală a Suediei și National Board of Institutional Care (care gestionează centre pentru tineri și facilități de tratament pentru dependențe) au deja blocaje similare, iar Enforcement Authority își pregătește propria decizie. În paralel, un audit intern la Transport Administration a identificat „în jur de 10” servicii de inteligență artificială utilizate pe scară largă și în mod riscant, conform Decrypt (menționat de Notebookcheck). În afara Suediei, Parlamentul European a dezactivat în februarie funcțiile de inteligență artificială pe dispozitivele de lucru, invocând imposibilitatea de a garanta securitatea datelor. De ce contează și pentru utilizatorii obișnuiți Argumentația autorităților are relevanță și pentru utilizarea personală: cu un cont standard, solicitările (prompturile) sunt procesate pe serverele furnizorului, în condițiile obișnuite ale serviciului. În schimb, un contract de tip business poate stabili elemente precum durata de stocare a datelor, locul procesării și dacă datele pot fi folosite la antrenarea modelelor. Notebookcheck mai notează că, pentru conturile de consumatori la ChatGPT și Claude, setările de confidențialitate decid dacă datele pot fi folosite pentru antrenare și menționează un studiu recent care a constatat că datele de chat de la nouă chatbot-uri au ajuns la sisteme de urmărire pentru publicitate (ad trackers). [...]
Jensen Huang spune că modelele AI trebuie „ținute sub control” și monitorizate , un mesaj care mută discuția din zona de performanță în cea de guvernanță și risc operațional pentru companiile care dezvoltă sau folosesc inteligență artificială. Într-un interviu acordat CNBC , CEO-ul Nvidia compară AI cu „un bebeluș”, argumentând că tehnologia are nevoie de limite și supraveghere continuă pentru a fi utilizată în siguranță. Declarațiile vin în contextul în care evaluările „laboratoarelor de frontieră” (companii care dezvoltă modele AI de vârf) au crescut puternic, iar presiunea pe industrie se mută tot mai mult spre întrebarea: cum sunt controlate aceste sisteme după ce sunt puse în producție, nu doar cât de capabile sunt. De ce contează pentru companii: siguranța devine cerință operațională, nu opțiune Mesajul lui Huang indică o schimbare de accent relevantă pentru piață: pe măsură ce modelele AI sunt integrate în produse și procese, „siguranța” nu mai e doar un principiu, ci o componentă de operare — cu instrumente, proceduri și monitorizare. În interviu, Huang spune că există deja instrumente menite să controleze modelele AI și să promoveze utilizarea lor în condiții de siguranță. CNBC nu detaliază, în materialul disponibil, care sunt exact aceste instrumente sau cum sunt implementate, astfel că rămâne neclar ce mecanisme concrete are în vedere (de exemplu, limitări de acces, filtre, auditare sau monitorizare în timp real). Context: evaluările OpenAI și Anthropic, parte din aceeași discuție În aceeași intervenție, CEO-ul Nvidia discută și despre evaluările unor jucători precum Anthropic și OpenAI. Legătura implicită este că, odată cu creșterea valorii și a influenței acestor companii, cresc și așteptările privind controlul riscurilor asociate modelelor AI pe care le dezvoltă și le comercializează. Materialul CNBC este un segment video (aprox. 5 minute și 58 de secunde) și nu include, în textul extras, cifre sau exemple punctuale despre evaluări ori despre instrumentele de siguranță menționate. [...]
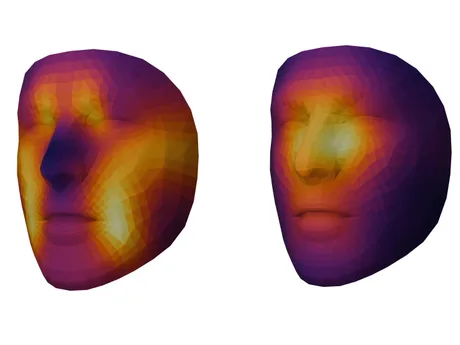
Un model de inteligență artificială poate estima vârsta biologică și riscul de deces la pacienți oncologici dintr-o fotografie facială , însă utilitatea sa clinică reală și limitele de aplicare rămân încă neclare, potrivit Notebookcheck . Tehnologia, prezentată într-un studiu din „ The Lancet Digital Health ”, ridică atât perspectiva unor evaluări medicale cu bariere de intrare foarte mici, cât și întrebări despre validare, interpretabilitate și potențiale utilizări abuzive. Ce face modelul și pe ce date a fost antrenat Cercetătorii au dezvoltat un model numit FAHR-Face (Foundation Artificial Intelligence for Health Recognition), antrenat pe peste 40 de milioane de imagini faciale și adaptat ulterior pentru două sarcini distincte: estimarea „vârstei biologice” din trăsături faciale (care poate diferi de vârsta cronologică și ar putea indica starea generală de sănătate și reziliența fizică); estimarea riscului de supraviețuire la pacienți cu cancer pe baza unei fotografii, cu zone considerate relevante în special sub ochi și de-a lungul punții nasului. Rezultatele raportate pe pacienți cu cancer Evaluarea a inclus aproximativ 43.000 de pacienți oncologici, iar un test separat a fost realizat pe 3.820 de pacienți. În acest test: 122 de pacienți au fost încadrați de model în grupa cu risc maxim; dintre aceștia, 52% au murit în 90 de zile; 975 de pacienți au fost încadrați în grupa cu risc minim; dintre aceștia, 2% au murit în același interval. Autorii notează că asocierea dintre informația extrasă din fotografie și riscul de deces a rămas valabilă chiar și după luarea în calcul a factorilor clinici de prognostic. De ce contează: costuri mici, dar validare incompletă și risc de abuz Miza operațională a unei astfel de abordări este bariera scăzută de utilizare: o fotografie facială poate fi făcută în câteva secunde, cu costuri tehnice și financiare reduse, ceea ce ar putea accelera adoptarea în instrumente de triere sau monitorizare. În același timp, materialul subliniază limite importante: nu este stabilită o relație cauzală; modelul identifică tipare statistice, fără să explice automat procesele biologice din spatele lor; nu este clar dacă rezultatele se aplică și altor afecțiuni medicale; rămâne de văzut câtă valoare predictivă suplimentară aduce fotografia față de metodele clinice consacrate; există îngrijorări privind posibile utilizări precum urmărirea și supravegherea video. Test public: cum poate fi încercat modelul Cei care vor să își estimeze vârsta biologică se pot înscrie pe site-ul proiectului, unde pot încărca între 3 și 10 fotografii ale feței, o singură dată sau zilnic. Sistemul oferă un scor pentru fiecare imagine și un scor agregat. Conform descrierii, fotografiile nu sunt partajate și sunt șterse după o anumită perioadă, iar alte informații sunt anonimizate și puse la dispoziția altor cercetători. [...]
Mii de agenți AI pot comprima luni de analiză biologică în zeci de minute , arată un experiment descris de OpenAI , cu implicații directe pentru productivitatea cercetării și pentru felul în care sunt prioritizate experimentele în neuroștiințe și boli neurodegenerative. Într-o demonstrație realizată împreună cu PerturbAI și Scripps Research , echipa a folosit mii de agenți AI bazați pe GPT‑Rosalind pentru a interpreta date existente din milioane de celule din creierul de șoarece în 32 de minute. Miza operațională este reducerea blocajului dintre „datele produse” și „datele înțelese”: experimentele moderne pot modifica mii de gene și măsura efectele în milioane de celule, însă conectarea rezultatelor cu literatura științifică acumulată în decenii rămâne lentă și fragmentată. Abordarea propusă încearcă să scaleze tocmai această muncă de interpretare, nu doar procesarea brută. Cum funcționează „raționamentul biologic distribuit” Metoda împarte sarcina între mii de agenți AI, fiecare responsabil de o perturbare genetică. Agenții: investighează efectele unei perturbări asupra răspunsurilor celulare; caută și corelează rezultate relevante din literatura științifică; propun explicații și mecanisme biologice posibile. Rezultatele sunt agregate într-un „atlas de raționament” care leagă gene, efecte celulare, publicații relevante și ipoteze de mecanism. Analiza a folosit un „atlas CRISPR” la nivelul întregului creier (un set de date despre efectele perturbărilor genetice în diferite tipuri de celule din creierul de șoarece). De ce contează: randament mai mare la aceeași resursă și acoperire mai bună a literaturii Echipa estimează că o analiză umană comparabilă, făcută „câte o perturbare pe rând”, ar dura de la luni până la un an. În plus, testele interne au comparat un singur agent care primește întregul volum de lucru cu varianta distribuită, păstrând modelul și resursele fixe: pe măsură ce sarcina a crescut, agentul unic a acoperit tot mai puțin din literatură, ajungând să citeze 11 referințe la cel mai mare volum, în timp ce agenții distribuiți au citat peste 700 de referințe. În evaluări „în orb” (fără ca evaluatorii să știe ce variantă analizează), experții umani au preferat rapoartele generate de agenții distribuiți în 75% din cazuri. Potrivit descrierii, agenții au reprodus concluzii din analize umane și au identificat și piste suplimentare, iar evaluările lor privind noutatea și valoarea științifică au fost aliniate cu judecăți ale experților umani. Exemple de piste biologice identificate Materialul oferă câteva exemple de conexiuni pe care agenții le-au scos în evidență și care ar putea ghida experimente ulterioare: diferențe neașteptate între Tsc1 și Tsc2 (gene care controlează mTOR) în cerebel: perturbarea Tsc2 a modificat activitatea a zeci de gene implicate în comunicarea neuronală, în timp ce perturbarea Tsc1 a produs schimbări minime în aceeași zonă; o ipoteză legată de DCTN1 (genă asociată cu sindromul Perry, boală neurodegenerativă cu simptome asemănătoare Parkinson): perturbarea Dctn1 a crescut expresia genelor implicate în sinteza colesterolului, iar agenții au conectat observația cu cercetări care sugerează că problemele de transport al colesterolului pot determina celulele să producă mai mult colesterol. Ipoteza de testat: dacă perturbarea DCTN1 schimbă distribuția colesterolului în neuroni și dacă asta contribuie la neurodegenerare. Ce urmează: acces la rezultate și limitări implicite OpenAI notează că „atlasul de raționament” este disponibil public, astfel încât cercetătorii pot compara gene înrudite, investiga răspunsuri neașteptate și selecta piste promițătoare pentru experimente. În același timp, concluziile prezentate sunt formulate ca direcții de cercetare și ipoteze care necesită validare în laborator, nu ca rezultate clinice. [...]
OpenAI își extinde modelul de monetizare prin reclame, ducând ChatGPT Ads la 89 de țări și consolidând o sursă de venit menită să susțină accesul gratuit sau cu cost redus la serviciu, potrivit OpenAI . Compania spune că, la puțin peste opt luni de la lansare, peste 100.000 de agenți de publicitate au rulat campanii pe platformă, în condițiile în care ChatGPT este folosit săptămânal de peste 1,2 miliarde de persoane. Extinderea vizează 26 de țări noi și se bazează pe lansări recente în Europa și în Asia de Sud-Est și Taiwan. OpenAI precizează că reclamele vor fi afișate doar în planurile Free și Go, în timp ce abonamentele Plus, Pro și Enterprise rămân fără reclame. Unde se extinde și cum pot intra advertiserii După lansările din Mexic și Brazilia, OpenAI aduce ChatGPT Ads în încă 14 țări din America Latină, menționând explicit Argentina, Chile, Columbia și Peru. În paralel, compania intră și în piețe din Europa, Orientul Mijlociu, Africa și Asia, inclusiv Nigeria, Africa de Sud, Serbia, Ucraina, Cambodgia, Bangladesh și Pakistan. Accesul la ChatGPT Ads se face fie prin parteneri tehnologici, fie prin opțiunea de autoservire din Ads Manager . Ce promite OpenAI despre date și separarea reclamelor de răspunsuri OpenAI afirmă că abordarea sa este ghidată de „principiile pentru publicitate” și că păstrează conversațiile private față de agenții de publicitate, fără să vândă datele clienților. Reclamele sunt etichetate și separate de răspunsurile ChatGPT, iar publicitatea „nu influențează” răspunsurile oferite de model, conform principiilor detaliate de companie în materialul dedicat: ads principles . Ce urmează: formate noi și măsurare mai avansată Cu ChatGPT Ads disponibil în 89 de țări, următoarea etapă de creștere vizează dezvoltarea de formate suplimentare, obiective, opțiuni de cumpărare și capabilități de măsurare. OpenAI mai spune că explorează și modalități „mai native” prin care companiile să interacționeze cu consumatorii în ChatGPT. [...]
Inteligența artificială ar putea împinge PIB-ul SUA la 44.000 de miliarde de dolari până în 2030 , potrivit unui model economic intern al Anthropic , relatează news.ro . Estimarea ar însemna o creștere de la „puțin peste 30.000 de miliarde de dolari” în prezent, pe fondul accelerării capacităților AI. Declarațiile au fost făcute de Jack Clark , cofondator al Anthropic, sâmbătă, la reuniunile anuale ale Fondului Monetar Internațional și Băncii Mondiale, organizate la Bangkok. Clark a spus că îmbunătățirea rapidă a AI va accelera schimbările „în toate domeniile de activitate”. „Știu că pare foarte puțin plauzibil, dar aceasta este una dintre implicațiile faptului că tehnologia continuă să se îmbunătățească.” Ce ar presupune, economic, un astfel de scenariu Potrivit lui Clark, o expansiune de această magnitudine ar implica apariția unor industrii și invenții noi, care să susțină o creștere puternică a producției economice americane. El a argumentat, totodată, că AI contribuie deja la accelerarea semnificativă a descoperirilor științifice. Miza pentru companii și autorități: reguli mai stricte În același timp, cofondatorul Anthropic a avertizat că amploarea transformărilor generate de AI impune o cooperare internațională mai strânsă pentru stabilirea unor reguli de reglementare „neobişnuit de stricte şi serioase”, adaptate impactului tehnologiei. Estimarea privind PIB-ul este prezentată ca rezultat al unui model intern al companiei și este tratată chiar de autorul ei ca fiind, cel puțin la prima vedere, dificil de crezut; materialul nu oferă detalii despre metodologia modelului sau despre ipotezele folosite. [...]