Știri
Tag: latenta redusa

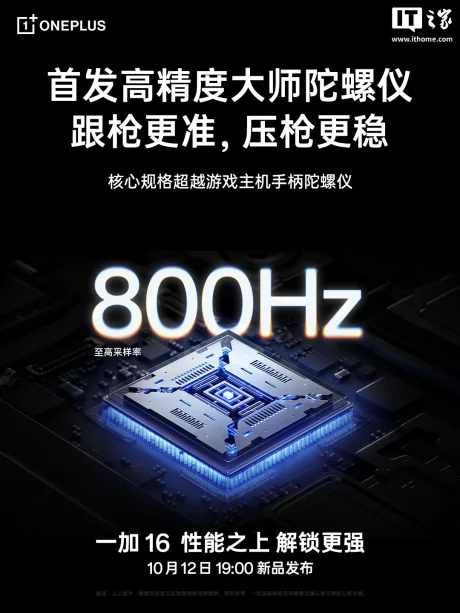
OnePlus 16 mizează pe jocuri pe mobil cu un giroscop de până la 800 Hz și hardware dedicat pentru latență redusă , potrivit iThome , care notează că telefonul va debuta cu un „giroscop de mare precizie pentru profesioniști”, cu specificații pe care compania le compară favorabil cu cele ale controlerelor de console. Producătorul susține că noul giroscop, cu rată de eșantionare de până la 800 Hz, ar îmbunătăți reacția și precizia în jocuri (de tip „trăgaci mai rapid”, „urmărire mai precisă”, „control mai stabil”), iar „specificațiile de bază” ar depăși giroscoapele din gamepad-urile pentru console, conform afirmațiilor din anunțul oficial citat de publicație. Consecința practică: reducerea întârzierilor și a variațiilor de rețea în jocuri Pe lângă componenta de senzori, OnePlus 16 ar urma să fie lansat și cu elemente orientate explicit spre conectivitate în gaming. Președintele OnePlus China, Li Jie , a declarat că modelul va introduce: un cip de rețea pentru e-sports „G3”, dezvoltat intern, proiectat pentru latență redusă în jocuri; o „antenă anti-interferențe” pentru gaming, menită să evite fluctuațiile de semnal chiar și când utilizatorul acoperă zona antenei cu mâna; un design de antene „360°”, gândit pentru scenarii aglomerate (cămin, cafenea, metrou), unde rețelele sunt mai congestionate. Lansare și configurații vehiculate Conform planificării menționate, OnePlus 16 urmează să fie prezentat pe 12 octombrie, la ora 19:00 (ora Chinei), adică 14:00 în România. Publicația enumeră și o listă de specificații „deja expuse” (neconfirmate integral în același anunț), între care: ecran de 6,78 inci 1.5K cu rată de refresh până la 185 Hz, cameră frontală de 50 MP, sistem foto cu senzor principal de 200 MP, procesor Snapdragon 8EE6, baterie de 9.000 mAh cu încărcare pe fir de 100 W și wireless de 50 W, certificări IP66/IP68/IP69/IP69K și USB 3.2 Gen1. [...]

OpenAI mută competiția spre „latență” : potrivit The Next Web , compania a prezentat „Ultrafast”, un nou nivel (tier) al API-ului care rulează modelul GPT-5.6 Sol de până la 14 ori mai rapid, ajungând la circa 750 de tokeni generați pe secundă, pe hardware furnizat de Cerebras . Miza este operațională: pentru aplicațiile în timp real, viteza începe să conteze la fel de mult ca „inteligența” modelului. Ultrafast nu este un model nou, ci o modalitate diferită de a servi un model existent. OpenAI a deschis pe 13 august o previzualizare limitată pentru un grup restrâns de clienți și spune că va extinde accesul pe măsură ce are capacitate disponibilă. De ce contează: agenții AI și aplicațiile „în timp real” nu mai pot aștepta Publicația notează că, până acum, utilizatorii care aveau nevoie de răspunsuri cu adevărat rapide erau nevoiți să coboare la modele mai mici și mai puțin capabile, acceptând un compromis între viteză și performanță. Ultrafast își propune să elimine această alegere: „raționament” la nivel de vârf și răspuns aproape instant în același pachet. Impactul este cel mai vizibil în software-ul „agentic” (aplicații în care AI execută pași succesivi, ca un „agent”): un agent care „gândește” zeci de secunde la fiecare pas rămâne o demonstrație, în timp ce unul care răspunde la ritmul unei conversații începe să semene cu un produs utilizabil. OpenAI țintește explicit activități sensibile la timp, inclusiv: răspuns la incidente și depanare (debugging); cercetare financiară și detecția fraudei; suport clienți în timp real și voce; comerț electronic. De ce Cerebras: cipuri „cât o farfurie” și mai puțin trafic intern Viteza ar veni din arhitectura Cerebras: procesoare de dimensiunea unei farfurii, tăiate dintr-un singur wafer de siliciu, astfel încât un model poate rula pe un singur cip, în loc să fie împărțit pe rack-uri de GPU-uri Nvidia care trebuie să transfere constant date între ele. Reducerea acestui „trafic intern” ar diminua întârzierea dintre prompt și răspuns. În logica Cerebras, designul ar fi mai potrivit pentru inferență (rularea modelului pentru a produce răspunsuri) decât cipurile generaliste optimizate în primul rând pentru antrenare. Efecte în piață: validare pentru Cerebras și un pas al OpenAI departe de Nvidia Pentru Cerebras, parteneriatul este o validare importantă într-un moment favorabil, după listarea la bursă, dar și pe fondul dificultății de a convinge piața că ambiția „wafer-scale” se traduce în profit sustenabil, potrivit aceleiași surse. Pentru OpenAI, folosirea Cerebras este și un pas discret de reducere a dependenței totale de Nvidia, în linie cu eforturile companiei de a lucra la propriul siliciu personalizat. Ce urmează: previzualizare limitată, preț nepublicat OpenAI nu a publicat prețurile pentru Ultrafast. The Next Web notează că rularea celui mai puternic model la o viteză de 14 ori mai mare pe hardware specializat este puțin probabil să fie ieftină, astfel că Ultrafast ar putea rămâne o opțiune premium pentru cazuri în care latența este critică, nu un mod implicit. Deocamdată, accesul este limitat la câțiva clienți, în timp ce OpenAI caută capacitate. Mesajul strategic, însă, este limpede: în următoarea etapă a competiției în AI, performanța brută nu mai este suficientă dacă modelul rămâne lent. [...]